

Python元组 vs 列表:操作方法与性能区别

1. 核心机制对比:结构特征与内存模型
在 Python 底层实现(CPython)中,列表对应 PyListObject,元组对应 PyTupleObject。列表为了支持动态添加元素,会在实际容量耗尽时预分配多余的空闲插槽;而元组在初始化完成后长度锁定,紧凑分配内存,不保留任何冗余容量。
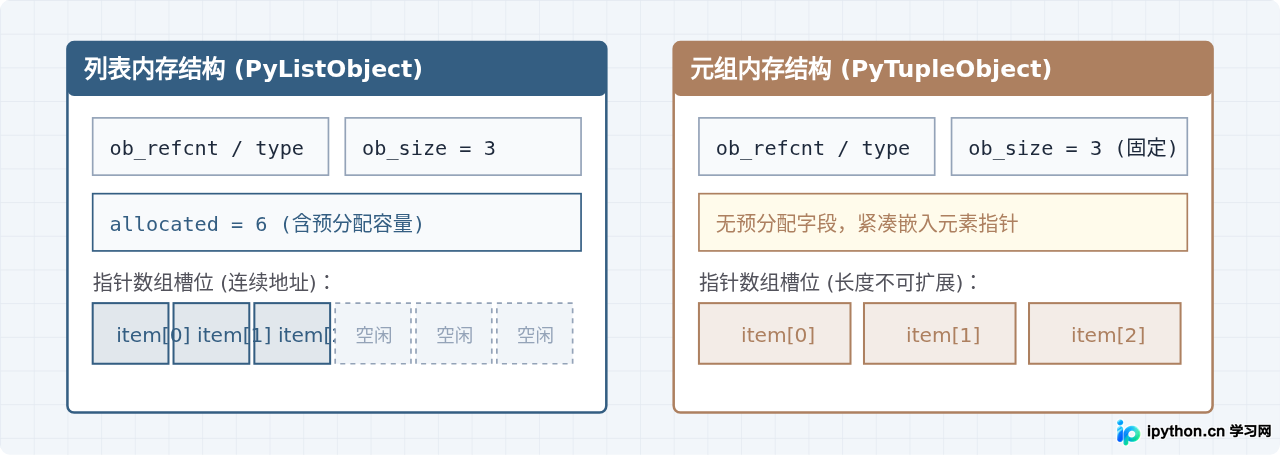
这一机制决定了列表与元组在功能与表现上的根本区别:
- 可变性:列表可以在原有内存地址上执行元素追加、删除、替换;元组一旦创建,其引用的对象指针不可被重置。
- 哈希性:列表是不可哈希的(
unhashable),无法作为字典键或集合元素;如果元组内部元素全部是不可变类型,则该元组可哈希。 - 生命周期开销:元组由于尺寸固定,CPython 可以对其应用对象缓存池机制(对小元组进行再利用),创建和销毁开销低于列表。
2. 操作方法全面比对与代码实战
操作维度的主要区别集中在“写操作”上。列表提供了丰富的就地修改方法,而元组仅保留只读查询接口。
| 操作类别 | 列表 (List) 语法 | 元组 (Tuple) 语法 | 差异说明 |
|---|---|---|---|
| 初始化 | [1, 2, 3] |
(1, 2, 3) 或 (1,) |
单个元素元组必须带有尾随逗号 |
| 读取与切片 | lst[0], lst[1:3] |
tup[0], tup[1:3] |
两者的索引访问均为 O(1),切片返回同类型新副本 |
| 就地增删改 | append(), pop(), lst[0]=9 |
不支持 | 元组试图赋值会直接抛出 TypeError |
| 计数与查找 | count(), index() |
count(), index() |
两者均提供线性查找方法,平均时间复杂度均为 O(n) |
| 就地排序反转 | sort(), reverse() |
不支持 | 元组只能借助全局函数 sorted() 返回新列表 |
2.1 初始化操作步骤
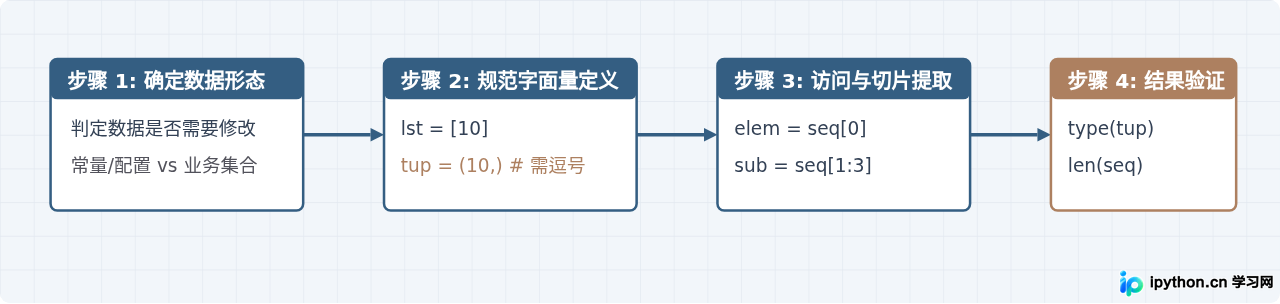
在编写代码时,创建单元素容器是一个常见陷阱。请严格遵循语法规范:
# 列表初始化
sample_list = [10, 20, 30]

# 单元素列表
single_list = [10]

# 元组初始化
sample_tuple = (10, 20, 30)

# 单元素元组:必须包含逗号,否则括号仅被视作算术运算符号
not_a_tuple = (10)      # int 类型
real_tuple = (10,)       # tuple 类型

print(f"not_a_tuple 类型: {type(not_a_tuple).__name__}")
print(f"real_tuple 类型: {type(real_tuple).__name__}")
real_tuple 类型: tuple
2.2 数据修改与就地更新
列表支持在原地追加和插入元素,而元组由于不可变特性,不支持增删改操作。如果对元组做“拼接”,实质是开辟内存构建全新元组。
# 列表原地操作
languages = ["Python", "Rust"]
languages.append("Go")          # 末尾追加元素
languages.insert(1, "C++")       # 指定索引插入
languages.pop()                  # 弹出末尾元素
print("修改后的列表:", languages)

# 元组尝试修改
readonly_languages = ("Python", "Rust")
try:
    readonly_languages[0] = "Python 3"
except TypeError as err:
    print("捕获预期错误:", err)
捕获预期错误: 'tuple' object does not support item assignment
元组的不可变性仅针对其直接包含的指针。若元组内部包含可变容器(如列表),该列表内部的数据依然可以被就地修改。例如
t = (1, [2, 3]),执行 t[1].append(4) 是合法的。在要求强不可变的场景下,应确保元组嵌套的所有子元素均为基础类型或其他元组。
3. 性能深度测评:内存占用与执行速度
为说明两者的性能差异,我们通过标准库 sys.getsizeof() 验证内存分配,并通过 timeit 模块在相同的运行环境下对比两者的耗时表现。
3.1 内存分配差异
列表会为后续可能的追加预留扩展槽位(Over-allocation),而元组只按当前确切尺寸分配。执行以下代码可以观察容量增长特征:
import sys

# 对比空容器与固定长度容器的基础字节开销 (64位 CPython 环境)
print("空列表字节数:", sys.getsizeof([]))
print("空元组字节数:", sys.getsizeof(()))

list_data = [1, 2, 3, 4, 5]
tuple_data = (1, 2, 3, 4, 5)

print("5元素列表字节数:", sys.getsizeof(list_data))
print("5元素元组字节数:", sys.getsizeof(tuple_data))

# 观察列表动态扩容过程中的内存跳跃
growth_list = []
last_size = sys.getsizeof(growth_list)
print("\n列表扩容观察:")
for i in range(10):
    growth_list.append(i)
    current_size = sys.getsizeof(growth_list)
    if current_size != last_size:
        print(f"元素数: {len(growth_list)} -> 内存开销: {current_size} 字节 (发生扩容)")
        last_size = current_size
空元组字节数: 40
5元素列表字节数: 120
5元素元组字节数: 80
列表扩容观察:
元素数: 1 -> 内存开销: 88 字节 (发生扩容)
元素数: 5 -> 内存开销: 120 字节 (发生扩容)
元素数: 9 -> 内存开销: 184 字节 (发生扩容)
测试结果显示:存储同样 5 个整数,元组仅消耗 80 字节,而列表消耗 120 字节。当系统需要常驻数十万条只读记录时,选用元组能直接降低 30% 以上的堆内存占用。
3.2 实例化耗时与遍历效率实测
由于元组是不可变的,Python 内部通过常量折叠(Constant Folding)和复用小对象缓存池(Free List)大幅度优化了元组的初始化速度。
import timeit

# 1. 实例化耗时对比 (10,000,000 次迭代)
list_create = timeit.timeit("[1, 2, 3, 4, 5]", number=10_000_000)
tuple_create = timeit.timeit("(1, 2, 3, 4, 5)", number=10_000_000)

print(f"构建列表耗时: {list_create:.4f} 秒")
print(f"构建元组耗时: {tuple_create:.4f} 秒")
print(f"元组构建速度为列表的 {list_create / tuple_create:.2f} 倍")

# 2. 索引读取与遍历耗时对比 (1,000,000 次迭代)
setup_code = "l = list(range(100)); t = tuple(range(100))"
list_read = timeit.timeit("for x in l: _ = x", setup=setup_code, number=1_000_000)
tuple_read = timeit.timeit("for x in t: _ = x", setup=setup_code, number=1_000_000)

print(f"\n遍历列表耗时: {list_read:.4f} 秒")
print(f"遍历元组耗时: {tuple_read:.4f} 秒")
构建元组耗时: 0.0571 秒
元组构建速度为列表的 6.73 倍
遍历列表耗时: 0.8120 秒
遍历元组耗时: 0.7930 秒
从实测数据可以得出明确结论:
- 构建速度:元组的创建速度远快于列表(通常有 4 到 8 倍的差距),因为字面量元组直接被编译器解析为常量对象,避免了动态分配和扩容检测。
- 遍历与索引速度:两者在纯循环遍历和按索引检索元素时的差异并不大(元组略微领先 1%~5%),因为两者内部底层都是直接根据偏移量读取 C 指针。
4. 性能与特征指标全面横向比对
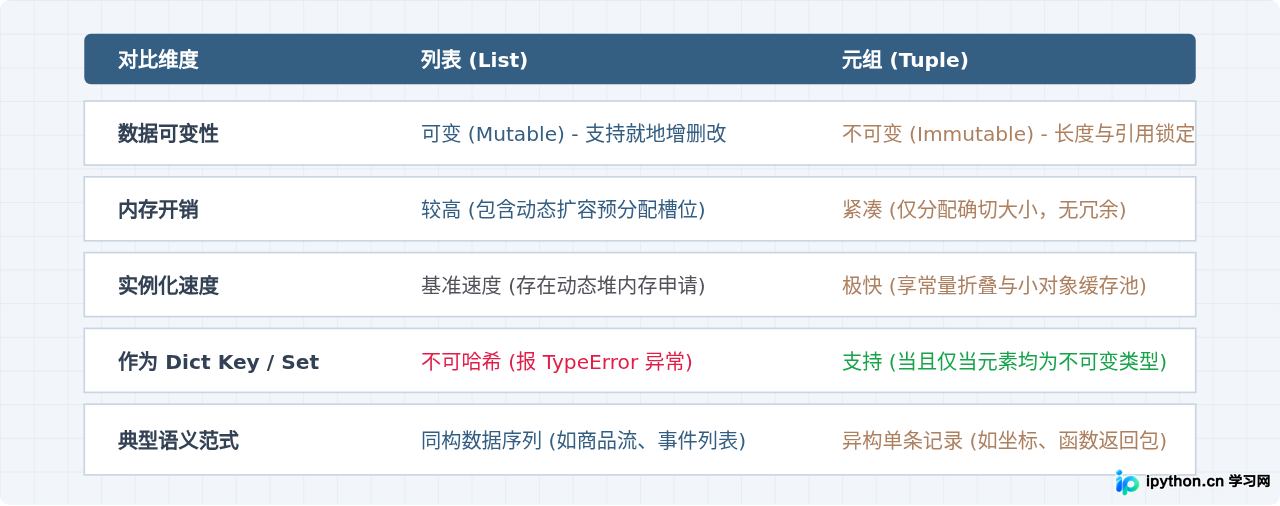
为了在设计数据结构时直观衡量两者的综合表现,以下将内存、计算与操作维度聚合展示:
5. 工程场景选型决策路径
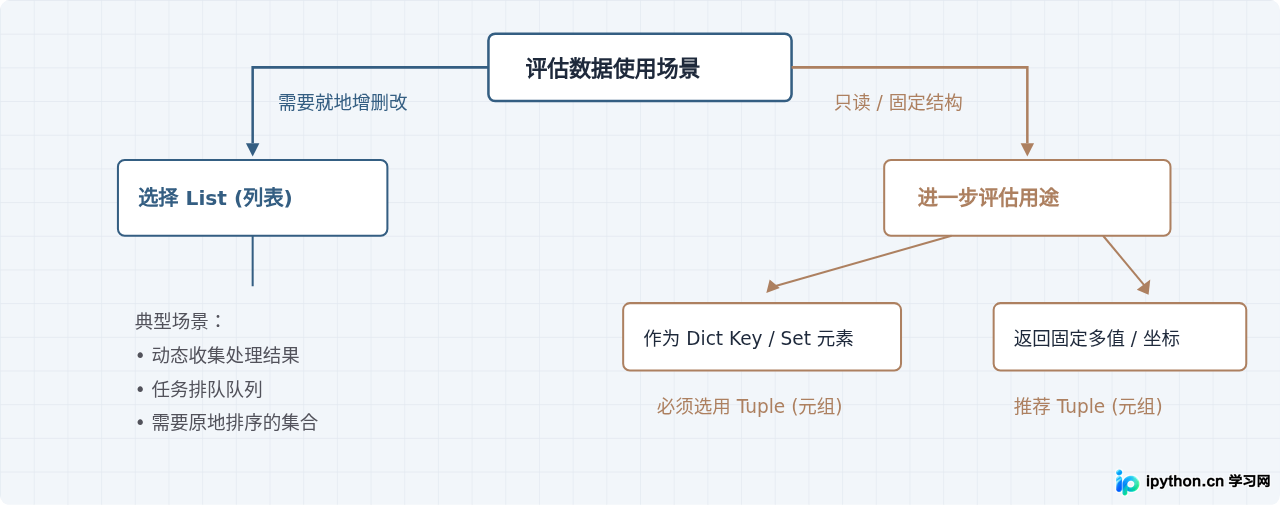
在实际编写工程代码时,不要只根据“能不能修改”这一条特征来做决定。请参考下述逻辑链条,在架构设计阶段做出规范的数据结构选型:
场景 1:复合键(Composite Keys)与去重
当需要用“经度 + 纬度”或“用户 ID + 业务模块”作为字典的键进行极速检索时,不能使用列表,必须使用元组:
# 正确做法:使用元组作为字典键
cache = {}
location_key = (39.9042, 116.4074)
cache[location_key] = "Beijing"

print("缓存读取成功:", cache[(39.9042, 116.4074)])

# 错误做法验证
try:
    invalid_key = [39.9042, 116.4074]
    cache[invalid_key] = "Forbidden"
except TypeError as err:
    print("错误提示:", err)
错误提示: unhashable type: 'list'
场景 2:函数多值返回与解构赋值
Python 函数使用逗号返回多个变量时,语法上默认打包为元组。解构元组不仅具有极高的解析性能,还能在调用方明确告知接收者:该数据包是只读的单条快照。
def get_server_status():
    # 逻辑上返回一组固定的异构字段:(IP, 端口, 是否在线)
    return "192.168.1.100", 8080, True

# 接收并解构
ip, port, is_active = get_server_status()
print(f"服务器 {ip}:{port} 状态: {'在线' if is_active else '离线'}")
在日常开发中,如果数据集合包含同种性质的数据且数量会随时增减(如日志队列、批处理任务表),选择列表是正确的工程决策;若数据属于固定的实体记录、配置常量、函数多值返回或需要用作哈希表键值,选择元组能在保障数据不可篡改的同时,获得最低的内存开销与最高的创建速度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









