

Python新手必学的核心语法:变量、循环与函数详解
深入详解Python初学者必须掌握的三大核心语法:变量引用机制、循环控制流以及函数封装与作用域,帮助新手建立清晰严谨的编程认知体系。
学习 Python 编程的核心关键,在于掌握程序如何存储数据状态、如何重复处理批量数据,以及如何将具体业务操作组织为可复用的功能模块。本文直接针对初学者必备的三大核心语法——变量、循环与函数展开深度剖析,通过底层引用机制、控制流跳转原理与作用域规则,帮助读者建立严谨清晰的 Python 编程认知,彻底规避初学阶段最容易陷入的代码误区。
一、变量的本质:标签绑定与内存对象引用
许多初学者接触编程时,习惯将变量类比为“一个装数据的盒子”,认为定义 x = 10 就是把数字 10 放入了名为 x 的盒子里。在 C 或 Java 等静态类型语言中,这种理解尚有一定物理意义,但在 Python 中,这种“盒子模型”会直接阻碍对深层行为的理解。
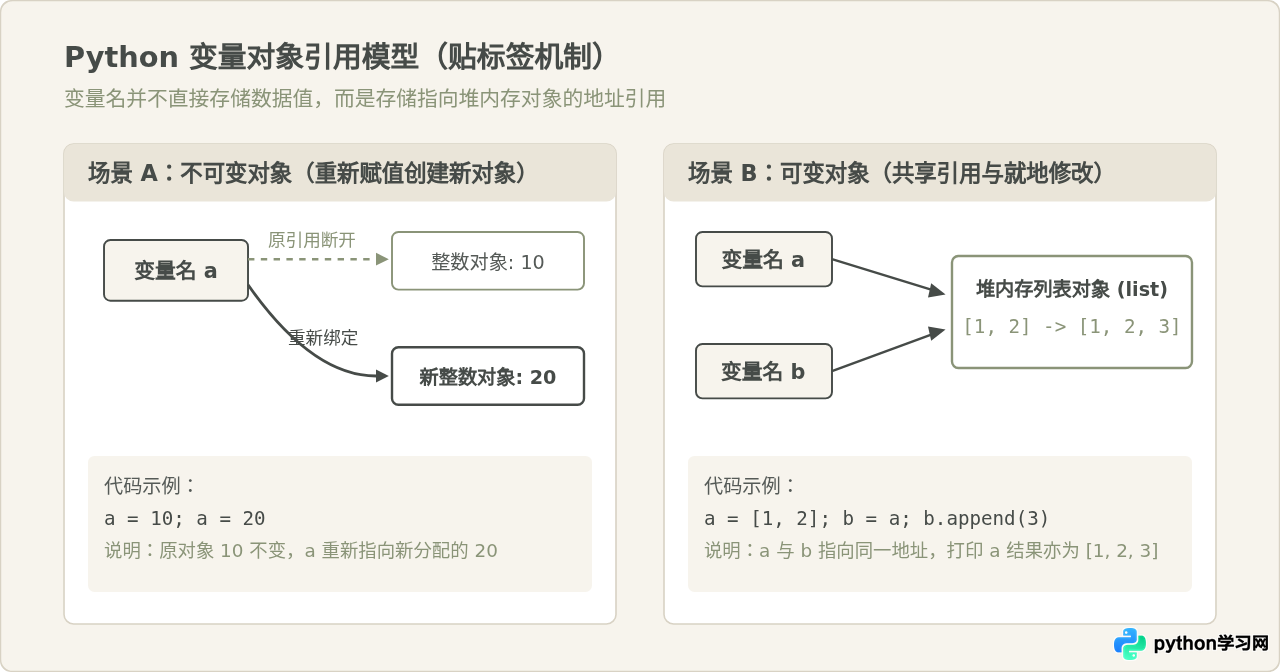
在 Python 中,变量不是容器,而是一张贴在对象上的“便签纸”(即引用指针)。当执行赋值语句时,Python 解释器先在堆内存中开辟空间创建对应的对象(包含类型、值与引用计数),然后将等号左侧的变量名绑定到该对象的内存地址上。
1.1 不可变对象 vs 可变对象的赋值差异
理解 Python 对象引用的核心分水岭,在于区分“不可变对象”(如 int、str、float、tuple)与“可变对象”(如 list、dict、set):
- 不可变对象:对象创建后,其在内存中的值不可改变。如果对变量重新赋值(例如
a = 10之后a = 20),并非修改了内存中原有的数字 10,而是解释器创建了全新的整数对象 20,并将标签a撕下,贴到了新对象 20 上。 - 可变对象:对象所占据的内存内容支持原地(in-place)修改。如果多个变量绑定了同一个可变对象,通过任何一个变量修改内部元素,其他变量均会同步感知。
1.2 混淆辨析:为什么 b = a 没有复制一份新列表?
在初学者常犯的错误中,最典型的便是认为 b = a 会拷贝出一个独立的数据副本。观察以下代码:
# 示例代码:变量别名与对象修改
list_a = [10, 20]
list_b = list_a
list_b.append(30)

print("list_a 内容:", list_a)  # 示例输出: list_a 内容: [10, 20, 30]
print("list_b 内容:", list_b)  # 示例输出: list_b 内容: [10, 20, 30]
print("两者是否同一对象:", list_a is list_b)  # 示例输出: 两者是否同一对象: True
list_b = list_a 并没有复制底层数组,而仅仅是给原列表对象增加了第二个引用标签。如果你确实需要一份独立的数据副本,应该使用切片操作 list_b = list_a[:] 或内置方法 list_b = list_a.copy()(浅拷贝);若列表中还嵌套了子列表,则需使用 copy.deepcopy() 进行深拷贝。
二、循环结构:从序列迭代到精确控制流
掌握数据存储后,程序的核心任务就是批量处理数据。Python 提供了 for 循环与 while 循环两种控制流。
2.1 for ... in:基于迭代器协议的遍历
与其他语言中基于计数器(如 for (int i=0; i<n; i++))不同,Python 的 for 循环本质上是基于迭代器协议的容器遍历。这意味着它可以直接作用于列表、元组、字符串、字典乃至生成器,无需手动维护下标索引:
fruits = ["苹果", "香蕉", "橙子"]

# 直接遍历元素值
for fruit in fruits:
    print("当前水果:", fruit)

# 如果确实需要索引,规范做法是使用 enumerate()
for index, fruit in enumerate(fruits, start=1):
    print(f"第 {index} 个水果是: {fruit}")
2.2 while 循环:基于状态条件的循环边界
当循环次数不固定,而是依赖某个动态条件变化时,应当采用 while 循环。编写 while 循环的硬性要求是在循环体内必须存在改变判断条件的逻辑,否则将引发 CPU 占满的死循环:
# 模拟用户重试计数器
retry_count = 0
max_retries = 3

while retry_count < max_retries:
    retry_count += 1
    print(f"正在进行第 {retry_count} 次尝试...")
2.3 流程调控:break、continue 与鲜为人知的 for ... else
在循环执行过程中,我们常需根据条件中断或跳步:
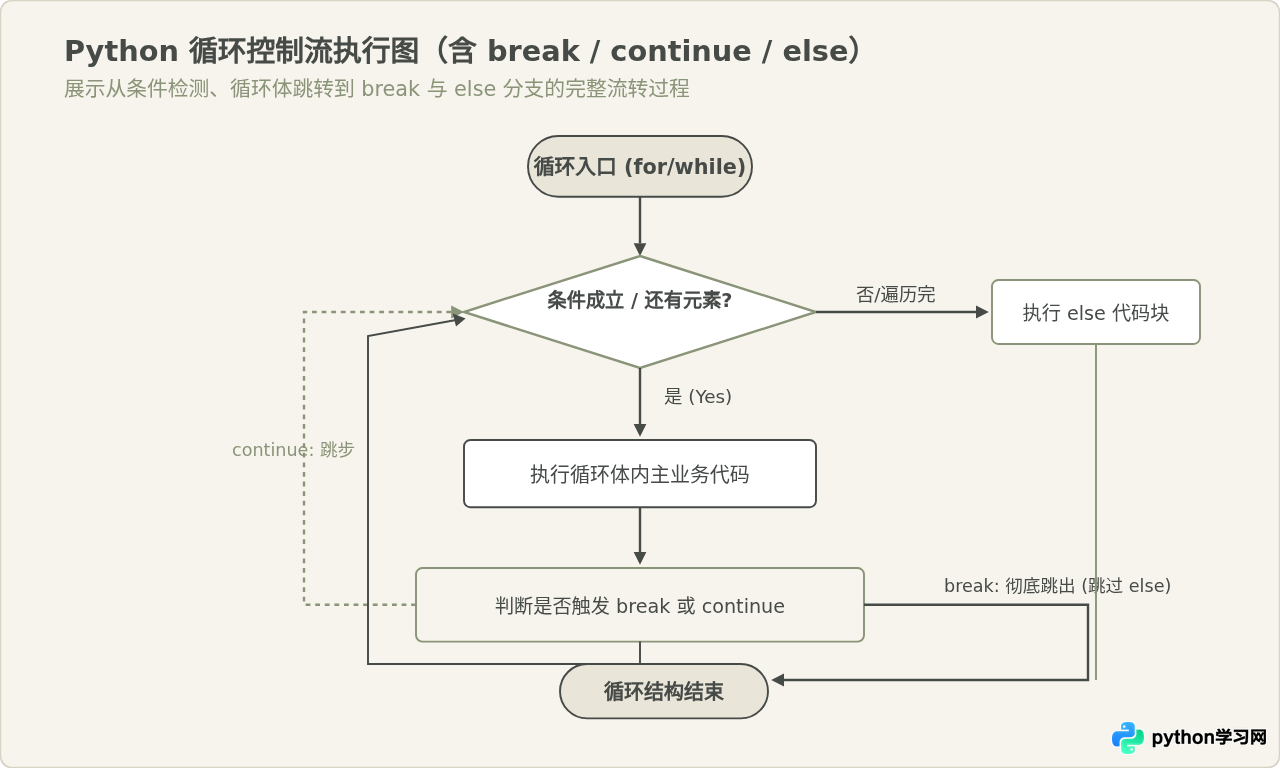
continue:立即终止本次循环剩余语句的执行,直接跳入下一次迭代判断。break:彻底跳出当前循环体,执行循环结构之后的代码。for ... else:如果循环正常执行完毕(没有遇到任何break),则执行else块。这一语法在“检索查找目标”的场景下极其优雅,免去了手动定义布尔查找标志位(found flag)的繁琐操作。
初学者常写出
for item in my_list: if cond: my_list.remove(item)。由于列表在底层是连续存储的内存数组,删除元素会导致后续所有元素向前平移,而 for 循环内部的指针是按索引递增的,这会导致紧邻被删元素的下一个元素被直接漏检。正确做法是使用列表推导式生成新列表:my_list = [item for item in my_list if not cond]。
三、函数封装:参数绑定、返回值与作用域规则
随着代码逻辑规模扩大,将重复出现的处理步骤封装为独立函数是唯一的工程化解法。函数具备明确的“三要素”:输入参数、内部运算逻辑、输出返回值。
3.1 参数机制与“默认参数陷阱”
Python 函数支持丰富的参数定义形式:位置参数、默认参数、可变位置参数(*args)和可变关键字参数(**kwargs)。
在设置默认参数时,存在一个极具隐蔽性的经典陷阱:默认参数的值是在函数定义(编译阶段)评估并创建的,而不是在函数每次被调用时创建。如果默认参数使用了可变对象(如空列表 [] 或空字典 {}),该对象将在所有调用之间被永久共享:
# 错误示例:默认参数使用了可变对象
def append_bad(val, target_list=[]):
    target_list.append(val)
    return target_list

print(append_bad(1))  # 示例输出: [1]
print(append_bad(2))  # 示例输出: [1, 2](并非预期的 [2]!旧对象被累加了)

# 正确规范:以 None 作为哨兵值
def append_good(val, target_list=None):
    if target_list is None:
        target_list = []  # 每次调用时动态创建全新独立列表
    target_list.append(val)
    return target_list

print(append_good(1))  # 示例输出: [1]
print(append_good(2))  # 示例输出: [2]
3.2 变量查找顺序:LEGB 作用域模型
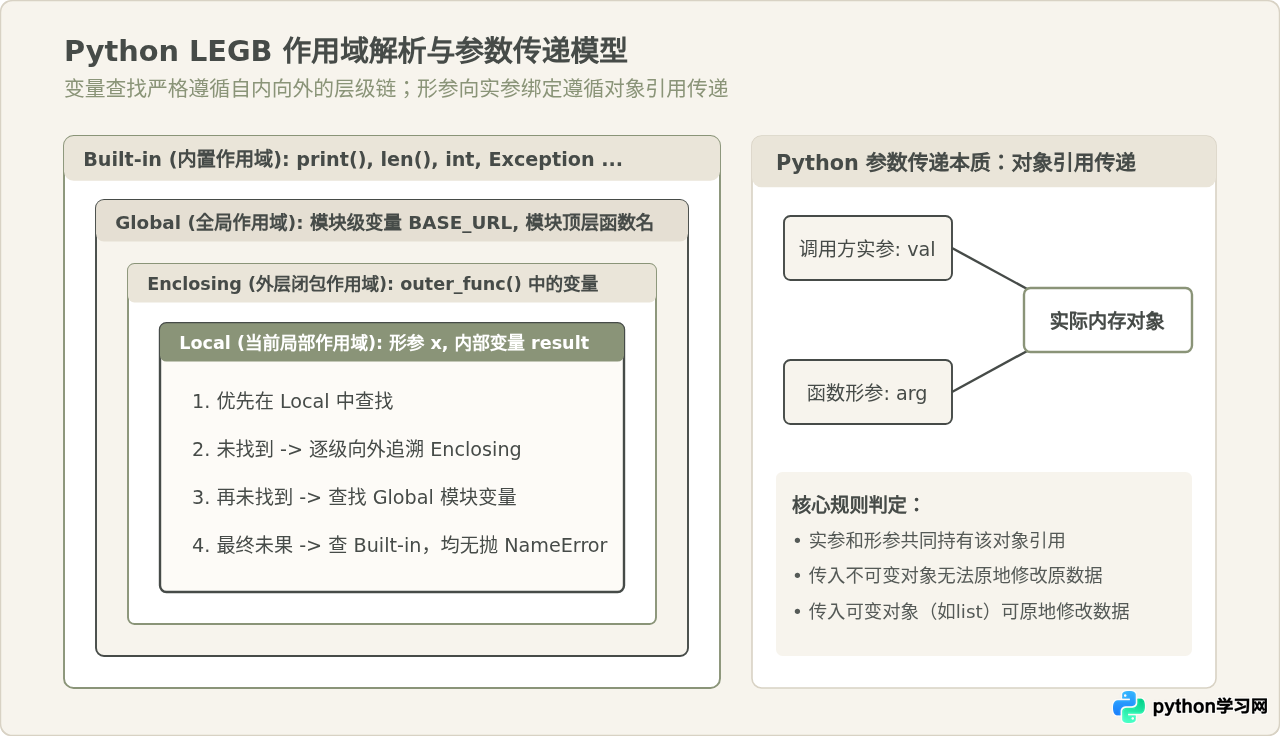
当函数内部使用一个变量名时,Python 解释器不会胡乱寻找,而是严格按照 LEGB 顺序 从内向外进行解析:
- L (Local):当前函数内部定义的局部变量与形参。
- E (Enclosing):嵌套结构中外层闭包函数的非全局命名空间。
- G (Global):当前
.py模块文件顶层定义的全局变量。 - B (Built-in):Python 解释器内建作用域,包含
len、print、range等内置标识符。
四、三者协同实战:数据清洗与统计计算
在实际开发中,变量、循环与函数并不是孤立存在的,而是高度协同运作的:
- 变量:承载业务实体的初始状态、累加中间结果以及最终输出映射;
- 循环:遍历外部输入集合,逐项进行验证、清洗与格式转换;
- 函数:将输入、清洗计算与返回封装为独立模块,隐藏实现细节,向外暴露清晰的调用接口。
4.1 综合示例:多源成绩数据清洗与合格率计算
以下示例展示了一个完整的实用函数:接收混合格式(包含有效数字、无效字符和越界数值)的学生成绩原始数据列表,通过循环与条件分支过滤非法数据,并在内部完成及格人数与平均分统计:
def process_exam_scores(raw_scores, pass_score=60):
    """
    清洗原始成绩列表并计算统计指标
    :param raw_scores: 包含成绩的原始列表(可能混有脏数据)
    :param pass_score: 及格阈值,默认值为 60
    :return: 包含清洗后成绩列表及统计结果的字典
    """
    valid_scores = []
    total_sum = 0
    pass_count = 0

    for item in raw_scores:
        # 1. 尝试转换为浮点数值
        try:
            score = float(item)
        except (ValueError, TypeError):
            # 无法解析为数值的脏数据直接跳过
            continue

        # 2. 检查有效数值区间 (0 ~ 100)
        if not (0 <= score <= 100):
            continue

        # 3. 记录有效数据并累加状态
        valid_scores.append(score)
        total_sum += score
        if score >= pass_score:
            pass_count += 1

    # 4. 边界处理:防止原始数据全为空导致除以零异常
    valid_count = len(valid_scores)
    if valid_count == 0:
        return {
            "valid_count": 0,
            "average_score": 0.0,
            "pass_rate": 0.0,
            "valid_scores": []
        }

    average = round(total_sum / valid_count, 2)
    pass_rate = round((pass_count / valid_count) * 100, 2)

    return {
        "valid_count": valid_count,
        "average_score": average,
        "pass_rate": pass_rate,
        "valid_scores": valid_scores
    }

# 调用执行与示例验证
test_data = ["85", 92, "无效文本", -5, 120, 58, 77.5, None]
result = process_exam_scores(test_data)

print("有效成绩数量:", result["valid_count"])     # 示例输出: 4
print("平均分:", result["average_score"])         # 示例输出: 78.12
print("及格率(%):", result["pass_rate"])          # 示例输出: 75.0
print("清洗后数据:", result["valid_scores"])       # 示例输出: [85.0, 92.0, 58.0, 77.5]
五、核心语法要点与全景总结
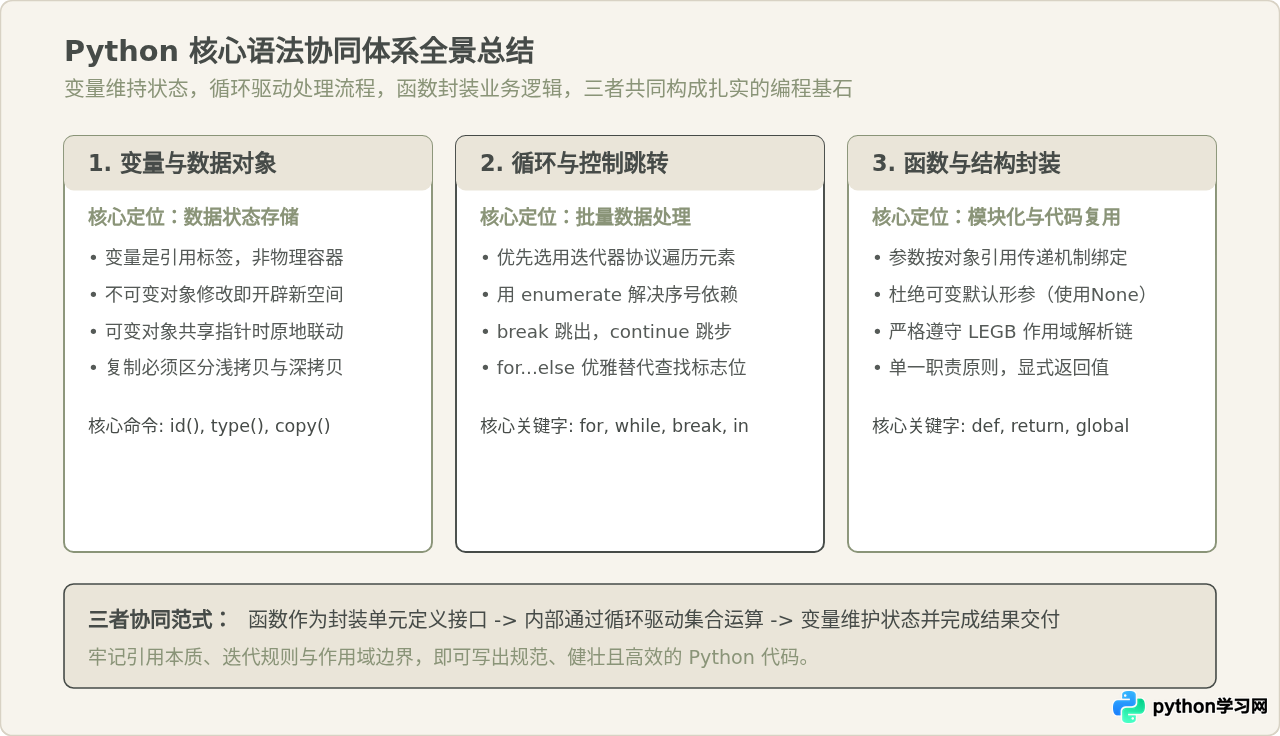
为了帮助读者更直观地把握这三者的关系,下表梳理了变量、循环与函数在核心设计逻辑与避坑要点上的对照关系:
| 语法维度 | 底层核心机制 | 典型设计与使用模式 | 常见认知误区 / 易错点 |
|---|---|---|---|
| 变量 (Variables) | 标签绑定与对象内存引用指针 | 见名知意命名、解包赋值、类型注解 | 混淆 is 与 ==;以为赋值会产生新内存拷贝 |
| 循环 (Loops) | 迭代器协议流转与控制跳转 | for ... in 迭代、列表推导式、enumerate() |
在遍历原列表时直接调用 remove() 导致漏检跳步 |
| 函数 (Functions) | LEGB 作用域解析与引用传递 | 单一职责原则、显式返回值、哨兵值默认参数 | 将默认形参设置为可变对象(如 lst=[])导致数据污染 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









