

Python解决汉诺塔RecursionError:递归深度限制与迭代优化
深入解析Python中汉诺塔经典算法触发RecursionError的核心成因,探讨sys.setrecursionlimit的适用边界,并提供显式栈模拟与二进制位运算两种高可用迭代优化方案。
在 Python 中实现经典汉诺塔(Tower of Hanoi)算法时,许多开发者在扩大测试规模或将逻辑迁移到受限环境时,常会遇到 RecursionError: maximum recursion depth exceeded while calling a Python object 报错。该报错并非代码逻辑本身出现死循环,而是触碰了 CPython 解释器预设的递归调用深度保护边界。解决该问题可分为两条路径:一是评估调用栈需求并临时微调解释器参数;二是通过显式模拟调用栈或数学规律直接实施迭代重构,将数据开销由系统栈迁移至堆内存。本文将针对报错本质进行剖析,并提供生产级可用的优化方案。
一、RecursionError 的成因与调用栈机制
经典的汉诺塔递归算法逻辑简洁直观。给定 $n$ 个盘子及三个柱子 $A$(起始柱)、$B$(辅助柱)、$C$(目标柱),其基本实现如下:
def hanoi_recursive(n, source, target, auxiliary):
    if n == 1:
        return [(source, target)]
    # 第一步:将前 n-1 个盘子从 source 移到 auxiliary
    moves = hanoi_recursive(n - 1, source, auxiliary, target)
    # 第二步:将第 n 个盘子从 source 移到 target
    moves.append((source, target))
    # 第三步:将 auxiliary 上的 n-1 个盘子移到 target
    moves.extend(hanoi_recursive(n - 1, auxiliary, target, source))
    return moves
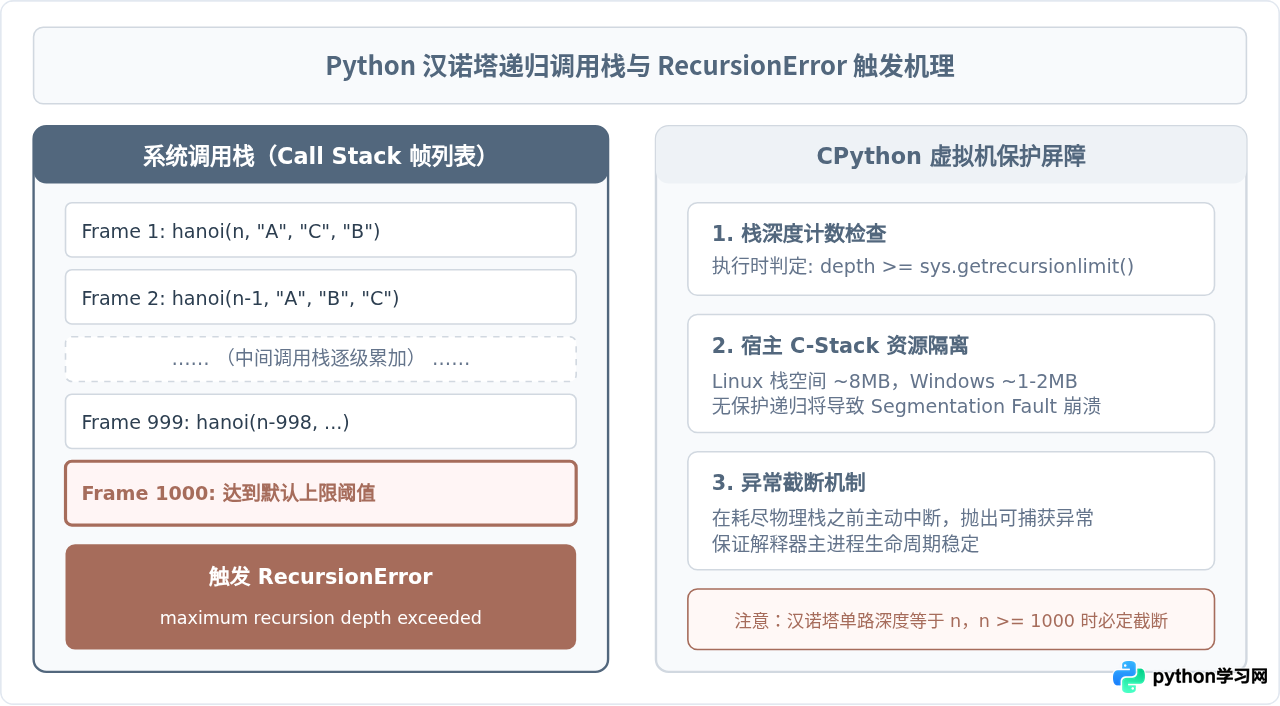
汉诺塔总移动步数为 $2^n - 1$。很多初学者常产生误解,认为移动次数呈指数级增长会导致递归深度也呈指数级暴增。事实上,递归调用栈的深度只取决于调用树的最大单支深度。在汉诺塔中,调用树的最大深度严格为 $n$(基线为 $n=1$)。然而,为什么在 Python 中依然容易抛出 RecursionError?
CPython 运行时在执行递归函数时,每一个 Python 函数调用都会在底层创建对应的 PyFrameObject,并消耗宿主系统的 C 语言调用栈(C-Stack)。操作系统为进程分配的栈空间非常有限(Linux 常见为 8MB,Windows 仅为 1MB 至 2MB)。若允许无限递归,一旦 C-Stack 耗尽,将触发不可恢复的内存段错误(Segmentation Fault),导致整个进程直接闪退。为了防御这种底层崩溃,Python 解释器在内部维护了一个深度计数器,当单条调用链深度达到阈值(默认为 1000)时,主动截断并抛出 RecursionError。
二、排查与临时调优:sys.setrecursionlimit 的使用边界与风险
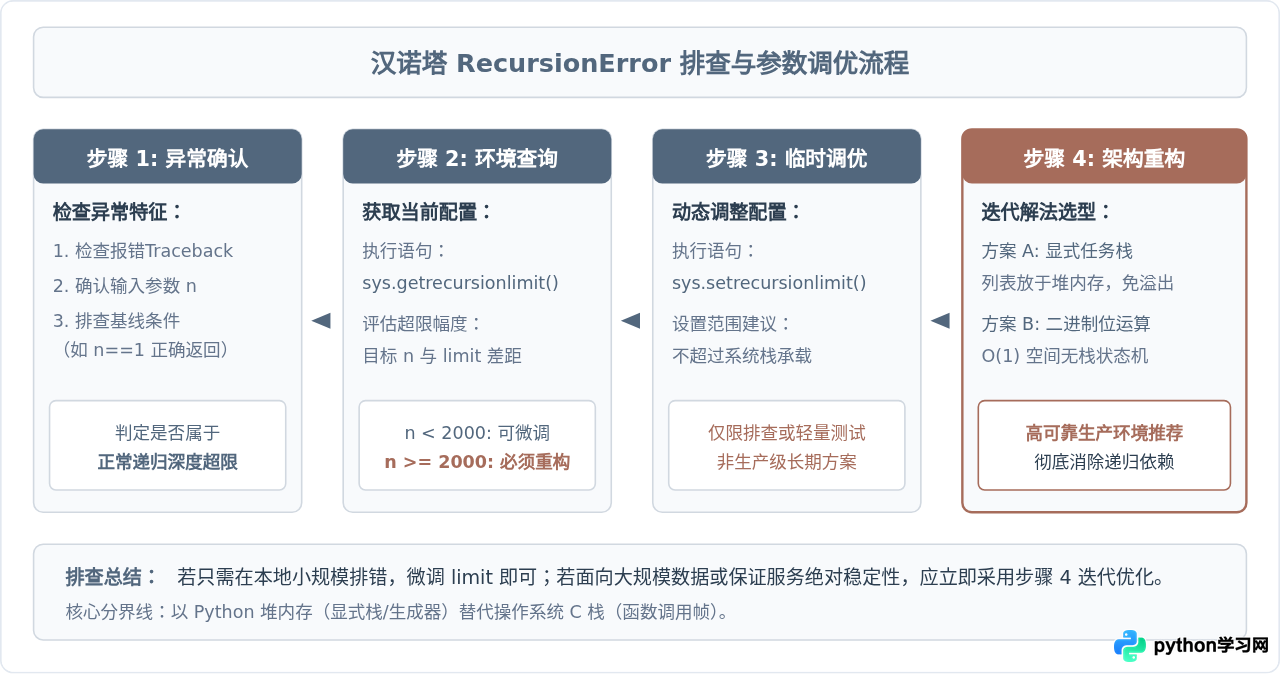
当遇到汉诺塔递归深度报错时,第一步应当准确排查当前的执行环境参数,判断是逻辑死循环还是常规的规模超限。
1. 查看当前限制与调用深度
import sys

# 获取解释器当前递归上限(默认通常为 1000)
current_limit = sys.getrecursionlimit()
print("当前递归深度上限:", current_limit)
2. 动态调整深度上限及适用边界
如果业务场景中盘子数量略高于默认限制(例如 $n = 1200$),可以通过 sys.setrecursionlimit() 函数进行微调:
import sys

# 将递归上限上调至 3000
sys.setrecursionlimit(3000)

# 验证汉诺塔调用
# 注意:尽管栈深度为 1200,但其理论步数为 2^1200 - 1,生成器按需迭代更稳妥修改递归深度仅是在 Python 层面调高了“安全警报阈值”,但并没有改变底层操作系统分配给 C 调用栈的物理内存容量。如果在 64 位系统上盲目将限制提高到 50,000 甚至更大,一旦递归函数局部变量较多,程序很可能在 Python 抛出异常前,直接因底层 C 栈溢出而发生不可挽回的闪退。因此,该设置仅适用于临时诊断或轻微溢出的过渡场景。
三、根本优化方案一:显式栈模拟递归(堆内存替代系统栈)
递归本质上由程序语言隐式管理调用栈。优化递归最直接、最具普适性的工程方法,是使用自定义的数据结构(如 Python 的 list)在堆内存(Heap)中显式管理任务。由于堆内存的大小受限于整机的物理内存,而非严格受限的操作系统 C-Stack,因此可以轻松容纳成千上万级状态而不引发任何 RecursionError。
1. 逆序压栈机制推导
在原本的递归中,执行流程为:
- 解决子问题 1:
hanoi(n-1, source, auxiliary, target) - 移动当前盘:将第 $n$ 个盘从
source移到target - 解决子问题 2:
hanoi(n-1, auxiliary, target, source)
由于栈具有“后进先出”(LIFO)的特性,当我们使用自定义显式栈时,若要使子问题 1 先出栈执行,必须按照相反的顺序向栈中压入任务:先压入子问题 2,再压入当前移动,最后压入子问题 1。
2. 显式栈与生成器实现代码
针对汉诺塔步骤庞大的特点,使用 Python 生成器(yield)逐步产生指令,不仅解除了递归深度限制,而且无需在内存中一次性分配海量列表:
def hanoi_iterative_stack(n, source="A", target="C", auxiliary="B"):
    """
    使用显式栈模拟汉诺塔递归过程
    将调用栈转移到 Python 堆内存,彻底规避 RecursionError
    """
    if n <= 0:
        return

    # 栈中元素为任务元组:(当前盘数, 起始柱, 目标柱, 辅助柱)
    # 当盘数等于 1 时,代表原子移动操作;大于 1 时代表需要展开的子问题
    stack = [(n, source, target, auxiliary)]

    while stack:
        count, src, tgt, aux = stack.pop()

        if count == 1:
            # 原子移动
            yield (src, tgt)
        else:
            # 逆序压入三个子任务:
            # 1. 后执行:hanoi(count - 1, aux, tgt, src)
            stack.append((count - 1, aux, tgt, src))
            # 2. 中执行:移动底盘
            stack.append((1, src, tgt, aux))
            # 3. 先执行:hanoi(count - 1, src, aux, tgt)
            stack.append((count - 1, src, aux, tgt))

# 使用示例
if __name__ == "__main__":
    # 即便测试深度达到 5000(远超默认的 1000),也不会触发 RecursionError
    generator = hanoi_iterative_stack(5000)
    # 获取前 5 次移动验证正确性
    for _ in range(5):
        print("移动指令:", next(generator))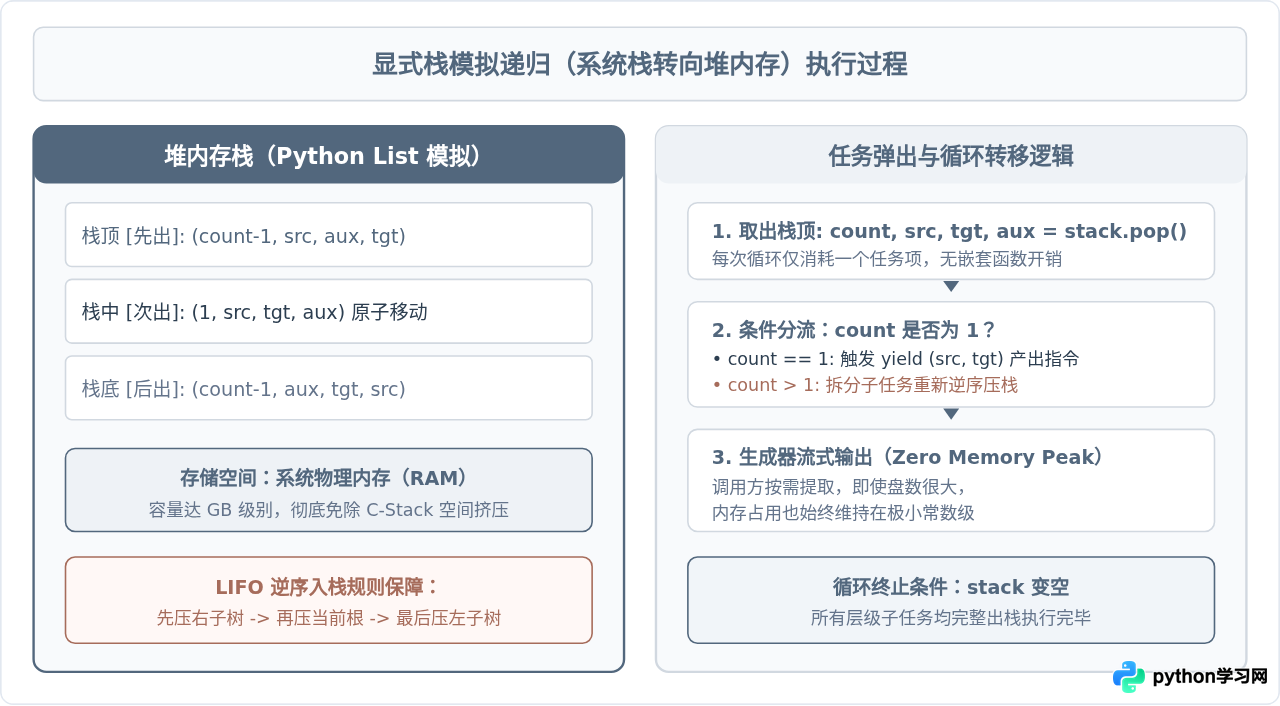
四、根本优化方案二:基于二进制位运算的无栈迭代算法
虽然显式栈成功突破了系统栈深度限制,但在极端场景下,栈列表中依然需要存储一定数量的状态元素。汉诺塔问题本身具备高度对称的数学特性,我们可以通过二进制位运算与周期规律,实现一个**完全不需要栈、额外空间复杂度为 $O(1)$** 的终极迭代解法。
1. 数学与位运算规律
- 总步数:$n$ 个盘子的总移动次数固定为 $2^n - 1$。如果记录当前步数序号 $k$($k = 1, 2, \dots, 2^n - 1$),则第 $k$ 步所移动的盘子编号,精确对应于 $k$ 在二进制下的最低非零位(Lowbit)权值:
(k & -k).bit_length()。例如:- 步数 1 (001b)、3 (011b)、5 (101b):移动 1 号盘(最小盘)。
- 步数 2 (010b)、6 (110b)、10 (1010b):移动 2 号盘。
- 步数 4 (100b)、12 (1100b):移动 3 号盘。
- 最小盘(1号盘)移动轨迹:1 号盘在每隔一步移动一次。若盘数 $n$ 为偶数,1 号盘的移动顺序始终是 $A \to B \to C \to A$;若 $n$ 为奇数,其移动顺序则是 $A \to C \to B \to A$。
- 其他盘的唯一合法性:在任意两次 1 号盘移动之间,其余两个柱子之间**有且仅有一种合法的移动方式**(即只能将较小的盘子压在大盘子上)。
2. 位运算迭代实现代码
def hanoi_binary_iterative(n, source="A", target="C", auxiliary="B"):
    """
    基于二进制最低非零位与周期性规律的无栈迭代法
    空间复杂度为严格的 O(1),无任何递归或显式栈开销
    """
    if n <= 0:
        return

    # 柱子映射与方向判定
    # 如果 n 为偶数,1号盘轮转顺序为 A -> B -> C;如果 n 为奇数,为 A -> C -> B
    pegs = [source, target, auxiliary] if n % 2 != 0 else [source, auxiliary, target]

    # 记录每个盘子当前所在的柱子索引(初始全在 source=0)
    disk_pos = [0] * (n + 1)

    total_moves = (1 << n) - 1

    for k in range(1, total_moves + 1):
        # 利用位运算提取最低非零位的序号 (1-indexed)
        # 1号盘在所有奇数步移动,2号盘在 2, 6, 10 移动,以此类推
        disk = (k & -k).bit_length()

        current_peg_idx = disk_pos[disk]

        if disk == 1:
            # 1 号盘按顺时针固定方向前进
            next_peg_idx = (current_peg_idx + 1) % 3
        else:
            # 非 1 号盘:在另外两根柱子中寻找合法落点
            # 另外两根柱子为 (current + 1)%3 和 (current + 2)%3
            # 根据汉诺塔规则,只能将该盘放到未被更小盘占领的位置
            next_peg_idx = (current_peg_idx + 1) % 3
            # 如果将要放置的位置已经有比当前盘更小的盘子,则只能放到第三根柱子
            for smaller_disk in range(1, disk):
                if disk_pos[smaller_disk] == next_peg_idx:
                    next_peg_idx = (current_peg_idx + 2) % 3
                    break

        disk_pos[disk] = next_peg_idx
        yield (pegs[current_peg_idx], pegs[next_peg_idx])

# 验证位运算生成器
if __name__ == "__main__":
    moves_gen = hanoi_binary_iterative(3)
    for move in moves_gen:
        print(f"移动盘子: {move[0]} -> {move[1]}")
五、方案选型与工程权衡
针对汉诺塔及类似分治递归问题中的 RecursionError,不同优化方案的对比与技术选型如下表所示:
| 解决方案 | 调用栈消耗 | 空间复杂度 | 代码侵入度 | 稳定性 / 风险 | 推荐使用场景 |
|---|---|---|---|---|---|
| 原生递归 + setrecursionlimit | 宿主 C 调用栈 | $O(n)$ 系统栈 | 仅改动一行环境配置 | 高(极易引发 C 栈溢出致进程段错误崩溃) | 临时单机测试、算法作业($n < 1500$) |
| 显式栈模拟(List 模拟栈) | Python 堆内存 | $O(n)$ 堆空间 | 中等(重构为循环及任务元组) | 极高(完全规避 RecursionError,受 RAM 保护) | 通用算法工程化、所有复杂树形递归重构 |
| 二进制规律迭代(Math) | 无任何栈结构 | $O(1)$ 辅助常数 | 高(需要数学规律与状态机推导) | 最高(零栈内存峰值,流式输出) | 超长流水线执行、硬件受限或嵌入式 Python 场景 |
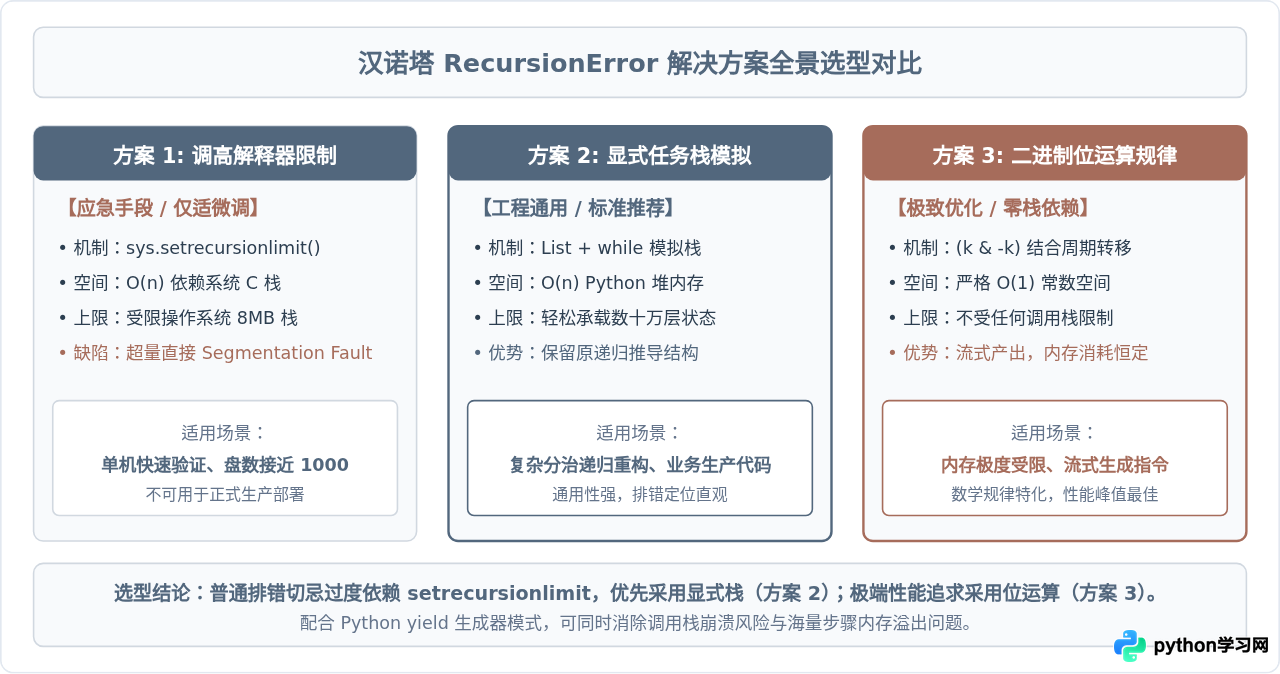
六、总结与实践建议
面对 Python 中的 RecursionError,核心认知的转变在于理解解释器运行时的内部边界。针对汉诺塔及更广义的树形分治递归场景,实践建议归纳如下:
- 理解限制保护的初衷:Python 的递归深度限制是一道“安全阀”,其首要任务是保护底层 C-Stack 避免操作系统崩溃。切勿在未评估调用链深度的前提下盲目放大限制值。
- 优先重构为显式栈:显式栈将深度的承载主体由操作系统栈转移到虚拟机的堆内存空间中,保留了分治递归的算法直觉,是工业界重构递归逻辑的标准范式。
- 善用 Generator 懒加载特性:汉诺塔总步数以 $2^n$ 增长,即使解决了函数调用栈深度,如果一次性将移动步骤全部装入列表,也会迅速耗尽可用内存(OOM)。结合
yield实施流式产出,才是应对大规模求解的完备方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









