

Python面向对象入门:类与对象的基本用法
全面讲解Python面向对象编程的基础概念与核心用法,涵盖类与对象的关系、__init__构造方法、self关键字的本质、实例属性与类属性的命名空间机制及常见误区。
当我们在 Python 中编写规模稍大的程序时,常常会遇到一种尴尬:数据保存在各种字典或列表中,处理数据的函数散落在各处,函数调用时需要层层传递参数,一旦数据结构变动,相关的所有函数都需要逐一修改。面向对象编程(Object-Oriented Programming,简称 OOP)正是为了解决这种“数据与操作脱节”的问题而设计的一套组织思路。它将相关的数据以及针对这些数据的操作封装在一起,形成一个清晰的整体。本文将从类与对象的基本认知开始,系统梳理定义类、实例化对象、理解 self 的实际职责,以及区分实例属性与类属性等入门必备技能。
一、认识类与对象:设计图与实物的对应关系
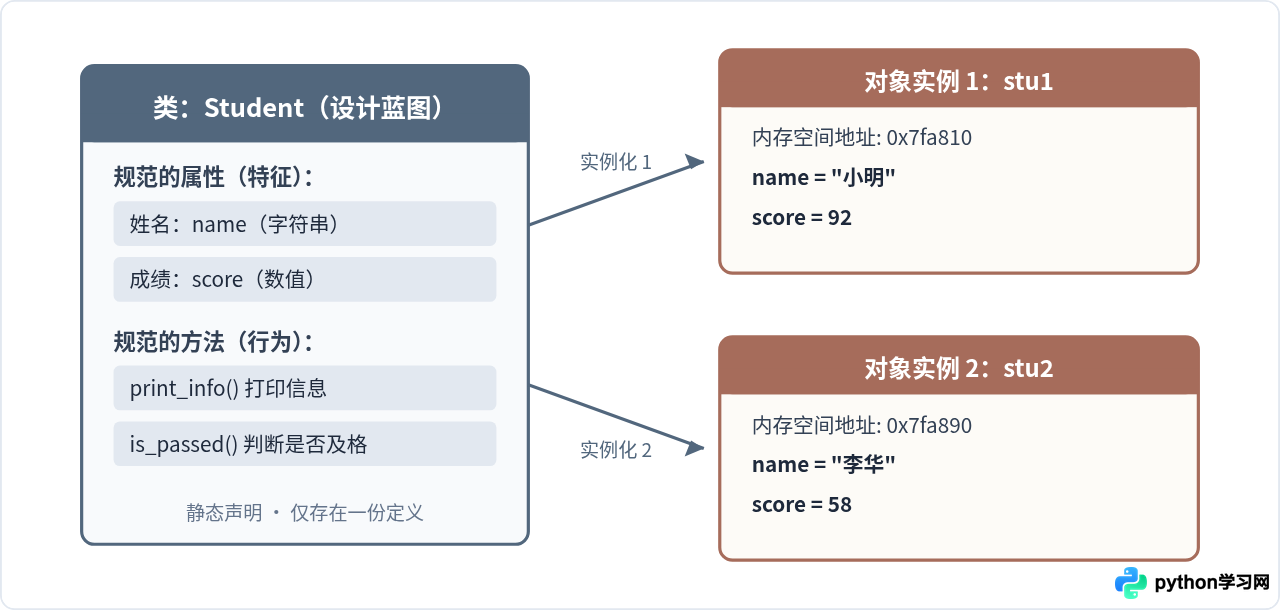
在 Python 中,类(Class)与对象(Object)是一组相互依存的核心概念。要直观理解它们,可以把“类”想象成一张建筑施工图或模具,而把“对象”看作按照图纸实际建造出来的楼房或翻模出来的零件。
施工图本身不能住人,它只规定了楼房的结构、房间尺寸、门窗位置以及建筑应该具备的功能;只有依据施工图真正砌砖浇筑,才能在现实中生成实体楼房。同理,Python 中的类只负责规定该类型的数据包含哪些特征(属性)以及能够执行哪些动作(方法)。当通过类创建出一个具体的“对象”(也称为“实例”,Instance)时,Python 才会真正在计算机内存中开辟一段空间,存储属于该对象的实际数值。
二、类的定义与实例化操作步骤
在 Python 中定义类使用关键字 class。根据官方编码规范 PEP 8,类名通常采用大驼峰命名法(CapWords),例如 Student、BankAccount。以下是构建和使用类的完整操作步骤:
步骤 1:使用 class 声明并编写构造方法
当对象被创建时,我们通常需要立刻给它赋予一些初始数据。Python 提供了专门的初始化方法 __init__()(前后各有两条下划线)。该方法在实例化时会被自动调用,专门用来设置新对象的初始状态。
class Student:
    # 构造方法,负责对象的初始化
    def __init__(self, name, score):
        self.name = name    # 绑定实例属性 name
        self.score = score  # 绑定实例属性 score

    # 实例方法,负责提供对象的行为
    def print_info(self):
        print(f"学生姓名: {self.name}, 考试成绩: {self.score}")
步骤 2:调用类生成具体对象
创建对象的过程就像调用普通函数一样,直接写“类名 + 括号”,并在括号中传入 __init__ 所需的参数。注意此时无需手动传入 self 参数:
# 实例化两个完全独立的学生对象
stu1 = Student("小明", 92)
stu2 = Student("李华", 58)

# 访问对象的属性
print(stu1.name)   # 输出: 小明
print(stu2.score)  # 输出: 58

# 调用对象的方法
stu1.print_info()  # 输出: 学生姓名: 小明, 考试成绩: 92
stu2.print_info()  # 输出: 学生姓名: 李华, 考试成绩: 58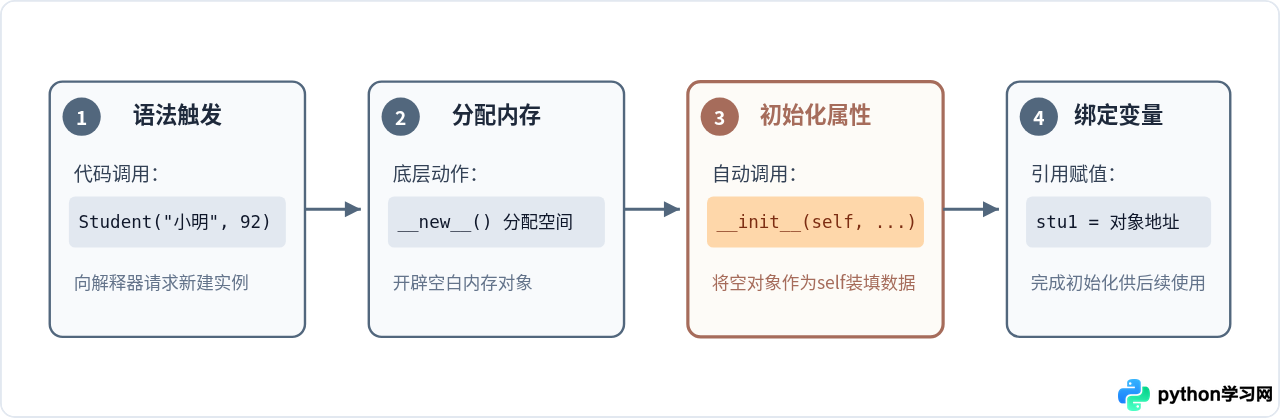
三、深入理解 self:到底谁在执行操作
很多初学 Python 面向对象的读者最困惑的往往是 self 参数:为什么在定义类方法时必须写 self,而在调用 stu1.print_info() 时却完全不用传参?
实际上,self 就是一个普通的变量名,它始终指向“当前正在被操作的具体实例对象”。类定义的方法代码在内存中只有一份,当有两个不同对象 stu1 和 stu2 同时调用 print_info() 时,程序必须清楚到底要打印谁的名字。Python 解释器在执行 stu1.print_info() 时,底层会自动将其翻译为:
# 表面上的调用写法:
stu1.print_info()

# Python 底层实际执行的等价形式:
Student.print_info(stu1)
在这个底层转换中,Python 会把调用方法的实例 stu1 作为第一个实参传给方法内部的 self 形参。因此,方法内部所有的 self.name 和 self.score,实际上就是访问 stu1.name 和 stu1.score。如果是由 stu2 发起调用,self 绑定的就是 stu2。
self 并不是系统强制保留的关键字,理论上你可以把它改名为 this 或其他单词,代码依然能运行。但强烈建议遵守社区约定,一律使用 self,以便其他开发者一眼看懂。
四、关键细节:实例属性与类属性的区分与查找链
在面向对象设计中,并非所有变量都必须绑定在具体的单个对象上。Python 支持两类属性:实例属性与类属性。混淆二者的生命周期和查找机制,是初学者最常见也是最隐蔽的错误来源。
- 实例属性(Instance Attribute):定义在方法内部(通常在
__init__中),通过self.变量名绑定。属于特定对象私有,不同对象的同名实例属性互不干扰。 - 类属性(Class Attribute):直接定义在类内部、所有方法之外的变量。它属于整个类共有,所有实例对象共享访问同一份数据,适合用来存储全局常量、默认配置或统计实例总数的计数器。
class Student:
    # 类属性(所有学生共享)
    school = "第一实验中学"
    total_count = 0

    def __init__(self, name, score):
        # 实例属性(每个学生独有)
        self.name = name
        self.score = score
        # 每次创建新对象,类属性计数器加 1
        Student.total_count += 1

stu1 = Student("小明", 92)
stu2 = Student("李华", 58)

# 通过类或者实例访问类属性
print(Student.school)  # 输出: 第一实验中学
print(stu1.school)     # 输出: 第一实验中学(沿查找链向上检索到类属性)
print(Student.total_count) # 输出: 2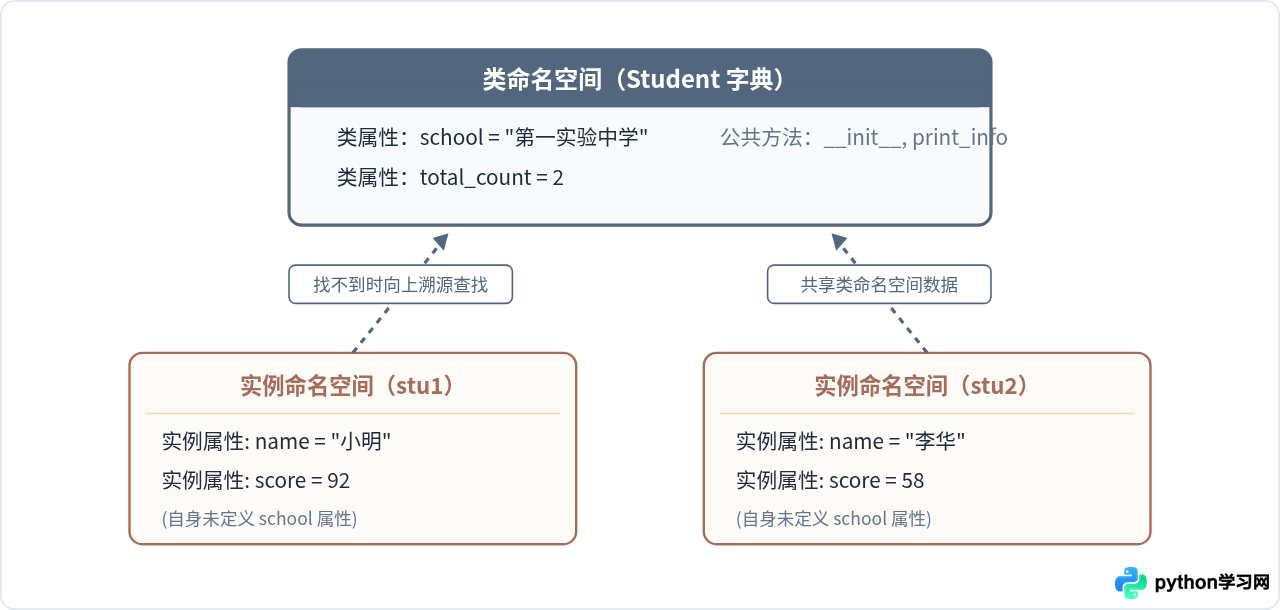
属性查找的核心规则与“覆写陷阱”
当执行 obj.attr 表达式时,Python 会遵循确定性的查找顺序:
- 先在实例自身的字典(
obj.__dict__)中查找,如果存在该键,直接返回。 - 如果实例字典中不存在,则沿着继承链向上到所属类字典(
Class.__dict__)中查找。 - 若依然找不到,则最终抛出
AttributeError异常。
如果编写
stu1.school = "新校区",并不会改变 Student.school,也不会影响 stu2.school。因为赋值语句只会在 stu1 自身的字典中新增一个名为 school 的实例属性,将类属性“遮盖”住。如果需要修改类属性,必须明确通过类名操作:Student.school = "新校区"。
五、入门常见误区与防范措施
在编写类和对象代码时,初学者往往因为习惯了面向过程的函数式写法而陷入几个典型陷阱:
1. 方法定义时遗漏 self 形参
定义普通函数时不需要在参数列表首位声明调用者,但类内的实例方法必须显式保留 self。如果写成 def get_name():,在调用 stu1.get_name() 时,Python 依然会传入 stu1 作为实参,导致系统抛出报错:
TypeError: Student.get_name() takes 0 positional arguments but 1 was given看到“接受0个参数但传了1个”的报错,百分之九十以上的原因都是方法定义时忘记写 self。
2. 使用可变对象作为类属性
如果将列表、字典或集合直接作为类属性,所有实例都将共享引用同一块内存。通过某个实例对列表进行 append() 操作时,所有其他实例读取到的列表都会被同步修改,极易导致难以追踪的数据污染:
class BadExample:
    tags = []  # 错误做法:类属性使用可变列表

class GoodExample:
    def __init__(self):
        self.tags = []  # 正确做法:在 __init__ 中为每个实例创建独立列表
六、面向对象基础总结全景
掌握面向对象编程,不需要一开始就去死磕抽象的继承体系和多态设计模式。最根本、最关键的起步,在于建立起“清晰的边界感”:清楚类是结构模板、对象是状态容器;清楚 __init__ 负责接生、self 负责对号入座;清楚何时该让数据私有、何时该由类共享。
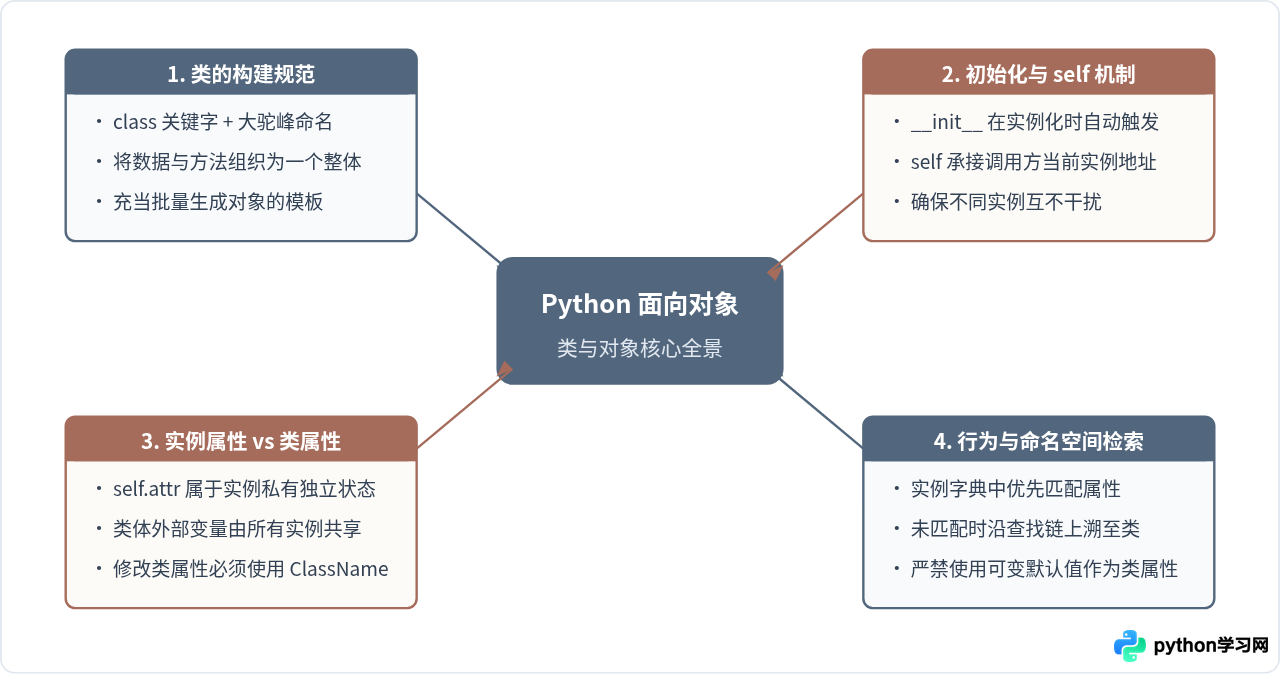
通过掌握以上这些基础用法,编写逻辑清晰、结构内聚的 Python 代码将变得非常顺手。在此基础之上,后续深入学习继承、多态以及特殊魔法方法(如 __str__、__repr__)时,也会更加水到渠成。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









