

Python怎么获取大写字母的ASCII编码值
详细介绍在Python中如何使用内置函数ord()获取大写字母的ASCII编码值,包括单字符转换、批量获取、字母表映射及常见边界异常处理。
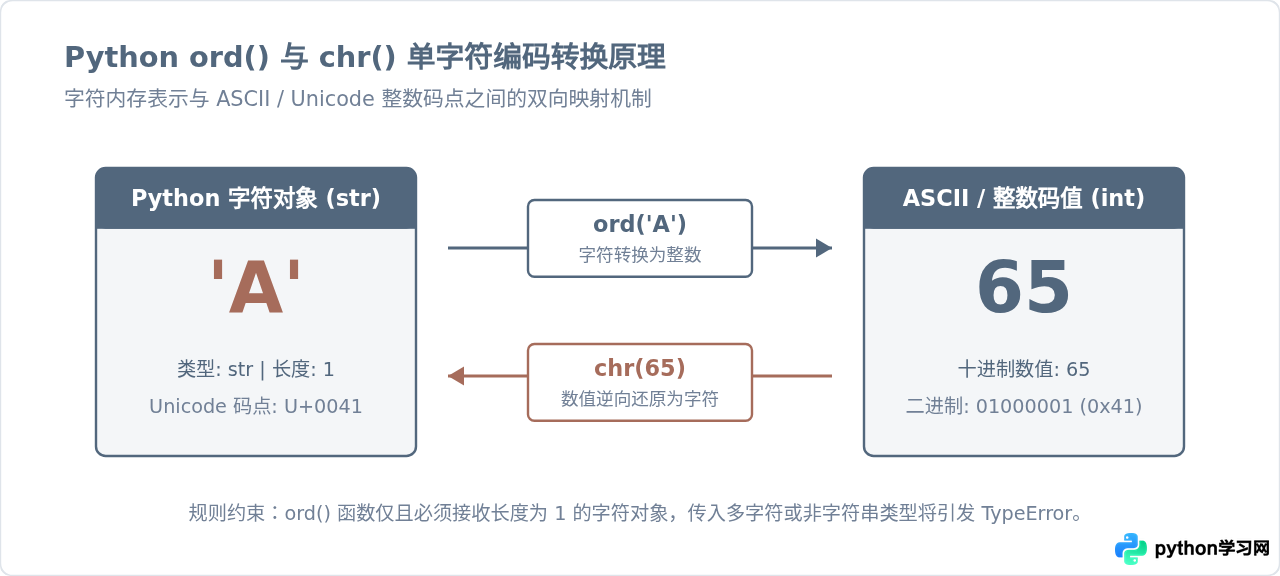
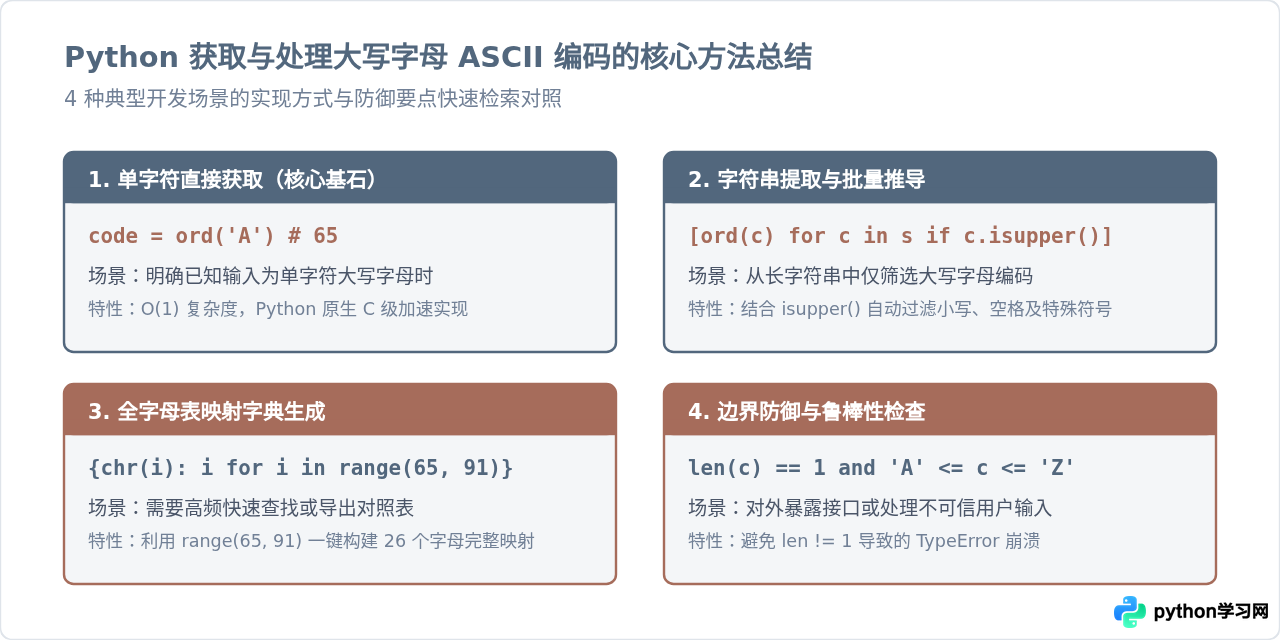
在 Python 中获取大写字母的 ASCII 编码值,最直接也是官方推荐的标准方法是使用内置函数 ord()。传入任意一个长度为 1 的大写英文字母字符串(例如 'A'),该函数就会返回其对应的十进制整数编码值(65)。26 个大写英文字母在 ASCII 编码体系中是严格连续排列的,范围恰好是 65 到 90。
一、核心函数:ord() 的基础用法
在 Python 中,字符本质上是以 Unicode 形式存储的单字符字符串。ord()(即 ordinal 的缩写)是 Python 的内建函数,专门用来返回代表该字符的 Unicode 码点(Code Point)。由于 ASCII 编码是 Unicode 字符集的前 128 个子集,因此对于所有的英文字母,ord() 返回的数值与标准 ASCII 码完全一致。
获取单个大写字母 ASCII 值的最简代码如下:
# 获取大写字母 'A' 的 ASCII 码值
ascii_val_a = ord('A')
print(ascii_val_a)  # 示例输出: 65

# 获取大写字母 'Z' 的 ASCII 码值
ascii_val_z = ord('Z')
print(ascii_val_z)  # 示例输出: 90
与 ord() 互为逆操作的是 chr() 函数。如果你有一个位于 65 到 90 之间的整数,通过 chr() 可以随时将其还原为对应的大写字母字符。
二、标准操作流程与防御性检查
在实际编码或处理外部输入时,直接对变量调用 ord() 可能会遇到两类常见问题:一是传入的变量不是长度为 1 的字符串(例如空字符串 "" 或多个字符 "ABC"),此时 Python 解释器会直接抛出 TypeError: ord() expected a character, but string of length ... found;二是传入的字符虽然合法,但属于小写字母、数字或符号,不符合“获取大写字母”的业务前提。
编写一个具备校验能力的健壮函数可以按照以下步骤执行:
- 类型与长度校验:检查输入对象是否为字符串且
len(char) == 1。 - 大写有效性判断:通过
char.isupper()或区间比对'A' <= char <= 'Z'确认目标字符是大写字母。 - 执行转换:调用
ord(char)获取对应的整数值并返回。
def get_uppercase_ascii(char):
    # 步骤 1: 验证是否为单字符字符串
    if not isinstance(char, str) or len(char) != 1:
        raise TypeError(f"输入参数必须是长度为 1 的字符串,当前收到: {repr(char)}")

    # 步骤 2: 验证是否属于大写英文字母
    if not ('A' <= char <= 'Z'):
        raise ValueError(f"目标字符 '{char}' 不是有效的大写英文字母 (A-Z)")

    # 步骤 3: 提取并返回 ASCII 码
    return ord(char)

# 正常调用测试
print(get_uppercase_ascii('M'))  # 示例输出: 77

# 异常捕获示例
try:
    get_uppercase_ascii('abc')
except TypeError as e:
    print(f"捕获预期异常: {e}")  # 示例输出: 捕获预期异常: 输入参数必须是长度为 1 的字符串...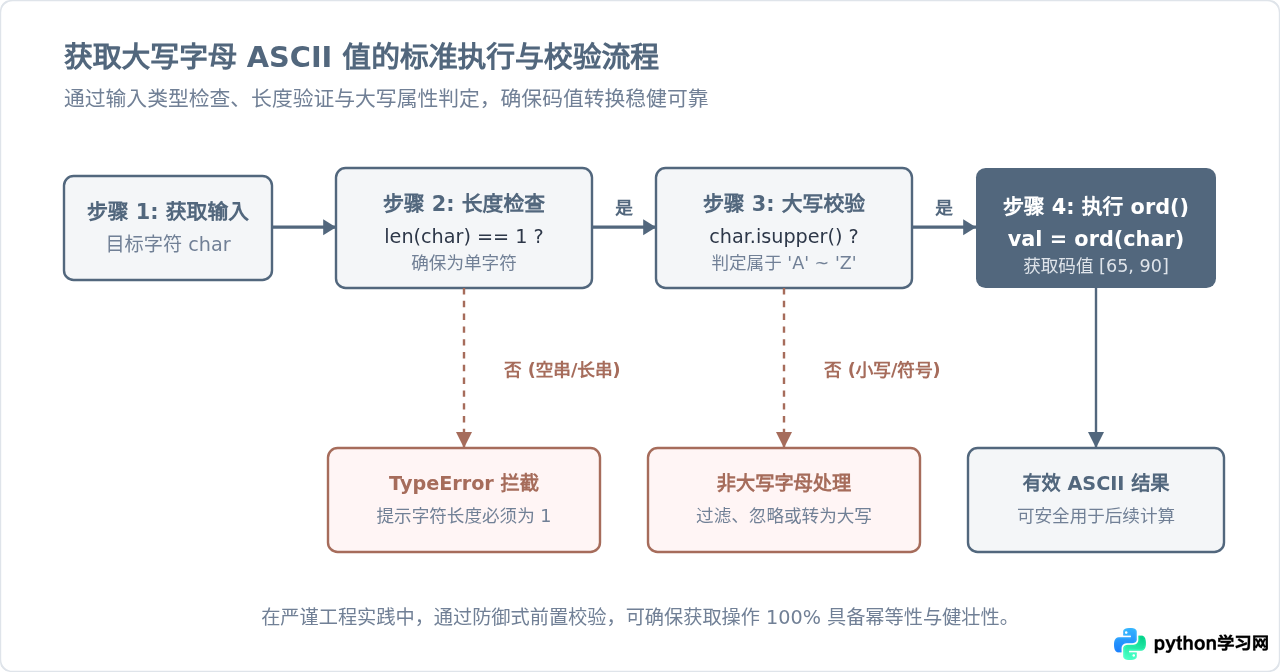
三、大写字母在 ASCII 码表中的区间与特征
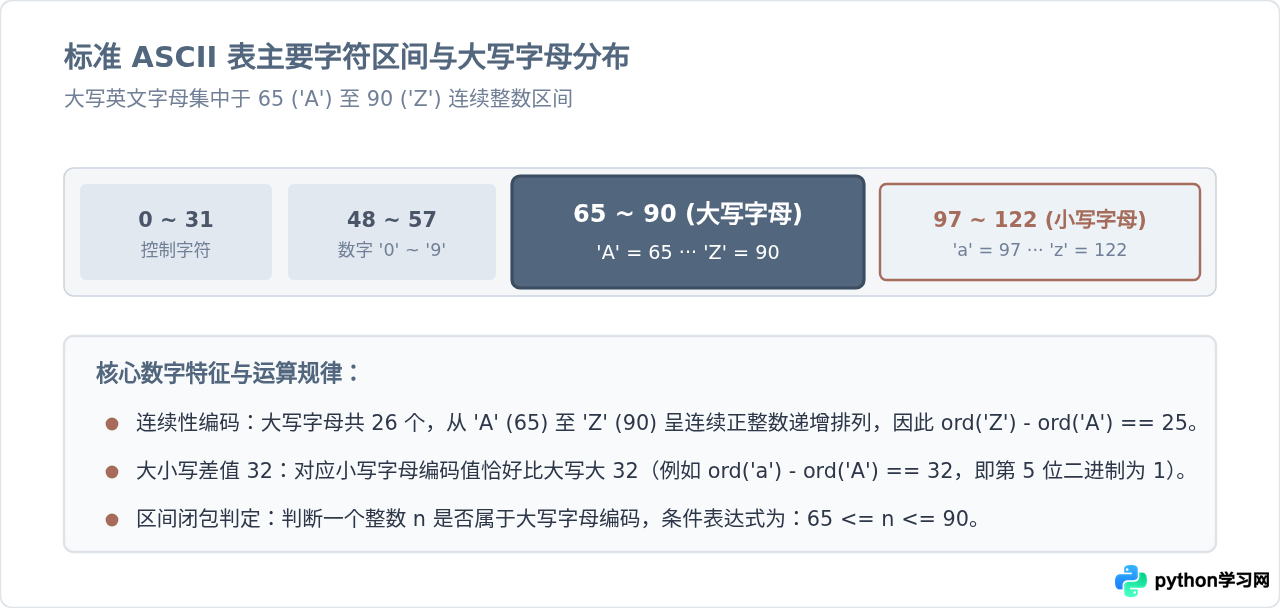
了解大写字母在整个 ASCII 字符集中的位置有助于加深理解。ASCII 码表使用 7 个比特位表示 128 个字符(0 到 127):
- 0 ~ 31 以及 127:控制字符(如换行符 LF、回车符 CR、制表符 TAB 等)。
- 48 ~ 57:数字字符
'0'到'9'。 - 65 ~ 90:大写英文字母
'A'到'Z'。 - 97 ~ 122:小写英文字母
'a'到'z'。
注意到一个重要特征:大写字母与对应小写字母的 ASCII 码值之间相差刚好是 32。例如 ord('a') - ord('A') = 97 - 65 = 32。在二进制层面,32 刚好代表第 6 位(从右往左数,权值为 $2^5 = 32$)由 0 变为 1。掌握这一特性,常用于快速大小写互转或底层位运算。
四、常见开发场景下的实用代码方案
1. 批量提取字符串中的大写字母编码
在处理含有大小写字母、数字和符号的混合文本时,可以使用列表推导式配合字符串方法 isupper(),仅针对其中的大写字母提取 ASCII 值:
text = "Python 3.12 Release"

# 仅筛选大写字母并获取 ASCII 码
upper_ascii_list = [ord(char) for char in text if char.isupper()]
print(upper_ascii_list)  # 示例输出: [80, 82] (分别对应 'P' 和 'R')
2. 生成完整 26 个大写字母与其 ASCII 码映射字典
如果业务中需要频繁反查或比对大写字母的 ASCII 编码,可以在程序初始化时构造一个查找字典:
# 利用 range(65, 91) 遍历全部大写字母编码
uppercase_ascii_map = {chr(code): code for code in range(65, 91)}

# 查看部分结果
print("A:", uppercase_ascii_map['A'])  # 示例输出: A: 65
print("M:", uppercase_ascii_map['M'])  # 示例输出: M: 77
print("Z:", uppercase_ascii_map['Z'])  # 示例输出: Z: 90
3. 计算字母在字母表中的序号(1~26)
在做数据处理、算法加密或表格列索引转换时,经常需要将字母转换为它在字母表中的物理位置。由于 ord('A') 是 65,直接减去 64 即可得到序号:
char = 'C'
# 计算当前字母在 1~26 中的顺序
alphabet_index = ord(char) - ord('A') + 1
print(f"字母 '{char}' 在字母表中的位置是: {alphabet_index}")  # 示例输出: 3
五、核心方法与注意事项总结
获取大写字母的 ASCII 值在 Python 中非常轻量且高效。总结其核心要点:
- 首选方法:始终优先使用原生内置的
ord(),执行速度最快,无需导入任何第三方模块。 - 数值范围:牢记
65到90对应'A'到'Z'。若返回值不在该区间,说明输入的不是大写英文字母。 - 入参规范:确保传入的参数为单字符字符串,严禁传入多字符文本或非字符类型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









