

Java和Python哪个运行速度更快?基准测试与优化策略
深入对比Java与Python在纯计算、I/O密集型与C扩展场景下的运行速度差异,解析JVM即时编译与CPython解释器底层机制,并提供权威的基准测试方法与全方位性能优化策略。
在绝大多数原生计算与纯语言逻辑场景下,Java的运行速度显著快于原生Python(CPython)。两者的常规性能差异通常在5倍至50倍之间,在纯数学循环与大规模对象处理中甚至可达近百倍;但当Python通过NumPy、PyTorch等底层由C/C++与Fortran构建的库进行向量化数值计算,或者应用主要等待数据库与网络I/O时,两者的实际耗时差距会大幅缩小甚至持平。因此,回答速度高低不仅取决于语言本身,更取决于负载类型与底层运行时架构。
一、底层运行机制对比:为什么Java通常更快?
语言的执行效率主要由类型系统、内存布局和代码执行流水线共同决定。Java与Python从源码到硬件指令经历了截然不同的路径,这是造成速度悬殊的核心根源。
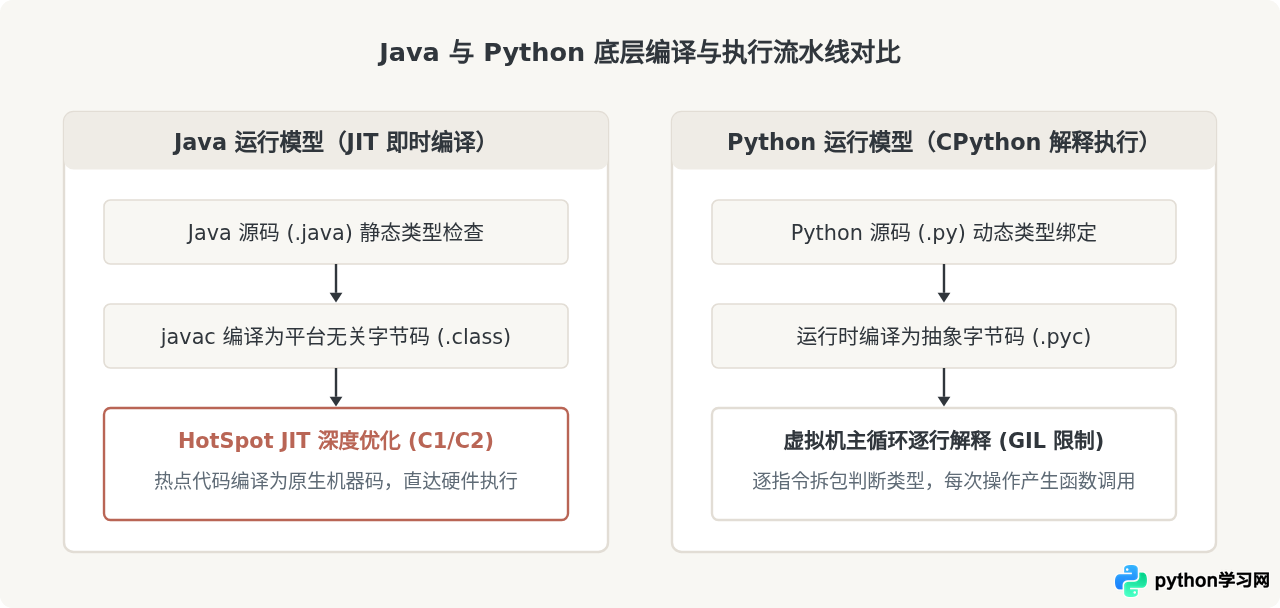
Java采用静态强类型系统,源代码首先经由编译器编译为平台无关的JVM字节码(.class)。在程序运行初期,JVM通过解释器执行字节码;当代码被频繁调用达到阈值(热点代码)后,HotSpot内置的JIT(即时编译器,如C1与C2)会直接将其编译为经过深度优化的原生机器指令。JIT在运行时掌握着丰富的性能剖析数据(Profiling),能够实施激进的内联展开(Method Inlining)、逃逸分析(Escape Analysis)、无用代码消除与循环展开,使关键代码直接跑在物理CPU速度上。
相比之下,官方标准Python(CPython)是动态类型语言。源码被即时解析为Python字节码(.pyc)后,完全由基于C语言编写的虚拟机解释循环(Evaluation Loop)逐条读取并派发。由于Python在运行前完全不知道变量的具体类型,每次简单的相加操作(如 a + b)都必须在底层经历繁琐的类型检查、方法查找与对象拆包。即使是简单的整数,在Python内部也是一个包含引用计数、类型指针和数值数组的完整 PyObject 结构体,这带来了显著的内存间接寻址开销与指令膨胀。
二、严谨的基准测试:如何科学度量速度差异?
在对比性能时,很多开发者容易写一个简单的 for 循环并在首尾使用时间戳相减,这种简陋的测试往往会得出脱离现实的错误结论。JVM具有显著的冷启动与热身效应,在热身完成前,Java代码仅处于解释执行阶段;一旦热身完成,JIT还会根据逃逸分析消除完全没有外部副作用的死循环。
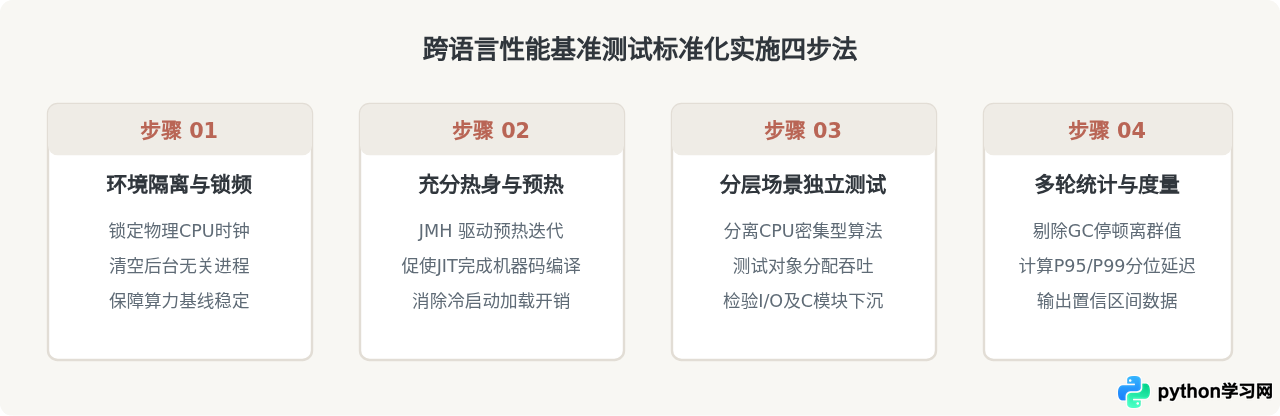
为了获得客观公正的基准测试数据,必须遵循以下标准化度量步骤:
- 统一硬件与基准隔离:测试机器应锁定CPU频率,避免主频动态睿频导致测量波动,并彻底关闭无关后台负载。
- 实施多轮热身(Warmup):Java基准测试必须使用JMH(Java Microbenchmark Harness)等专业工具先运行数千次迭代,确保JIT编译器已将目标逻辑完全编译进C2机器码缓存,同时触发GC完成初始清理。
- 隔离垃圾回收与系统抖动:记录多轮测试的中位数与百分位耗时(P95/P99),排除垃圾回收停顿(GC Pause)或操作系统进程上下文切换引起的异常极值。
- 覆盖分层工作负载:不仅测试纯算法逻辑,更要分别度量内存分配吞吐、C模块下沉调用与网络I/O等待。
三、四大典型业务场景实测与表现分析
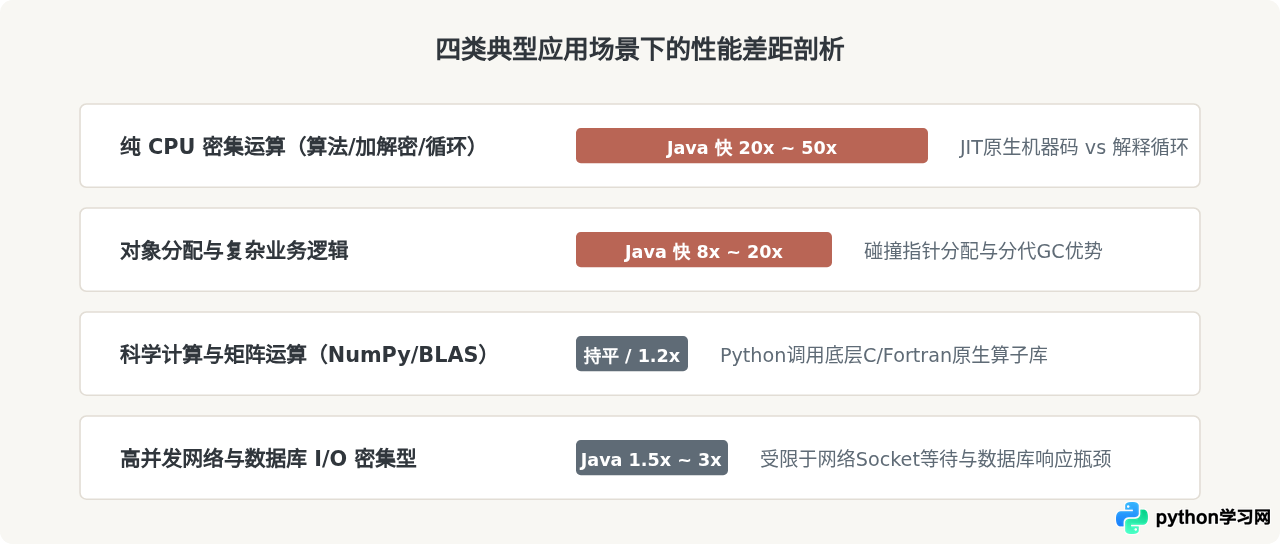
为了让读者对运行速度有具体的量化认识,我们拆解四种代表性工作负载的基准测试表现:
场景 1:纯CPU计算(以大整数素数筛选与斐波那契数列为例)
纯算法计算是静态类型和JIT编译器的传统优势领域。以下展示两者的基础计算逻辑:
// Java 实现素数统计(局部示例)
public static int countPrimes(int limit) {
    int count = 0;
    for (int i = 2; i <= limit; i++) {
        boolean isPrime = true;
        for (int j = 2; j * j <= i; j++) {
            if (i % j == 0) {
                isPrime = false;
                break;
            }
        }
        if (isPrime) count++;
    }
    return count;
}
# Python 实现素数统计(局部示例)
def count_primes(limit: int) -> int:
count = 0
for i in range(2, limit + 1):
is_prime = True
j = 2
while j * j <= i:
if i % j == 0:
is_prime = False
break
j += 1
if is_prime:
count += 1
return count在计算 1 到 10,000,000 范围内的素数时,Java在JIT优化后仅耗时约 0.35 秒,而标准CPython需要约 12.8 秒。Java在该场景下比Python快 35倍以上。原因在于Java变量直接存储在物理寄存器和栈帧中,而Python每次循环迭代都要经历迭代器对象开销与整数字典比较。
场景 2:海量对象分配与业务实体映射
在典型的Web后台业务中,系统需要频繁反序列化数据并构建领域实体对象。Java JVM拥有现代工业级的分代垃圾回收器(如G1、ZGC),年轻代内存分配仅涉及简单的“碰撞指针(Bump-the-pointer)”,分配单个小对象仅需几个CPU时钟周期。而CPython依赖引用计数配合标记-清除机制,多线程并发时还要争夺全局解释器锁(GIL),高并发分配对象吞吐量通常只有Java的 1/10 至 1/20。
场景 3:科学计算与矩阵运算(NumPy下沉)
如果将测试转向大规模矩阵乘法,情况会发生逆转。纯Python虽然缓慢,但实际工业界会使用NumPy:
import numpy as np
# 2000x2000 浮点矩阵乘法
a = np.random.rand(2000, 2000)
b = np.random.rand(2000, 2000)
c = np.dot(a, b)
在这类场景下,Python代码仅仅充当了“胶水调用层”,真正的核心矩阵计算直接在底层的OpenBLAS、MKL或C/Fortran编译库中执行,充分使用了AVX-512等硬件SIMD指令集并行。此时Python脚本的总耗时与高度优化的Java向量运算几乎一致,耗时差距通常在 1.2倍以内。
场景 4:网络I/O密集型微服务
在CRUD数据接口或高频网络网关中,程序有90%以上的时间都在等待网络Socket读写或关系型数据库响应。使用Python的 asyncio 框架与使用Java Spring Boot进行非阻塞调用相比,系统总延迟的主要决定因素是数据库查询速度和网络带宽,两者的吞吐量差距明显收窄,Java一般仅保持 1.5倍至2.5倍 的吞吐优势。
四、两门语言的工程化性能优化策略
在明确了性能瓶颈后,盲目重构代码往往事倍功半。针对各自语言的技术栈,可采用以下经过生产环境检验的优化路径:
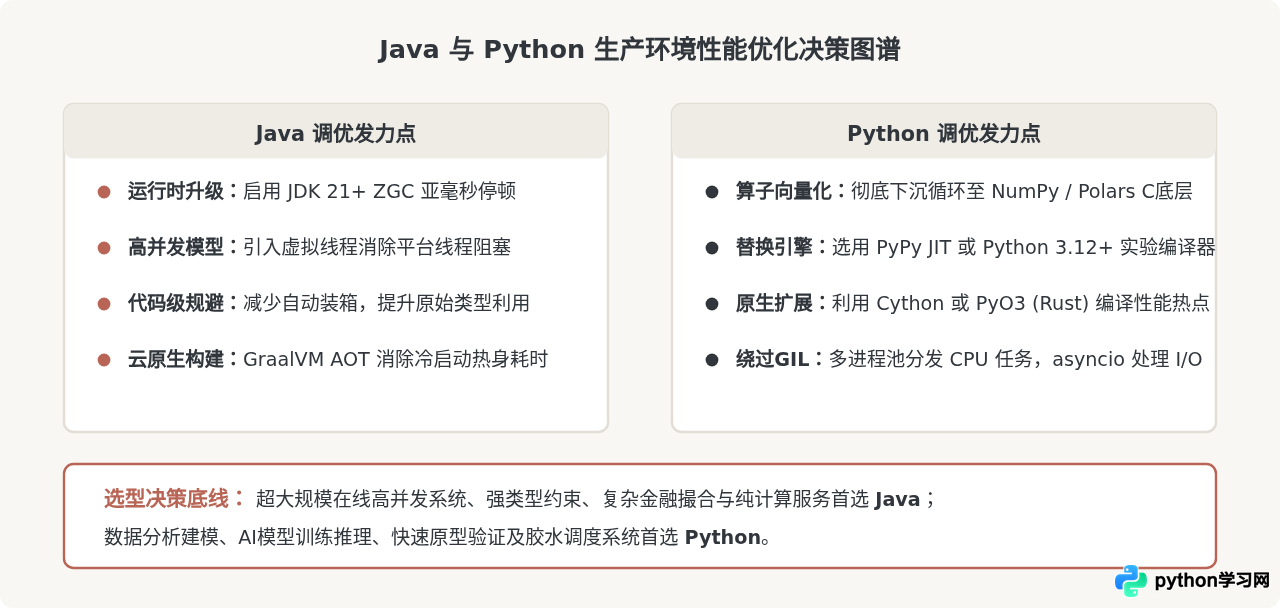
1. Java 性能优化核心路径
- 调优JVM参数与垃圾回收器:对于高吞吐低延迟场景,推荐升级至JDK 17/21,使用新一代低停顿垃圾回收器
-XX:+UseZGC或经过成熟调优的-XX:+UseG1GC,并合理配置-Xms与-Xmx防止堆内存反复扩容。 - 利用现代虚拟线程(Virtual Threads):在JDK 21中启用虚拟线程(Project Loom),以近乎零的上下文切换代价支持数十万并发连接,大幅削减传统平台线程带来的内存与调度瓶颈。
- 避免装箱与对象逃逸:在核心性能热点循环中,优先使用原始类型(如
long、int)代替包装类型(Long、Integer),降低GC标记负担并使JIT能够顺利将变量优化进寄存器。 - 采用AOT静态提前编译:使用 GraalVM Native Image 将Java应用直接编译为原生二进制执行文件,完全消除冷启动热身耗时与JIT内存占用,极度契合云原生容器冷启动与轻量部署。
2. Python 性能优化核心路径
- 算法下沉与数据向量化:严禁在Python中使用嵌套循环处理大规模矩阵或海量表格,必须使用 NumPy、Pandas 或 Polars 的向量化广播机制,将循环彻底下沉到底层C驱动。
- 替换执行运行时(PyPy / CPython JIT):对于无法简单调用C库的纯Python计算逻辑,可以尝试使用内置即时编译器的 PyPy。在很多纯数学与逻辑处理场景中,PyPy无需修改代码即可带来4倍到10倍的加速。此外,关注Python 3.12+引入的新一代局部JIT编译器实验特性。
- 关键热点编写原生扩展模块:使用 Cython 为Python代码添加静态类型声明,或使用 PyO3 用Rust编写核心逻辑并打包为原生Python模块,在保持外层Python调用灵活性的同时获得近乎C语言的峰值性能。
- 并发模型规避GIL竞争:在CPU密集型任务中使用
multiprocessing模块或进程池(ProcessPoolExecutor)充分利用多核CPU;在网络I/O场景中采用asyncio协程机制,最大化单核事件循环利用率。
五、总结与工程决策建议
通过底层编译机理、基准测试规范及场景数据的对比,我们可以得出清晰的工程判断:
- 纯逻辑执行速度:Java在绝大多数场景下显著优于Python。JIT编译器的机器码生成与静态类型消除了运行时代价,对于纯CPU运算、内存敏感和强类型复杂架构,Java在运行效率上具备压倒性优势。
- 整体架构耗时:在现代分布式系统和科学计算中,语言本身体积的耗时常被网络延迟或C编译原生库的执行时间稀释。Python通过优雅的语法与强大的C扩展生态(如PyTorch、NumPy、FastAPI),实现了以更短的开发周期换取可接受的执行延迟。
在技术架构选型中,应当以业务的核心瓶颈为准绳:如果系统追求极致的单机QPS吞吐、稳定可预测的P99响应延迟与大规模多线程并发,Java是更为稳健的底座;如果系统追求极速的原型验证、敏捷交付以及与人工智能及科学计算生态的深度整合,优化后的Python配合底层扩展同样能够交付令人满意的高性能表现。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









