

Python中下划线的5种常见用法与区别

在 Python 中,下划线 _ 远不止是一个普通标识符字符。根据出现的位置和数量,它可以承担临时占位、内部私有约定、避免命名冲突、类属性名称修饰(Name Mangling)以及特殊方法(Dunder Method)标识等不同职责。本文将系统拆解下划线的 5 种核心用法,理清语法强制规则与编码约定的界限,助你在阅读和编写 Python 代码时建立准确的条件反射。
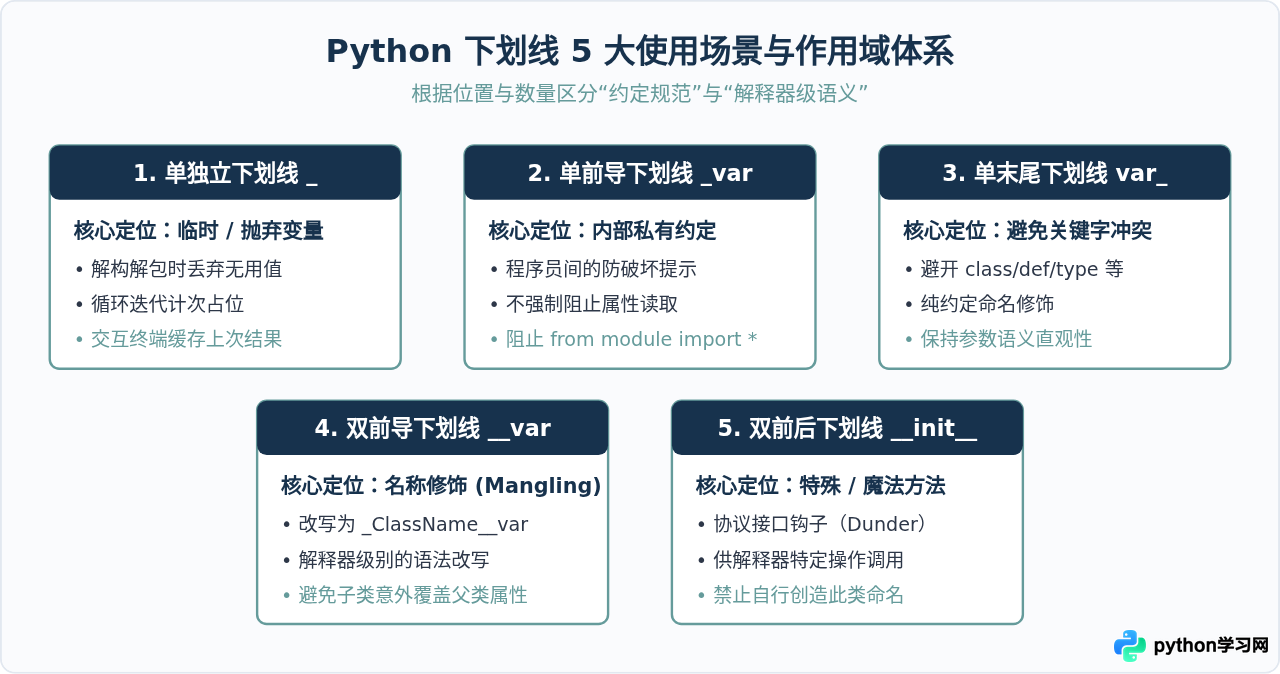
1. 单独立下划线(_):临时占位与结果缓存
单独一个下划线 _ 在 Python 中是一个完全合法的变量名。虽然它在语法层面与普通变量没有差异,但在通用编码习惯中,它主要传达“该变量值并不重要”或“仅作临时过渡”的含义。
常见场景一:元组解包与忽略不需要的值
当函数返回多个数据项,或者遍历包含复合结构的序列时,如果我们只关心其中一部分字段,就可以用 _ 接收被丢弃的值:
# 场景:获取用户信息,仅需要姓名和年龄,忽略地址与电话
user_data = ("张三", 28, "北京市海淀区", "13800000000")
name, age, _, _ = user_data
print(f"姓名: {name}, 年龄: {age}")

# 结合扩展解包操作符 * 忽略中间的多项
first, *_, last = [10, 20, 30, 40, 50]
print(f"首项: {first}, 尾项: {last}") # 输出: 首项: 10, 尾项: 50
常见场景二:循环计次中的无用迭代变量
当我们需要执行某段逻辑固定的次数,但循环体内部完全不需要当前循环索引时,使用 _ 可以让代码意图极为明确,避免引起代码静态检查工具(如 flake8、pylint)的未引用变量告警:
# 重复执行指定逻辑 5 次
for _ in range(5):
    # 示例输出:明确标示为循环执行,无需依赖计次变量
    print("正在执行心跳检测...")
常见场景三:交互式解释器中的上一条执行结果
在 Python 原生 REPL 交互命令行中,_ 会被解释器自动赋予特殊能力:它始终保存上一条被成功计算且未被赋值的表达式返回值:
>>> 12 * 8
96
>>> _ + 4
100
>>> f"最终数值为 {_}"
'最终数值为 100'
注意:在标准脚本文件中,_ 绝不会自动缓存上一行执行结果;该特性仅在交互式解释器(REPL / Jupyter)中有效。
2. 单前导下划线(_var):内部实现约定与模块导入限制
在变量名、函数名或类名前添加一个单前导下划线,例如 _internal_counter 或 _calculate_hash(),是 Python 社区中最经典的“私有”约定。
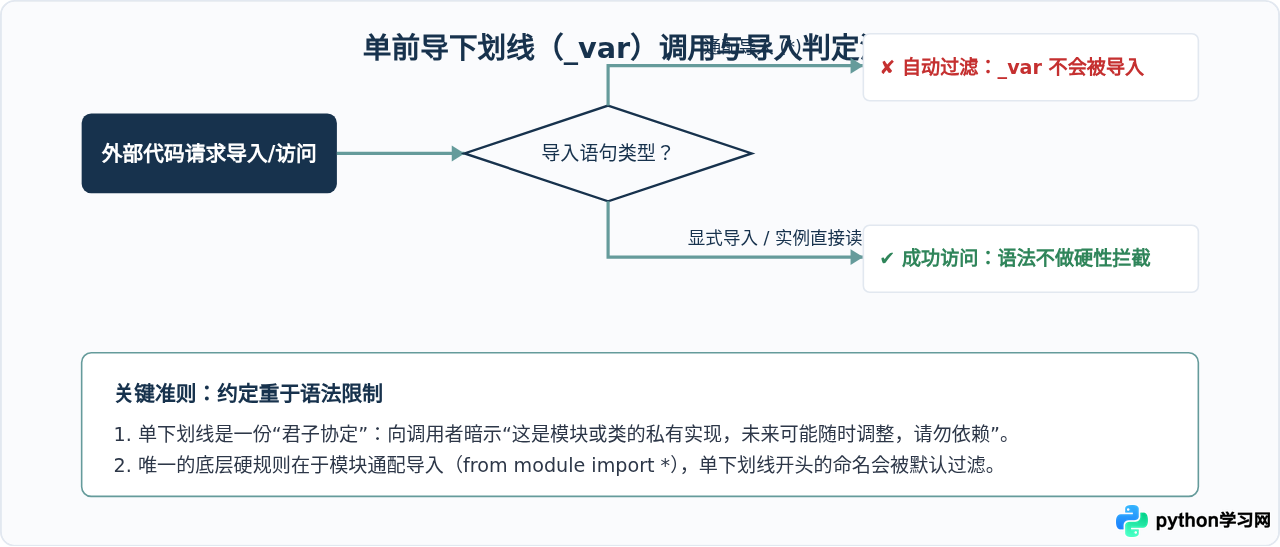
类属性中的约定属性
在类定义中,_var 并不会阻止外部直接访问。Python 并未在语言层面设置类似于 C++ 或 Java 的 private 关键词。
class DatabaseConnector:
    def __init__(self, host):
        self.host = host
        self._connection_cache = {} # 约定内部使用的私有属性

conn = DatabaseConnector("localhost")
# 虽然外部可以直接读取与修改,但违背了设计者的封装意图
print(conn._connection_cache) # 输出示例: {}
模块级别的影响:阻止通配导入
单前导下划线唯一触发解释器硬性规则的地方在于 from module import *。假设存在一个名为 network_utils.py 的模块:
# network_utils.py
public_url = "https://api.example.com"
_internal_token = "secret-token-12345"

def ping():
    return "pong"

def _internal_log():
    return "logging"
当外部通过通配符导入时,下划线开头的对象不会被导入:
# main.py
from network_utils import *

print(public_url) # 正常打印: https://api.example.com
print(ping())       # 正常打印: pong

# 尝试访问以下两项会直接抛出 NameError 异常
# print(_internal_token)
# print(_internal_log())
注意:如果使用显式导入(如 from network_utils import _internal_token)或模块级导入(import network_utils; network_utils._internal_token),则依然可以正常访问。
3. 单末尾下划线(var_):避免命名与 Python 保留关键字冲突
Python 拥有一组严格的保留关键字(如 class, def, in, from, type, id 等)。有时这些词汇在自然业务语境下是极其精确的变量名或形参名。
根据 PEP 8 规范,解决此类冲突的标准方案是在变量末尾追加一个单下划线,即 var_:
# 常见于 HTML 渲染、数据库模型构建或函数参数中
def create_element(tag_name, class_=None):
    if class_:
        return f"<{tag_name} class='{class_}'></{tag_name}>"
    return f"<{tag_name}></{tag_name}>"

# 调用示例
div = create_element("div", class_="container-box")
print(div) # 输出示例: <div class='container-box'></div>
末尾下划线完全是命名约定,解释器对其不做任何额外的转换或限制。它相比随意拼写缩写(如 cls_name 或 klass)更能保持参数的直观性。
4. 双前导下划线(__var):名称修饰(Name Mangling)机制
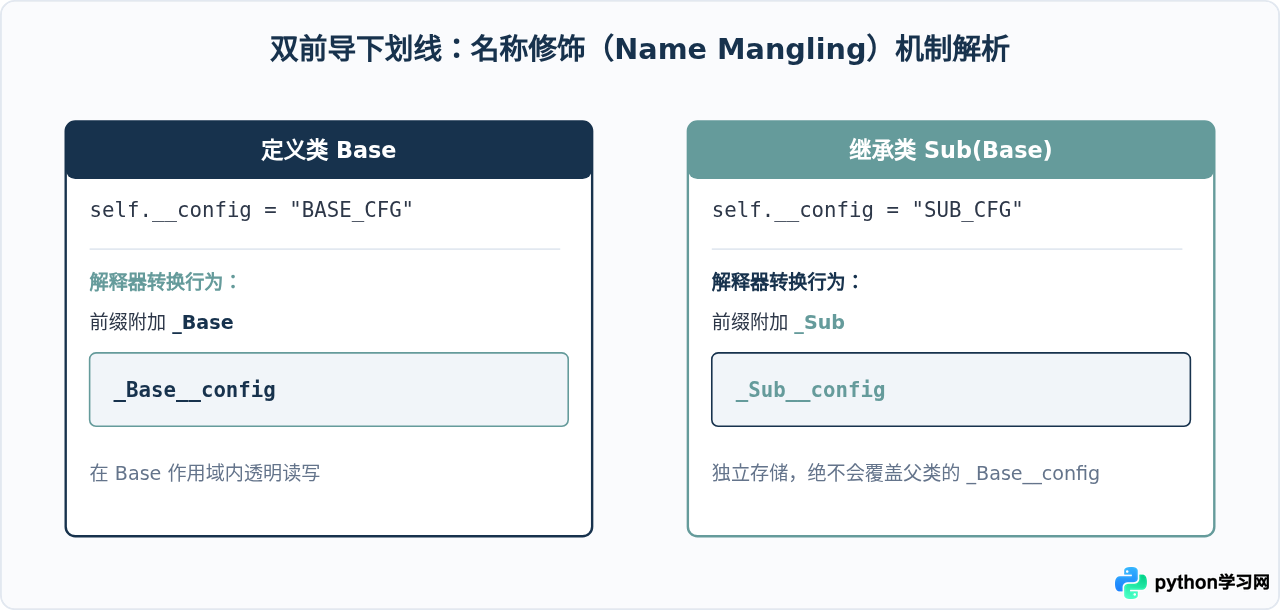
当属性名以至少两个下划线开头,且末尾最多只有一个下划线时(例如 __private_data),Python 解释器会启动名称修饰(Name Mangling)机制。
名称修饰的设计目的与工作过程
名称修饰的核心目的是防止子类在继承时意外覆盖父类的关键内部属性或方法。Python 解释器在编译代码时,会自动将形如 __var 的标识符重命名为 _ClassName__var。
我们通过完整的继承示例来观察这个现象:
class Base:
    def __init__(self):
        self.__secret = "base_secret"

    def get_secret(self):
        return self.__secret

class Child(Base):
    def __init__(self):
        super().__init__()
        self.__secret = "child_secret"

obj = Child()
# 访问子类的 get_secret() 方法,依然返回父类的属性值
print(obj.get_secret()) # 输出示例: base_secret

# 查看实例内部所有属性键名
print([key for key in dir(obj) if "secret" in key])
# 输出示例: ['_Base__secret', '_Child__secret']
由此可见,父类和子类各自拥有独立的修饰名称,子类没有在无意中覆盖父类的属性。
注意:名称修饰绝不是数据加密或安全防护机制。外部依然可以通过 obj._Base__secret 强制读取或修改该属性。
5. 双前后下划线(__var__):特殊方法(Dunder Method)
同时以双下划线开头和结尾的名称(如 __init__, __str__, __len__, __getitem__)被称为特殊方法或魔术方法(英文俗称 dunder methods,即 double underscore 的缩写)。
这些标识符是 Python 语言核心协议的内置保留保留字。当你在类中实现这些方法时,等于为该类的实例对象绑定了特定的内置操作支持:
__init__(self, ...):对象实例化与属性初始化。__str__(self):定义print(obj)或str(obj)的返回字符串。__repr__(self):定义对象在解释器终端中的显式表达式。__len__(self):支持内置函数len(obj)的调用。__getitem__(self, key):支持通过下标索引obj[key]访问元素。
class ShoppingCart:
    def __init__(self, items):
        self.items = list(items)

    def __len__(self):
        return len(self.items)

    def __repr__(self):
        return f"ShoppingCart({self.items})"

cart = ShoppingCart(["苹果", "牛奶", "面包"])
print(len(cart))       # 调用 __len__,输出示例: 3
print(cart)            # 调用 __repr__,输出示例: ShoppingCart(['苹果', '牛奶', '面包'])
重要准则:开发者应该只在重载已有内置协议时使用双前后下划线命名,严禁自定义不存在的双下划线命名(例如 __my_custom_func__)。未来 Python 版本一旦引入同名内置方法,会导致严重的命名冲突与未定义行为。
5 种下划线用法的核心差异与选型总结
为了在实际编码中快速做出准确选择,下表对这 5 种用法在语法效力、常见目的与作用域上进行了系统横向对比:
| 命名形式 | 典型命名示例 | 机制类型 | 主要目的与核心行为 |
|---|---|---|---|
| 独立单下划线 | _ |
约定 + 交互支持 | 临时占位、忽略解包不需要的值;交互命令行中缓存上一行执行结果。 |
| 单前导下划线 | _counter |
软性约定 + 语法过滤 | 标识模块或类内部私有实现;在 from module import * 时被自动过滤。 |
| 单末尾下划线 | class_ |
纯命名约定 | 避免变量名与 Python 保留关键字(如 class, id)发生词法冲突。 |
| 双前导下划线 | __balance |
解释器硬性改写 | 名称修饰(Name Mangling),改写为 _ClassName__var,避免子类意外覆盖。 |
| 双前后下划线 | __init__ |
系统保留语法接口 | 魔术方法(Dunder),挂载 Python 核心协议(如长度、字符串转换、运算符重载)。 |
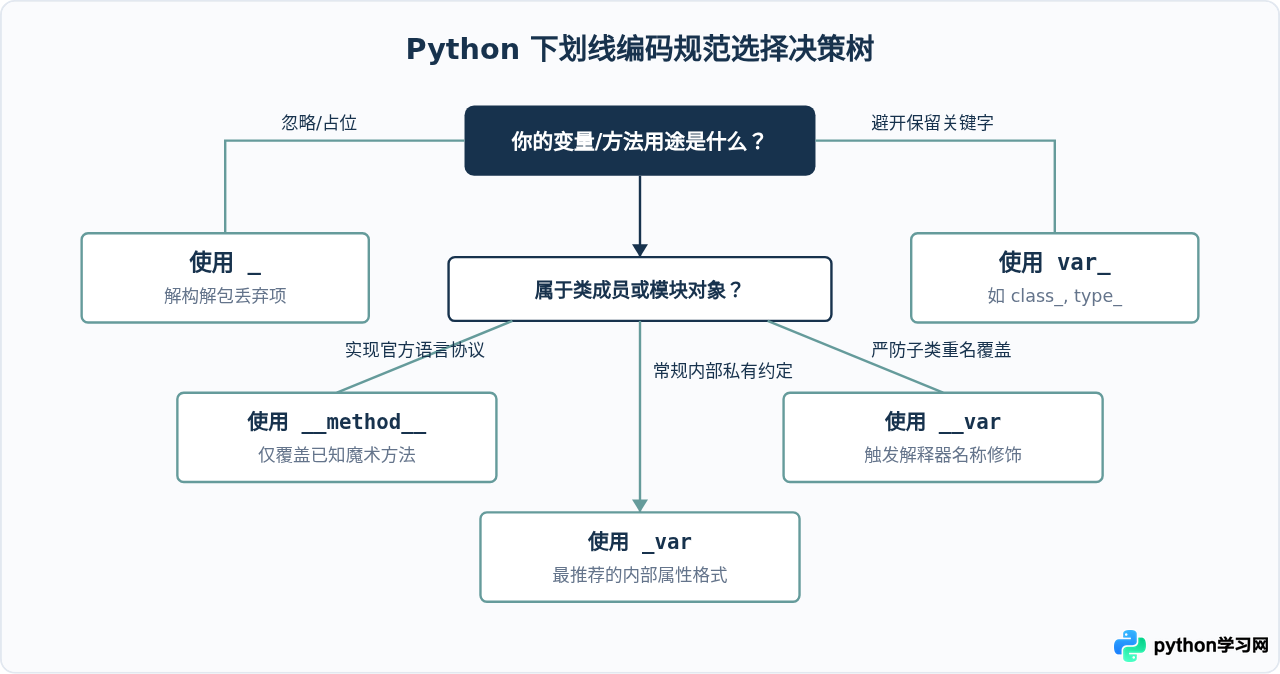
掌握这 5 种下划线形态,不仅能帮助你编写出符合 PEP 8 风格规范的高质量 Python 代码,更能让你在阅读框架底层源码(如 Django、Flask、PyTorch)时,准确领会设计者在接口开放与内部保护之间的架构意图。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









