

LabVIEW调用包含复杂第三方库的Python可执行文件注意事项

在工业自动化与测控系统中,LabVIEW常用于多通道仪器驱动、高速数据采集及界面控制,而深度学习、复杂图像处理与科学运算模型则普遍依托于Python生态(如PyTorch、TensorFlow、OpenCV、SciPy、Pandas)。当工程需要将二者整合时,直接使用LabVIEW官方原生提供的Python Node(Python节点)常面临底层C-Runtime库冲突、32/64位解释器限制及不可控的全局崩溃。将Python脚本及其依赖深度打包为独立的EXE可执行文件,并通过LabVIEW的系统执行节点(System Exec.vi)进行跨进程解耦调用,是工业界保障高可靠性的主流落地方案。本文将从架构设计、PyInstaller打包策略、进程间数据通信与防死锁配置等关键维度,系统阐明具体实施细节与核心注意事项。
一、架构选型:为何摒弃进程内加载而转向独立进程
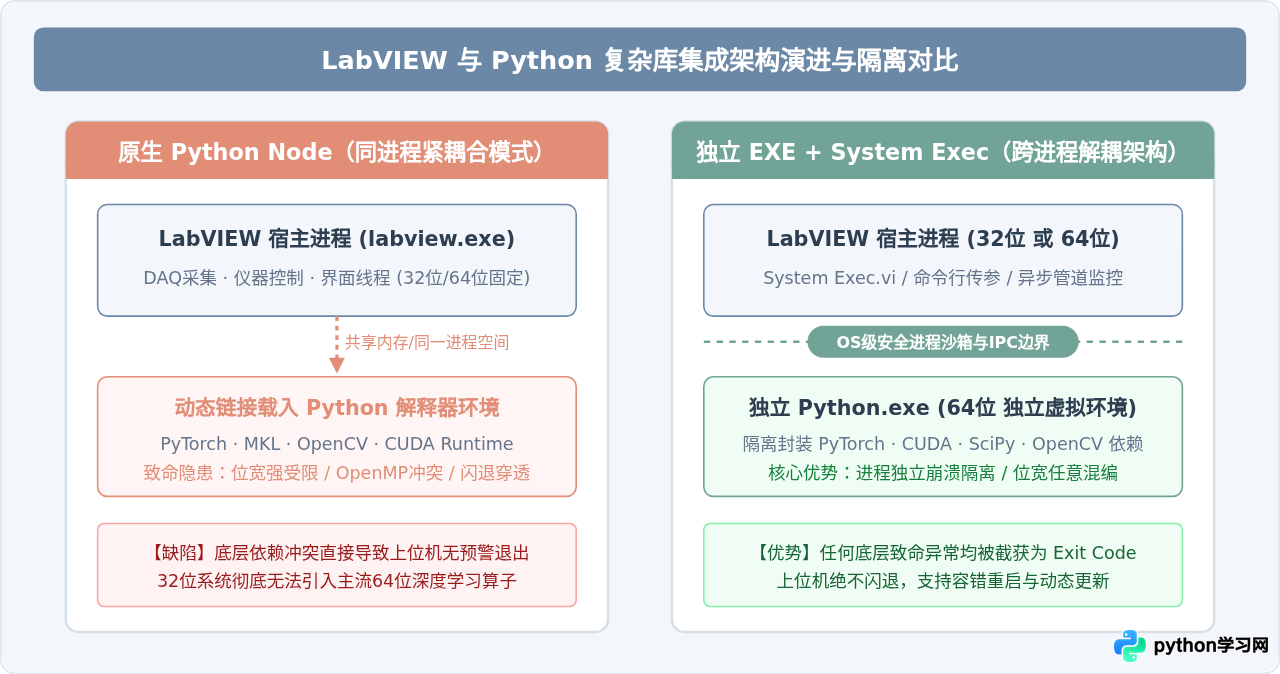
理解为什么选择独立可执行文件,是规划系统架构的前提。LabVIEW提供的原生Python节点本质是在LabVIEW主进程内部加载Python DLL并运行Python C-API。在常规简单数值处理或纯Python算法脚本中,这种方式延迟较低;但在涉及密集科学计算或大型神经网络库时,会出现一系列难以根治的隐患:
- 位宽强绑定限制:许多工业现场仍在使用32位版本的LabVIEW以兼容旧版PCI/PXI驱动,而PyTorch、TensorFlow等大型库基本已全面放弃32位Windows支持。32位进程在内存中无法加载64位DLL,直接断绝了原生Python节点的集成可能。
- 底层C/C++运行时与OpenMP多重初始化冲突:PyTorch与NumPy往往捆绑了Intel MKL和
libiomp5md.dll(OpenMP运行时)。当LabVIEW主进程自身或某些第三方C-DLL也引用了不同版本的运行时库时,在同一进程空间内重复初始化极易触发OMP: Error #15: Initializing libiomp5md.dll, but found libiomp5md.dll already initialized,导致软件崩溃退出。 - 崩溃穿透风险与GIL锁争用:Python的原生C扩展底层一旦发生非法内存访问、CUDA上下文溢出或段错误(Segmentation Fault),会直接导致LabVIEW宿主进程闪退;同时,长时间占用Python GIL会导致LabVIEW界面线程卡死。
通过独立可执行文件启动,操作系统层面天然提供了内存寻址保护、独立的垃圾回收与完整的崩溃隔离机制。即便Python进程因显存不足或算子异常崩溃,LabVIEW仍可正常捕获进程退出代码(Exit Code)并触发重试或降级安全逻辑。
二、打包封装注意事项:PyInstaller 核心配置与避坑策略
利用 PyInstaller 打包包含 PyTorch、TensorFlow 或复杂科学计算库的脚本时,若仅使用默认命令,往往会在实际运行中遭遇启动奇慢、缺少子模块或动态库加载失败等问题。必须遵循以下关键准则:
1. 坚决选用目录模式(--onedir),禁止单文件模式(--onefile)
在涉及大体量深度学习模型时,绝对不要使用 --onefile。其内在机理决定了它不适用于生产级测控系统:
--onefile的本质是一个包含所有压缩包和自解压程序的启动器。在每次执行时,它必须在系统临时目录(C:\Users\<User>\AppData\Local\Temp\_MEIxxxxxx)中解压数百兆乃至数吉字节的 Python 运行时环境、CUDA/C++ 动态链接库及模型资产。- 对于包含完整 PyTorch 和 OpenCV 的程序,每次解压耗时通常在 8 至 25 秒 之间,且频繁的磁盘 I/O 磨损极大;若程序未正常退出,临时文件夹会残留海量孤儿垃圾文件;同时,高频在 Temp 目录下释放并执行二进制 DLL 极易被工业主机的防病毒软件拦截判定为威胁。
- 正确做法:采用
--onedir(默认模式)。编译后生成一个文件夹,包含可执行文件和解耦的所有.dll、.pyd、基础 Python 库及环境文件。部署时将该文件夹整体拷贝至工业工控机固定路径,每次启动仅需加载预存在的 DLL,启动耗时缩短至 0.3 至 1 秒。
2. 隐式依赖与 Hook 配置处理
PyInstaller 通过对代码进行静态语法树(AST)扫描来收集依赖。然而,像 scipy.special、torch.backends、cv2 或 pandas 的内部模块,大量采用 __import__()、importlib 或 C-API 动态导入,静态扫描无法识别,最终导致打包生成的 EXE 运行时抛出 ModuleNotFoundError。
对于含有复杂算子的工程,推荐直接通过 .spec 规格文件或命令行附加 --hidden-import 显式指定模块,示例如下:
pyinstaller --onedir --clean --noconfirm \
  --name "model_infer_service" \
  --hidden-import "torch" \
  --hidden-import "torchvision" \
  --hidden-import "scipy.special" \
  --hidden-import "cv2" \
  --collect-all "torch" \
  --collect-data "torchvision" \
  main_wrapper.py
3. 运行时相对路径与定位陷阱
Python 脚本打包成 EXE 后,当前工作路径(Working Directory)和代码所在路径的判定逻辑发生改变:
- 打包为
--onedir后,可执行文件同级目录才是程序根目录,此时应通过sys.executable获取运行路径,而不能单纯依赖__file__。 - 若代码需要加载外部权重文件(如
weights.pth)或配置文件,必须编写路径兼容函数:
import sys
import os

def get_base_dir():
    """获取真实的应用所在物理目录,兼容源码调试与打包后运行"""
    if getattr(sys, 'frozen', False):
        # 打包后独立运行时的 exe 所在目录
        return os.path.dirname(sys.executable)
    else:
        # 开发源码调试时的脚本目录
        return os.path.dirname(os.path.abspath(__file__))

MODEL_PATH = os.path.join(get_base_dir(), "models", "best_weights.pth")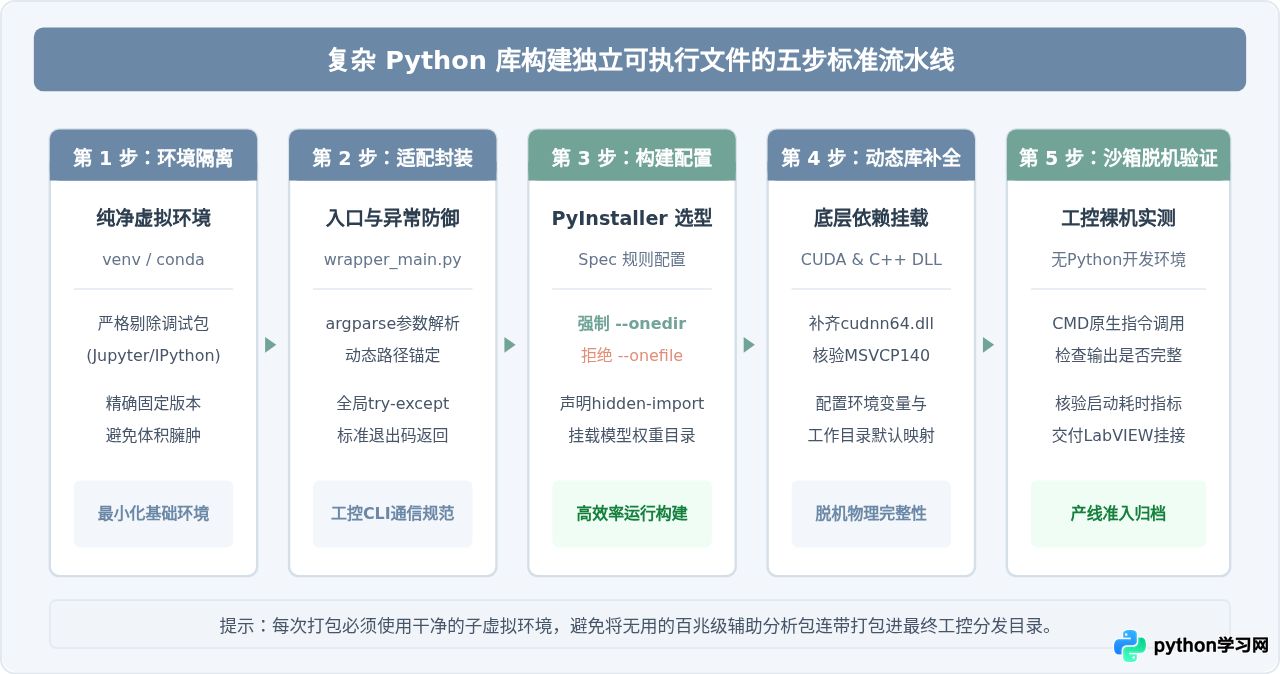
三、LabVIEW 侧调用实现:System Exec.vi 精准配置与避坑
在 LabVIEW 中,调用外部程序最通用的节点是 Connectivity -> Libraries & Executables -> System Exec.vi(执行系统命令)。尽管该节点接口极其简单,但在高可靠性要求的测控场景下,极易踩入以下陷阱:
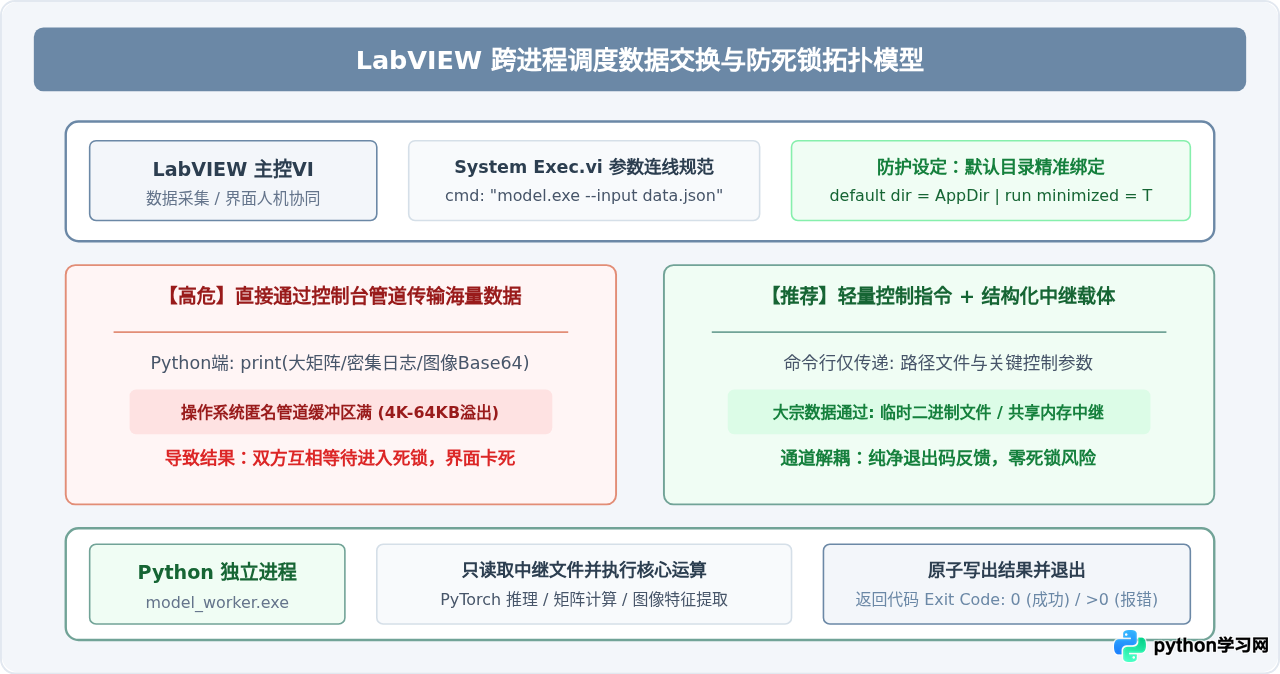
1. 管道缓冲区死锁陷阱(Standard I/O Buffer Deadlock)
在默认配置下,System Exec.vi 的 wait until completion? 输入端通常连线为 True(等待执行完成)。此时,LabVIEW 内部会创建操作系统匿名管道(Anonymous Pipe)来捕获被调用子进程的 stdout(标准输出)和 stderr(标准错误)。
- Windows 操作系统的管道缓冲区大小通常限制在 4KB 至 64KB 之间。
- 如果被调用的 Python 程序包含了大量控制台输出(例如未经关闭的进度条、冗长的神经网络逐层权重信息、调试打印或密集的异常 Traceback),一旦输出数据总量累计填满了这几十千字节的管道缓冲区,操作系统的底层写操作
write()就会发生阻塞,等待读取端消费。 - 然而,LabVIEW 的
System Exec.vi被设置为“等待进程退出后才开始读取输出字符串”。子进程在等 LabVIEW 读取才能继续执行,而 LabVIEW 在等子进程退出才能读取——双方直接陷入永久死锁,前端界面彻底锁死,只能强制结束进程。
防范措施:在进入发布阶段的 Python 程序中,严格抑制无意义的控制台打印;将日志重定向输出至磁盘日志文件(如 logging.FileHandler);或者仅在最后返回极简的 JSON 状态串。
2. 工作目录(default directory)必须显式赋值
System Exec.vi 提供了一个名为 default directory 的可选输入端口。如果该端口留空未连线,子进程继承的工作目录将是宿主 LabVIEW.exe 所在的安装目录(如 C:\Program Files\National Instruments\LabVIEW 2020\),或者调用该 VI 的顶层工程目录。
这会导致 Python 程序内部通过相对路径读取当前目录下的动态库、依赖文件夹或权重文件时,全部报 FileNotFoundError。因此,在 LabVIEW 连线中,必须使用 Current VI's Path 配合 Strip Path 算子计算出 EXE 所在的真实文件夹,并明确接入 default directory。
3. 窗口可见性与静默后台执行
run minimized? 端口应设为 True,避免工业现场主屏上频繁跳出黑色的 cmd.exe 控制台窗口,既能防止操作员误触关闭终端窗口导致后台计算中断,也保证了上位机界面的整洁度。
4. 命令行字符数上限约束
Windows 底层的 CreateProcess API 限制单个命令行字符串的最大长度为 32,767 个字符(若经过 cmd.exe 则限制为 8,191 字符)。
千万不要试图通过命令行参数直接拼接传递海量数据(例如将成千上万个波形采样点或图像灰度矩阵序列化为字符串传入)。命令行仅用于传递控制标志(如配置文件路径、通道ID、执行模式等小型元数据)。
四、数据交换协议设计:高效跨进程通信模式选择
在 LabVIEW 与独立 Python 进程之间传输采集信号、特征值、检测判定结果及高分辨率图像时,通信机制的选择直接关系到吞吐量和稳定性:
1. 模式 A:轻量 JSON 配置文件中继(通用离线批处理推荐)
对于数据吞吐量在数十千字节以内的场景(例如传递数十个配置参数、检测阈值、标定矩阵及统计结果):
- LabVIEW 在调用前,先将采集参数在工控机临时目录写入
task_input.json。 - 通过命令行传入该文件路径:
my_model.exe --config "D:\App\temp\task_input.json"。 - Python 进程完成运算后,将推断结果以紧凑格式写入
task_output.json并安全退出。 - LabVIEW 检测到进程结束后,直接解析
task_output.json并清理临时文件。此方案结构高度自描述、易于断点排查与复现。
2. 模式 B:二进制原始流 / 内存映射(大规模图像及高频波形)
如果每次调用涉及几百万个像素点的工业相机图像(如 2048×2048 灰度图或多通道波形):
- 严禁使用 JSON 或 Base64 格式,否则编解码转换开销将造成严重的 CPU 浪费与内存膨胀。
- 推荐使用原始二进制文件(Raw Binary)或 NumPy
.npy文件存储;LabVIEW 侧使用高效率的“写入二进制文件”函数输出无头文件流,Python 侧直接通过np.fromfile()或np.memmap()毫秒级映射载入。
3. 模式 C:常驻服务化演进(高节拍实时推断的必由之路)
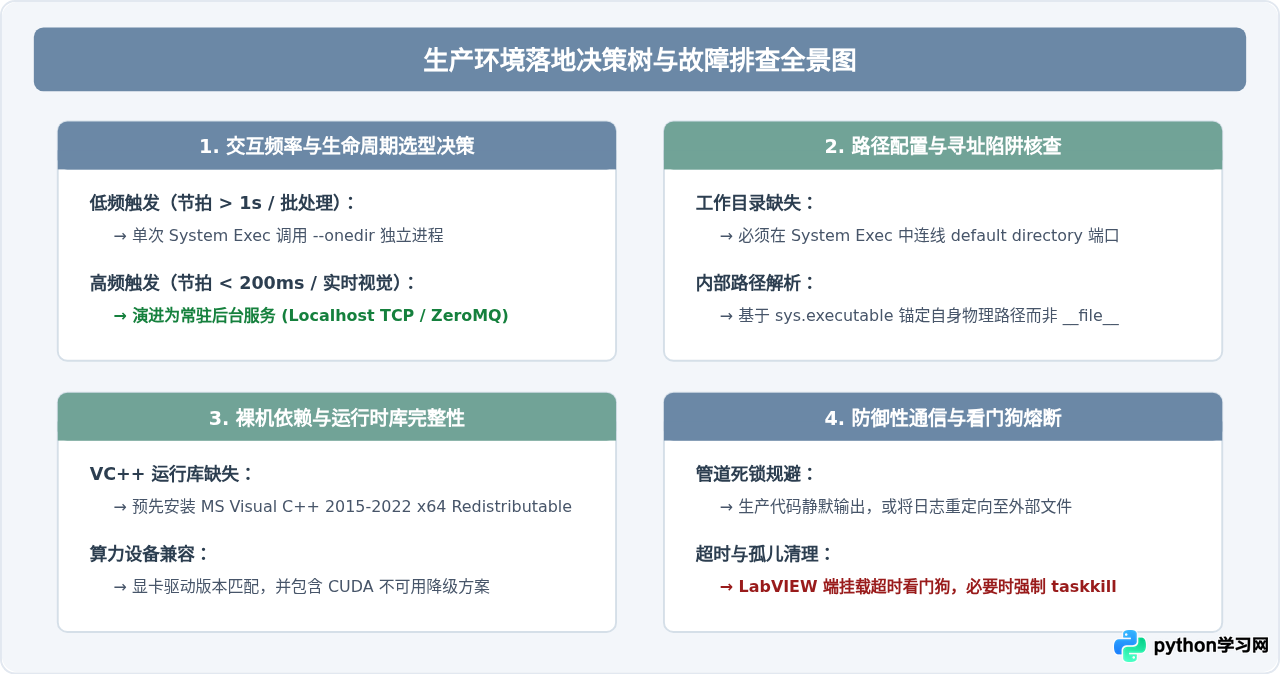
必须明确单次调用可执行文件的性能边界:即便采用 --onedir 模式,Python 解释器的初始化以及载入庞大的 PyTorch/TensorFlow 核心动态库,依然需要 200 至 600 毫秒 的固有开销。
如果自动化产线的检测周期要求在 100 毫秒以内,或者需要高频连续处理图像,则绝不能对每个样本重复启动新进程。此时应调整架构:
- 将 Python 封装为一个常驻后台服务程序(通过 ZeroMQ、轻量 HTTP 或本地命名管道 Named Pipe 监听端口)。
- 在 LabVIEW 上位机启动时,首先通过
System Exec.vi启动该服务(设置wait until completion? = False后台常驻运行)。 - 在产线运行过程中,LabVIEW 通过 TCP 或 ZeroMQ 客户端向本地
127.0.0.1端口发送推断请求并同步获取返回,此时纯计算耗时仅受模型本身约束(如 GPU 推理仅需 5~15ms)。 - 在上位机关闭前,向后台服务发送优雅退出指令或通过终止进程关闭。
五、生产环境部署与故障排查决策总结
完成开发进入现场工控机部署时,需按照以下清单严格核对系统依赖与运行时配置,确保长期无故障运行:
- 操作系统运行库依赖补全:Python 打包的 EXE 依赖特定版本的微软 Visual C++ 运行库。目标工控机若为精简版 Windows 系统,必须提前安装 Visual C++ Redistributable 2015-2022 (x64),否则启动时会出现静默失败或缺少
VCRUNTIME140.dll弹窗。 - CUDA 与显卡驱动版本兼容矩阵:若 Python 库启用了 GPU 加速(如 PyTorch CUDA),目标机器安装的 NVIDIA 显卡驱动版本必须大于等于打包时 PyTorch 编译所要求的最高版本。若工控机未配置独立显卡,Python 脚本必须在入口处加入
torch.cuda.is_available()的自适应回退逻辑,强制降级到 CPU 推理,避免报 CUDA 初始化异常。 - 进程退出码(Exit Code)规范化:在 Python 封装脚本的最外层,使用统一的
try...except块包裹。发生未捕获异常时,不仅要将堆栈写入本地错误日志文件,还必须通过sys.exit(code)返回具体的错误编码(例如 101 代表输入文件不存在,102 代表图像尺寸非法,103 代表显存不足)。LabVIEW 侧通过System Exec.vi的返回代码接线端精确映射故障类型,便于产线维修排查。 - 孤儿进程防范与超时看门狗:在 LabVIEW 侧编写看门狗定时器逻辑。若被调用的可执行文件超出预期时间(如 10 秒)仍未返回,LabVIEW 应主动发起系统指令(如
taskkill /F /IM worker.exe)强制清理残留孤儿进程,避免累积占用工控机内存和显存。
综上所述,在LabVIEW中集成复杂第三方Python库时,以进程隔离为基石、以--onedir目录打包为前提、以文件或共享内存中继替代大管道数据传递,并辅以规范的退出码体系与超时保护机制,能够彻底化解原生节点崩溃穿透与动态库版本冲突的顽疾,为工业自动化设备构筑兼具算法灵活性与工业级稳健性的异构测控系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









