

Python正则表达式group()与groups()的区别及用法

re 模块中,group() 和 groups() 是捕获匹配结果时最常用的两个方法。核心区别在于:group() 用于获取指定索引或名称的单个或多个特定捕获内容(默认无参或传 0 时返回匹配到的整个完整字符串);而 groups() 专门用于一次性以元组(tuple)形式返回所有用括号定义的捕获子组,默认绝不包含索引为 0 的完整匹配项。
一、正则表达式的分组机制与索引规则
要透彻理解 group() 与 groups() 的行为,首先必须清楚正则表达式在 Python 中是如何建立分组索引的。在正则表达式中,通过圆括号 (...) 可以显式定义一个捕获组(Capturing Group)。
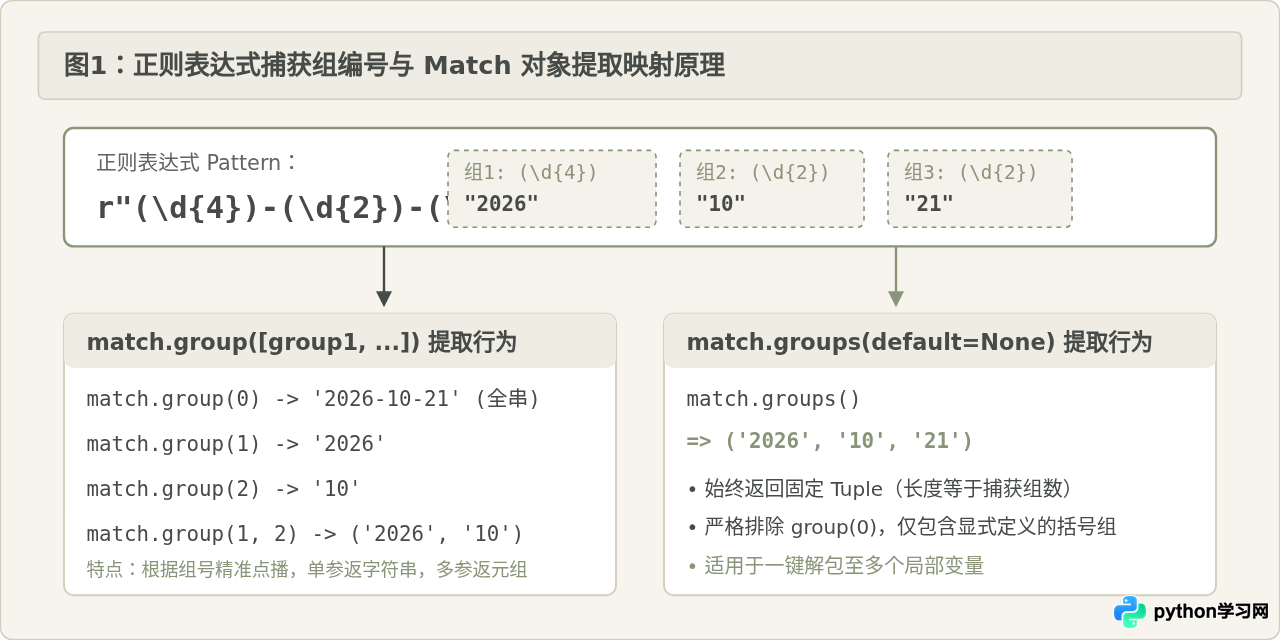
当 re.search()、re.match() 或 re.finditer() 成功匹配文本时,会生成一个 re.Match 对象。该对象在底层维护了一套严格的组编号顺序:
- 组 0(Group 0):代表匹配模式的整个字符串,由系统自动分配,不需要显式在正则表达式中包裹括号。
- 组 1、2、3...(Group 1+):从正则表达式文本的左向右遍历,以每个左括号
(出现的物理顺序依次递增分配组号。 - 非捕获组
(?:...):仅用于改变操作符优先级或组织子模式,不参与编号,也不会被group()索引或出现在groups()的返回结果中。
二、group() 的具体用法与常见场景
group() 方法是 re.Match 对象中最常用的提取方法,其主要特点是按需指定分组标识。
1. 默认无参调用:返回完整匹配串
当不传任何参数时,match.group() 等价于 match.group(0),返回符合正则表达式整体模式的完整字符串。
import re

text = "用户ID: 10842, 权限等级: Admin"
pattern = r"用户ID:\s*(\d+),\s*权限等级:\s*(\w+)"
match = re.search(pattern, text)

if match:
    # 示例输出:用户ID: 10842, 权限等级: Admin
    print(match.group())
    # 示例输出:用户ID: 10842, 权限等级: Admin
    print(match.group(0))
2. 传入单个整数:返回对应捕获组的字符串
传入合法组号后,group(n) 会直接返回该捕获组匹配到的字符串文本;若该组参与了匹配但匹配内容为空字符串,则返回 ""。
# 获取指定分组
user_id = match.group(1)      # 示例输出: '10842'
role = match.group(2)         # 示例输出: 'Admin'
print(f"用户: {user_id}, 角色: {role}")
3. 传入多个参数:返回由提取项组成的元组
许多开发者以为 group() 每次只能传一个数字。实际上,group() 允许传入多个组编号或组名,此时它会依次读取这些分组并将它们打包为一个元组(Tuple)返回。
# 同时传入多个索引
sub_tuple = match.group(1, 2)
# 示例输出: ('10842', 'Admin')
print(sub_tuple)

# 调换顺序提取
rev_tuple = match.group(2, 1)
# 示例输出: ('Admin', '10842')
print(rev_tuple)
4. 配合命名捕获组使用:传字符串组名
使用 (?P<name>...) 定义命名捕获组后,group() 可以直接使用有明确业务语义的字符串名称进行提取,增强代码可读性与维护性。
named_pattern = r"用户ID:\s*(?P<uid>\d+),\s*权限等级:\s*(?P<role>\w+)"
m = re.search(named_pattern, text)
if m:
    # 示例输出: '10842'
    print(m.group("uid"))
    # 示例输出: 'Admin'
    print(m.group("role"))
三、groups() 的具体用法与参数特性
与 group() 的针对性提取不同,groups() 方法的设计初衷是为了整体导出所有的捕获结果。
1. 一次性获取所有捕获组元组
groups() 不需要传入分组索引,直接执行即可拿到从组 1 开始至最后一组的所有数据元组。最常见的用法是与 Python 的元组解包语法配合使用:
import re

date_str = "Release: 2026-10-21"
m = re.search(r"(\d{4})-(\d{2})-(\d{2})", date_str)

if m:
    # 自动解包所有捕获组
    year, month, day = m.groups()
    # 示例输出: 2026 年 10 月 21 日
    print(f"{year} 年 {month} 月 {day} 日")
2. default 参数:安全处理未触发的可选组
当正则表达式包含可选分支或可选捕获组(例如 (\d+)?)时,如果文本中并未出现对应内容,该分组仍会计入编号,但其值在 Python 内部被置为 None。
groups() 提供了一个极其关键的参数 default(默认值为 None)。传入自定义兜底值后,所有未匹配到的子组都会自动替换为该值,极大简化后续空值判断逻辑。
# 模式中区域编码 (\d{3}-)? 为可选捕获组
phone_pattern = r"(?:Tel:\s*)?(\d{3}-)?(\d{8})"

# 案例 A:带区号
m1 = re.search(phone_pattern, "Tel: 010-88889999")
# 示例输出: ('010-', '88889999')
print(m1.groups())

# 案例 B:无区号,使用默认参数
m2 = re.search(phone_pattern, "Tel: 88889999")
# 示例输出: (None, '88889999')
print(m2.groups())

# 案例 C:使用 default 参数兜底替换 None
# 示例输出: ('000-', '88889999')
print(m2.groups(default="000-"))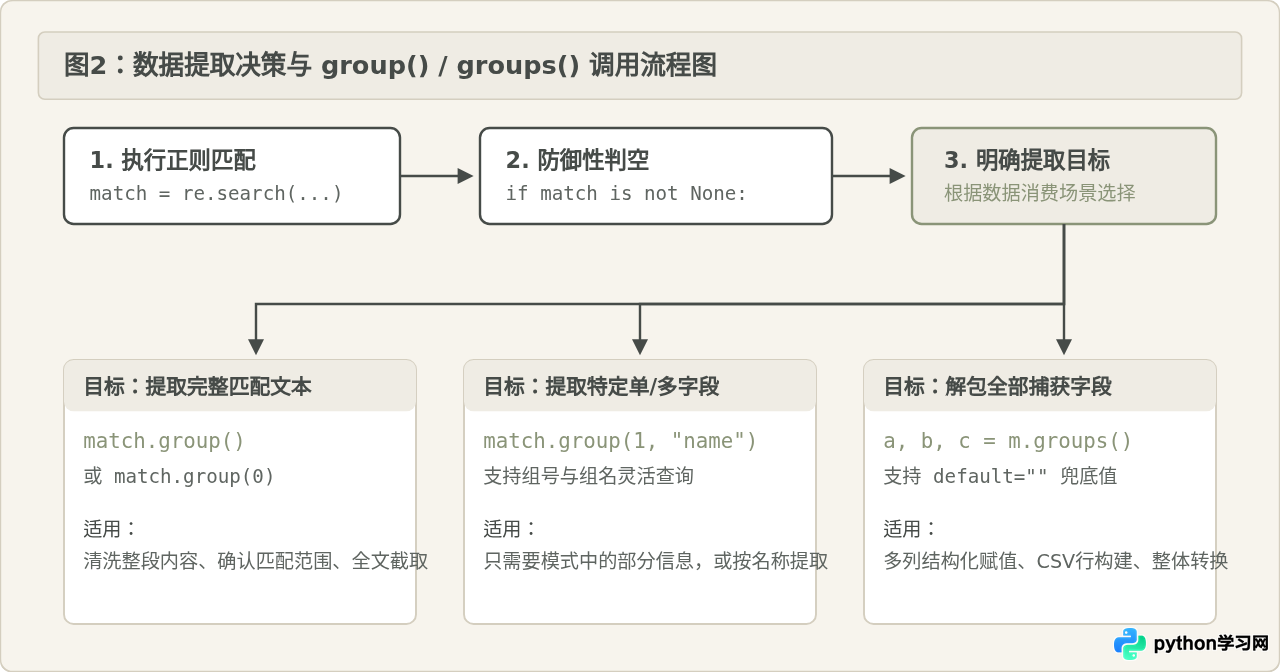
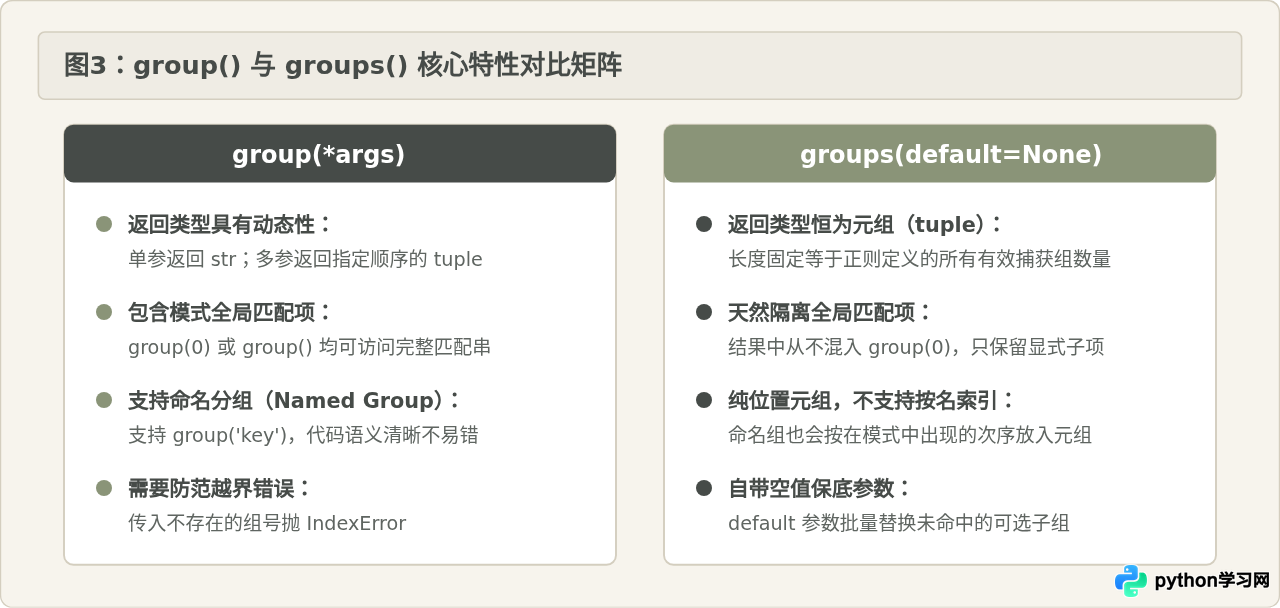
四、group() 与 groups() 核心区别横向对比
为了让差异一目了然,下表汇总了两者的主要技术指标与行为特征:
| 对比维度 | group(*args) | groups(default=None) |
|---|---|---|
| 默认返回类型 | 字符串(str) |
元组(tuple) |
| 是否包含组 0 | 包含(默认或传 0 即为组 0 全文) | 绝不包含(仅包含显式定义的捕获组) |
| 参数接受规则 | 接受 0 到多个位置参数(整数)或关键字组名(字符串) | 不接受索引参数;仅接受一个命名参数 default |
| 多参数行为 | 传入 N 个组参数时,打包返回包含 N 个元素的元组 | 不适用(无多参调用) |
| 未命中可选组处理 | 该组对应返回 None,无内置替换参数 |
未命中位置由 default 参数统一替换 |
| 索引越界表现 | 传入超出范围的组号直接抛出 IndexError |
内部自动按实际捕获组生成元组,绝不抛越界异常 |
| 主要适用场景 | 提取整串、定位单个字段、根据命名组提取 | 批量提取所有字段、配合 Python 元组解包语法 |
五、常见混淆认识与细节辨析
辨析一:“groups() 是不是就是获取全部 group() 的简写?”
这种理解在部分场景下看似成立,但存在关键偏差。有开发者认为 groups() 等同于把所有可能用到的 group(n) 汇总在一起,因此以为 groups()[0] 就是 group(0)。
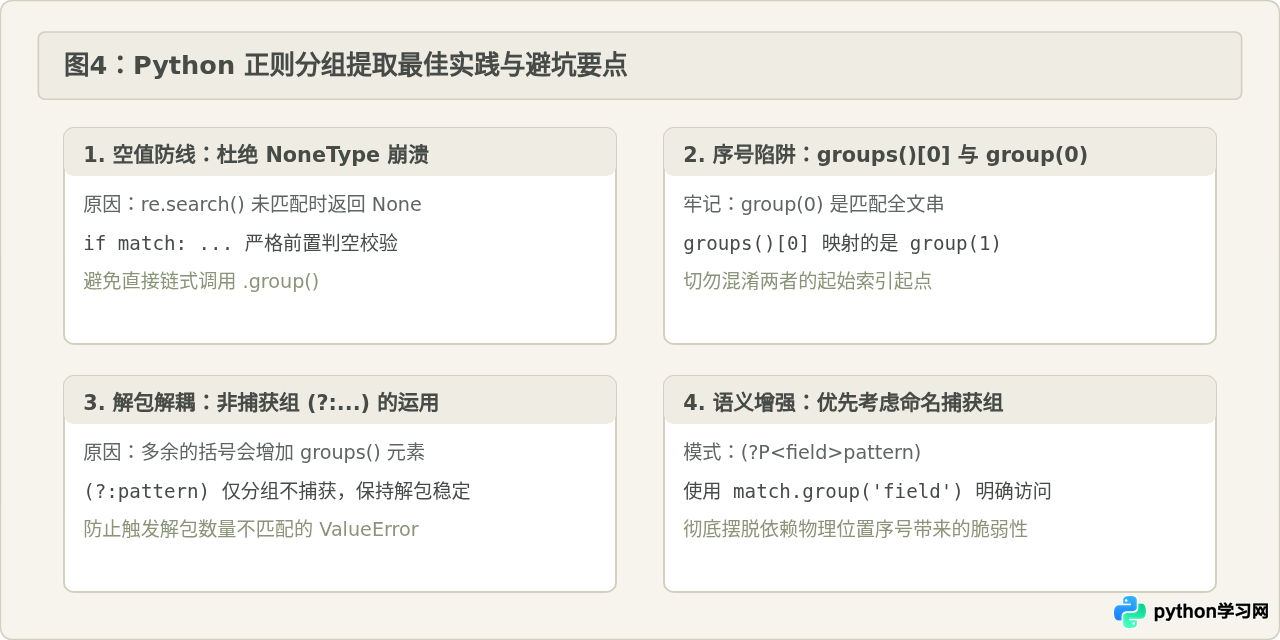
修正说明:groups() 生成的元组中,第一个元素 groups()[0] 实际上对应的是 group(1),而 groups()[1] 对应 group(2)。groups() 会直接把代表整个匹配模式的 group(0) 过滤掉。如果把 groups()[0] 当成全局匹配内容,会导致严重的索引错位。
辨析二:“group() 只能返回字符串,groups() 才能返回元组?”
这种说法并不严谨。当只给 group() 传递 0 个或 1 个参数时,它的确返回字符串(或未命中的 None)。但只要给 group() 传入两个及以上的参数(例如 group(1, 2)),它同样会返回一个元组。
两者的本质区别不在于“能否返回元组”,而在于提取控制权与作用域:group(*args) 是定制投影,由调用者指定提取哪些列以及排列顺序;groups() 是完整导出,固定输出所有捕获列。
六、生产环境常见错误与防御性写法
1. 防范未命中导致的 AttributeError
当正则未能成功匹配文本时,re.search() 返回 None。如果此时直接调用 .group() 或 .groups(),会触发 AttributeError: 'NoneType' object has no attribute 'group'。
# 错误示范:未作判空直接链式调用
# result = re.search(r"(\d+)", "no numbers here").group() # 触发 AttributeError

# 规范示范:条件判断后再提取
match_obj = re.search(r"(\d+)", "no numbers here")
if match_obj:
    result = match_obj.group(1)
else:
    result = ""  # 安全降级
2. 防范解包数量不匹配的 ValueError
在使用 a, b = match.groups() 进行解包时,如果后续重构正则表达式添加或移除了一个带括号的子组,解包操作就会抛出 ValueError: too many values to unpack 或 not enough values to unpack。
(?:...);若提取项较多且未来可能变更正则结构,推荐使用 groupdict() 或显式通过命名组提取。
七、总结
总结来说,group() 和 groups() 各司其职:
- 如果需要整串匹配结果、或者精准获取某一个特定编号/名称的字段,选择
group()(或group(n)、group("name"))。 - 如果需要将正则表达式里的各个部分一次性完整解包到多个变量中,或者需要借助
default参数对未命中的可选子组进行保底赋值,选择groups()。
在工程开发中,结合 if match: 严格判空,并在不需提取的分组上主动使用 (?:...) 非捕获组,即可写出健壮、清晰且高效的正则处理代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









