

Python怎么使用jieba库进行中文分词

在中文文本处理任务中,汉字之间不像英文那样天然包含空格分隔,因此词语切分是开展文本挖掘、情感分析与信息检索的先决步骤。在 Python 生态中,jieba 凭借轻量、开箱即用、分词效率高以及对新词有良好发现能力,成为最主流的中文分词工具。本文将完整介绍 jieba 库的安装配置、核心分词模式、自定义词典拓展及停用词清洗的规范操作流程。
一、环境准备与基础调用流水线
在终端使用 pip 工具即可完成 jieba 的安装,该库属于纯 Python 实现,不依赖复杂的外部 C/C++ 编译环境:
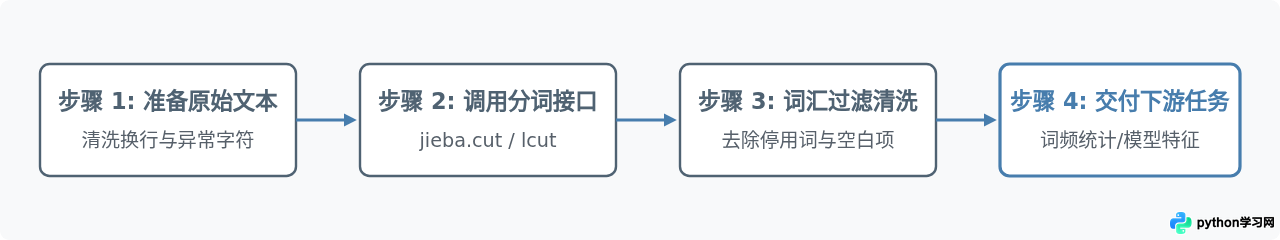
pip install jieba安装完成后,在 Python 脚本中通过 import jieba 导入。处理一段文本的基本逻辑包括四个环节:读取原始字符串、调用切分接口、按需过滤特殊标记,最终输出符合业务要求的词汇序列。
二、三种核心分词模式的具体用法与对比
jieba 提供了三种主要切分模式,适应不同的业务场景:
- 精确模式(默认):试图将句子最精确地切开,适合文本分析、特征提取与统计建模。
- 全模式:把句子中所有可以成词的词语都扫描出来,速度较快,但存在歧义和冗余,不能直接解决歧义问题。
- 搜索引擎模式:在精确模式的基础上,对较长的词语再次进行粒度切分,以提高搜索引擎召回率。
在接口选择上,jieba.cut 返回一个 Python 生成器(Generator),节约内存消耗;如果需要直接获取切分后的列表,推荐直接使用 jieba.lcut 系列函数,避免显式调用 list() 转换。
import jieba

text = "我在北京清华大学计算机系学习"

# 1. 精确模式 (默认 cut_all=False)
seg_exact = jieba.lcut(text)
print("精确模式:", seg_exact)

# 2. 全模式 (设置 cut_all=True)
seg_all = jieba.lcut(text, cut_all=True)
print("全模式:  ", seg_all)

# 3. 搜索引擎模式 (调用 lcut_for_search)
seg_search = jieba.lcut_for_search(text)
print("搜索模式:", seg_search)
上述代码的实际切分输出如下:
精确模式: ['我', '在', '北京', '清华大学', '计算机系', '学习']
全模式:   ['我', '在', '北京', '清华', '清华大学', '华大', '大学', '计算', '计算机', '计算机系', '算机', '系', '学习']
搜索模式: ['我', '在', '北京', '清华', '华大', '大学', '清华大学', '计算', '算机', '计算机', '计算机系', '学习']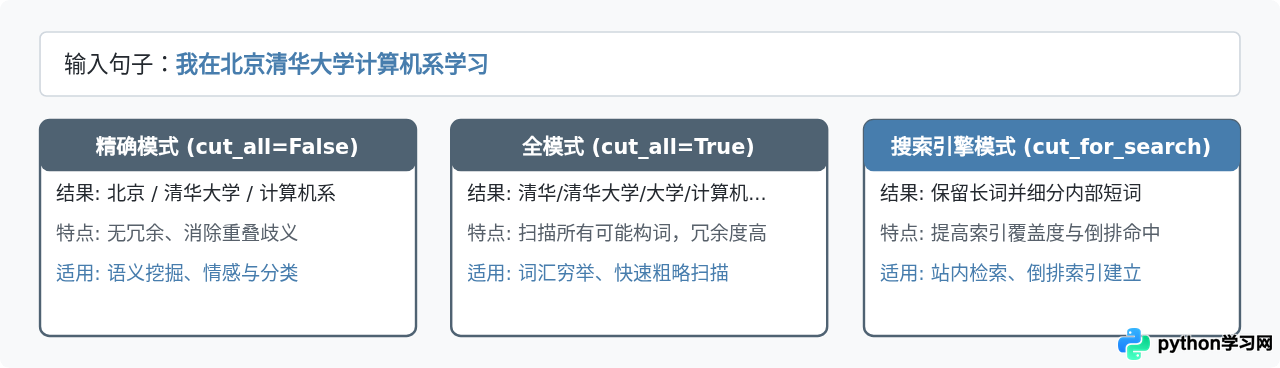
三、自定义词典与动态词频调整
默认词库无法预先覆盖所有专业术语、公司名或网络新词。例如处理“张小龙是微信之父”或“云计算中心建设”时,特定复合名词容易被切碎。jieba 提供了静态外部词典加载和动态词频干预两种解决方式。
1. 加载外部词典文件
通过 jieba.load_userdict(file_path) 可以载入自定义文本词典。词典文件要求为 UTF-8 编码,每行包含一个词条,格式如下(词频与词性为可选项,用空格隔开):
云计算中心 1000 n
微信之父 800 n
大语言模型 1500 n
2. 动态添加、删除与调节词频
如果不需要维护外部文件,也可以在代码中实时注册新词,或通过 suggest_freq 调节词频以强制结合或拆分词语:
import jieba

text = "李三三是一名优秀的云计算工程师"

# 默认切分可能会拆开姓名与专有名词
print("原始切分:", jieba.lcut(text))

# 动态添加新词
jieba.add_word("李三三")
jieba.add_word("云计算工程师")
print("添加词后:", jieba.lcut(text))

# 如果需要拆开误合的词,调小词频或指定切分依据
text_split = "如果放到post请求里"
# 强制让 jieba 将“中”或某个复合词拆分
jieba.suggest_freq(("中", "将"), tune=True)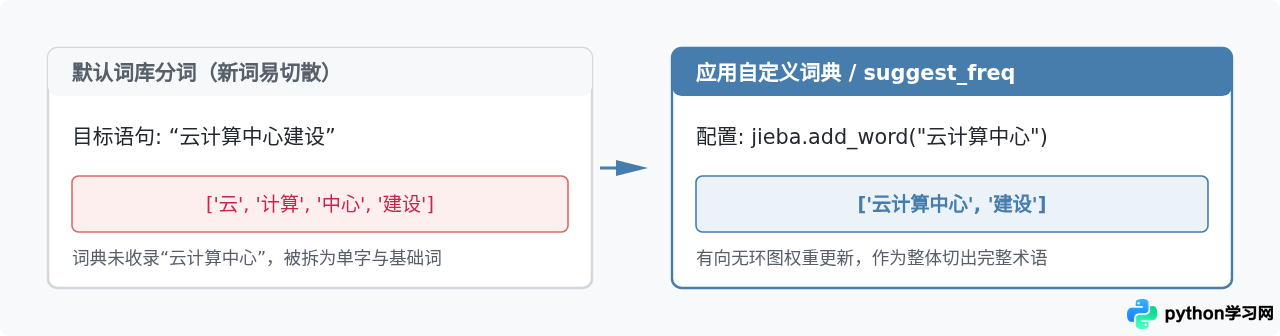
四、分词后处理:停用词过滤与标点清洗
分词输出通常夹杂标点符号、空格及诸如“的”、“了”、“在”等对主题表征无实际意义的高频虚词。实际工程中,需结合停用词表(Stopwords)进行列表过滤:
import jieba

# 准备停用词集合(通常由本地 stopwords.txt 载入)
stopwords = {"的", "了", "在", "是", "我", ",", "。"}

text = "我在北京清华大学计算机系学习,收获了很多知识。"
words = jieba.lcut(text)

# 使用列表推导式清洗无用词与空格
filtered_words = [
    word.strip() for word in words
    if word.strip() and word not in stopwords
]

print("过滤后结果:", filtered_words)
# 输出: ['北京', '清华大学', '计算机系', '学习', '收获', '很多', '知识']
五、常用进阶模块:词性标注与关键词提取
除了基础切词,jieba 还内置了两个开箱即用的高频工具模块:
- 词性标注(posseg 模块):在分词的同时标注每个词的词性,如名词
n、动词v、形容词a等。 - 关键词提取(analyse 模块):支持基于 TF-IDF 算法和 TextRank 算法提取文档核心关键词,并支持限定指定词性。
import jieba.posseg as pseg
import jieba.analyse

text = "自然语言处理是计算机科学领域与人工智能领域中的一个重要方向。"

# 1. 词性标注
words_flags = pseg.lcut(text)
print("词性标注:")
for w in words_flags[:5]:
    print(f"{w.word} ({w.flag})", end=" ")
print()

# 2. 基于 TF-IDF 提取关键词 (前3个)
keywords = jieba.analyse.extract_tags(text, topK=3, withWeight=False)
print("TF-IDF 关键词:", keywords)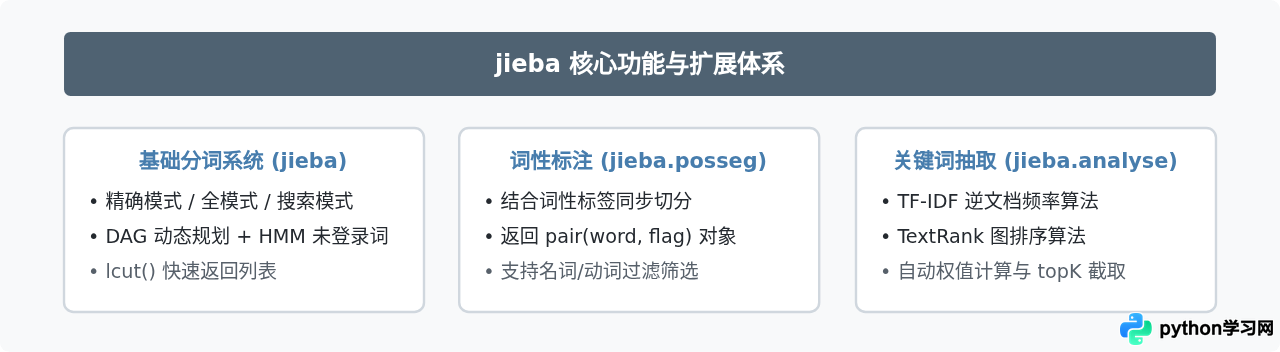
六、工程实践中的注意事项
冷启动延迟说明: jieba 首次调用 cut 或 lcut 时,会在后台自动构建前缀词典的前缀树并缓存至临时目录(.cache 文件)。因此首次调用会有数百毫秒的加载延迟,随后的连续切分将达到每秒数十万字的极高吞吐速度。在服务部署场景下,建议在应用启动时显式调用 jieba.initialize() 完成预热。
- 多进程分词加速: 在 Linux 或 macOS 环境下处理海量数据时,可调用
jieba.enable_parallel(4)开启并行分词(基于 Python multiprocessing),处理完毕后调用jieba.disable_parallel()释放资源。注意该特性不支持 Windows 原生环境。 - 英文与符号边界: 连续英文与数字默认会被整体切出,如果需要细化对混合文本的处理,应在分词前通过正则表达式剔除多余特殊符号。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









