

Python深拷贝遇到循环引用报错怎么办?识别与处理机制

在 Python 中使用 copy.deepcopy 处理复杂嵌套对象时,如果对象间存在相互引用的环状链路,开发者经常会遭遇 RecursionError: maximum recursion depth exceeded 异常。许多人误以为 Python 标准库不支持带环数据结构的深拷贝,但事实上标准库内部早已内置了基于内存地址备忘录(memo)的防环机制。本文将直击报错根因,拆解原生机制失效的核心场景,提供定位循环引用拓扑的排查步骤,并详细讲解规范实现自定义拷贝与架构解耦的完整处理方案。
一、根因剖析:原生 deepcopy 已经能防环,为什么还会报错?
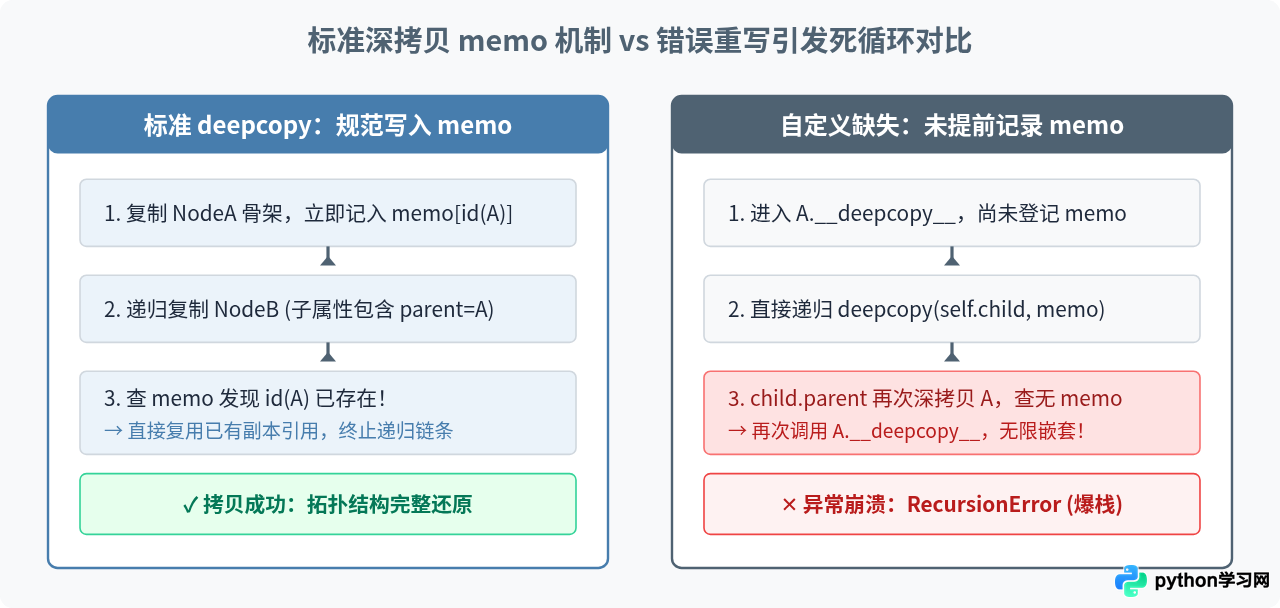
Python 标准库 copy 模块对循环引用有一套完备的防御体系。在调用 copy.deepcopy(x, memo=None) 时,函数内部会维护一个名为 memo 的字典。该字典以对象的内存标识符 id(obj) 作为键,以已创建的新拷贝副本作为值。当遍历递归到达某个已经被拷贝过的节点时,deepcopy 会直接从 memo 中取出已有副本返回,从而阻断递归死循环。
既然原生机制支持循环引用,为什么业务代码中依然频频报错?排查实际案例,主要集中在以下三个典型诱因:
- 诱因一:自定义类实现了
__deepcopy__,但未按规范写入memo。这是最常见的致错原因。开发者在重写__deepcopy__(self, memo)时,往往直接遍历属性调用copy.deepcopy(attr, memo),却遗漏了在递归子节点前将自身实例写入memo[id(self)] = new_instance。一旦子节点反向引用父节点,就会再次触发父节点的__deepcopy__,瞬间击穿调用栈。 - 诱因二:重写了
__getattr__或__getattribute__拦截属性查找。在深拷贝过程中,copy模块会探测对象的协议支持情况(例如查询__deepcopy__、__getstate__、__setstate__)。若动态属性拦截器未对私有魔术方法进行防御性放行,会把未定义的元属性重定向为新对象的生成或循环属性访问,从而引发无限递归。 - 诱因三:对象树嵌套层级本身极深且伴随密集循环引用。在大型图形数据或 AST 语法树中,即便正确使用
memo,若单纯依赖递归实现,由于 Python 默认递归深度上限较小(通常为 1000),也会在未完成备忘录收敛前耗尽栈帧。
二、识别与排查:如何定位报错点与循环引用拓扑?
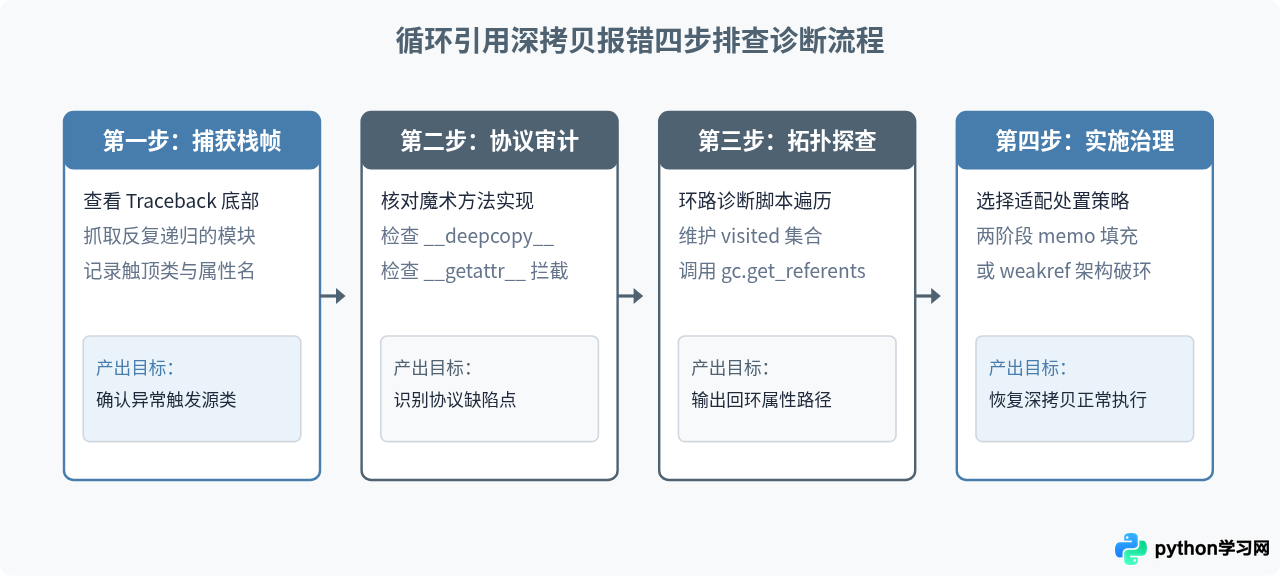
当系统抛出 RecursionError 时,终端输出的调用栈往往包含数百行重复的 copy.py 内部函数调用。如果盲目翻阅代码,极难确定具体是哪个属性构成了闭环。应按照以下四个标准化步骤进行结构化定位:
- 提取末端调用帧与类标识:翻到 Traceback 的最后数十行,观察
_deepcopy_dict、_deepcopy_list或具体的__deepcopy__行号。定位到当前正在尝试克隆的具体业务类(例如GraphNode或TreeNode)。 - 检查该类是否重写了底层协议:确认目标类中是否存在自定义的
__deepcopy__、__getattr__、__setattr__或__reduce__。若有自定义实现,重点检查memo字典是否参与透传。 - 使用有向图遍历脚本探查环路:在测试环境中编写轻量遍历函数,记录已访问对象的
id,输出存在相互依赖的对象链。 - 利用
gc模块回溯引用路径:Python 内置的垃圾回收模块gc能够追踪对象的反向引用。通过gc.get_referents(obj)与gc.get_referrers(obj),可以直接查出是谁强持有着当前节点。
下面是一个实用的循环引用诊断辅助函数。它使用广度优先搜索探测对象属性中的环路,能够在不引发栈溢出的前提下明确打印出存在回环的节点路径:
def detect_cycles(root_obj):
    visited = set()
    stack = [(root_obj, [type(root_obj).__name__])]

    while stack:
        current, path = stack.pop()
        current_id = id(current)

        if current_id in visited:
            print(f"[发现引用环] 路径: {' -> '.join(path)}")
            continue
        visited.add(current_id)

        # 仅针对具有 __dict__ 的常规实例进行属性探测
        if hasattr(current, "__dict__"):
            for attr_name, attr_val in vars(current).items():
                if isinstance(attr_val, (list, tuple, set)):
                    for idx, item in enumerate(attr_val):
                        if hasattr(item, "__dict__"):
                            stack.append((item, path + [f"{attr_name}[{idx}]:{type(item).__name__}"]))
                elif hasattr(attr_val, "__dict__"):
                    stack.append((attr_val, path + [f"{attr_name}:{type(attr_val).__name__}"]))
三、处理机制与修复实操
识别出问题所在后,根据业务结构的不同,可以采取不同的处理方案。最核心的原则是:确保在复制子图前让自身实例占位进入 memo 字典,或者从设计上阻断强引用环的产生。
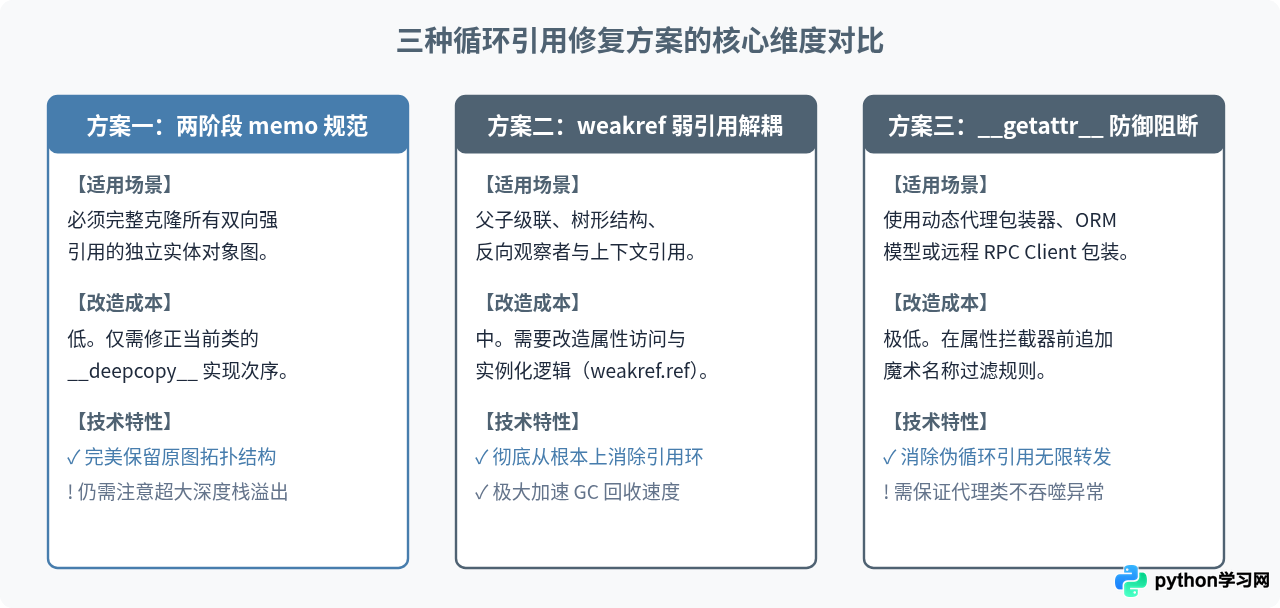
1. 规范实现自定义 __deepcopy__ 的“两阶段填充原则”
重写 __deepcopy__ 时,必须严格遵循“先分配占位骨架并记录 memo,后递归拷贝属性”的次序,切忌在构造函数参数中直接嵌套递归拷贝子属性。示例代码如下:
import copy

class TreeNode:
    def __init__(self, name):
        self.name = name
        self.parent = None
        self.children = []

    def add_child(self, child):
        child.parent = self
        self.children.append(child)

    def __deepcopy__(self, memo):
        # 步骤 1:若 memo 中已存在当前对象的拷贝,直接返回,阻断递归
        if id(self) in memo:
            return memo[id(self)]

        # 步骤 2:使用 __new__ 创建一个未执行 __init__ 的空壳实例
        cls = self.__class__
        dup = cls.__new__(cls)

        # 步骤 3:极其关键!在递归处理任何子属性前,立即将新实例写入 memo
        memo[id(self)] = dup

        # 步骤 4:显式拷贝属性,确保 memo 持续向下透传
        dup.name = copy.deepcopy(self.name, memo)
        dup.parent = copy.deepcopy(self.parent, memo)
        dup.children = copy.deepcopy(self.children, memo)

return dupcls.__new__(cls) 可以避免重新执行 __init__。若在 __init__ 中包含依赖其他节点的计算逻辑,在深拷贝时极易产生不一致状态或副作用。
2. 安全防护 __getattr__ 动态属性拦截
如果在类中实现了 __getattr__,必须对 Python 内部元方法进行防御性放行。当系统查找 __deepcopy__、__getstate__ 等特殊属性时,若当前类并未主动提供,应直接抛出 AttributeError,而非返回默认兜底对象或触发进一步代理:
class SafeDynamicProxy:
    def __init__(self, target):
        self._target = target

    def __getattr__(self, name):
        # 防御性放行:若为魔术属性,必须拒绝拦截,抛出 AttributeError
        if name.startswith("__") and name.endswith("__"):
            raise AttributeError(f"'{type(self).__name__}' object has no attribute '{name}'")
        return getattr(self._target, name)
3. 架构解耦:改用 weakref 破除强引用闭环
在树形或图型结构中,“父指向子”通常是所有权关系,“子指向父”则往往只是反向引用。如果双向都保持强引用,不仅深拷贝容易出错,还会增加垃圾回收(GC)的代际扫描负担。通过 weakref.ref 或 weakref.proxy 将反向引用改造为弱引用,不仅能天然解除深拷贝的递归死锁,还能保证内存即时释放。
四、何时能调递归限制?何时绝对不能调?
在面对 RecursionError 时,不少开发者会尝试通过 sys.setrecursionlimit(5000) 来简单绕过报错。对这一操作必须保持清醒认知:
- 绝对禁止调大的情况:真正的逻辑死循环。如果是因为
memo遗漏登记或属性穿透导致的死循环,增大递归上限没有任何效果,最终只会导致底层 CPython 解释器耗尽 C 语言线程栈(Segmentation Fault 核心转储崩溃),连 Python 层面的异常都无法捕获。 - 允许谨慎调大的情况:超长线性链表或深层次语法树。例如链表长度达到 2000 个节点,并不存在逻辑死循环,仅仅是因为 Python 默认的 1000 栈深度阈值过于保守。此时适度调大递归限制(如 3000)并结合测试是可行的,但长期来看,将递归遍历重构为基于显式堆栈(迭代循环)的深拷贝才是更稳健的工程实践。
五、测试验证与全流程总结
修复完成后,应针对循环引用结构编写明确的自动化测试用例,从以下三点进行断言校验:
- 深拷贝成功执行:调用
copy.deepcopy(root)不抛出任何异常。 - 完全独立的内存空间:原对象与新对象的
id必须不同,即assert root is not cloned_root且assert root.child is not cloned_root.child。 - 引用拓扑正确还原:新对象内部的环路必须指向新对象自身,绝不能指向旧对象。即
assert cloned_root.child.parent is cloned_root。
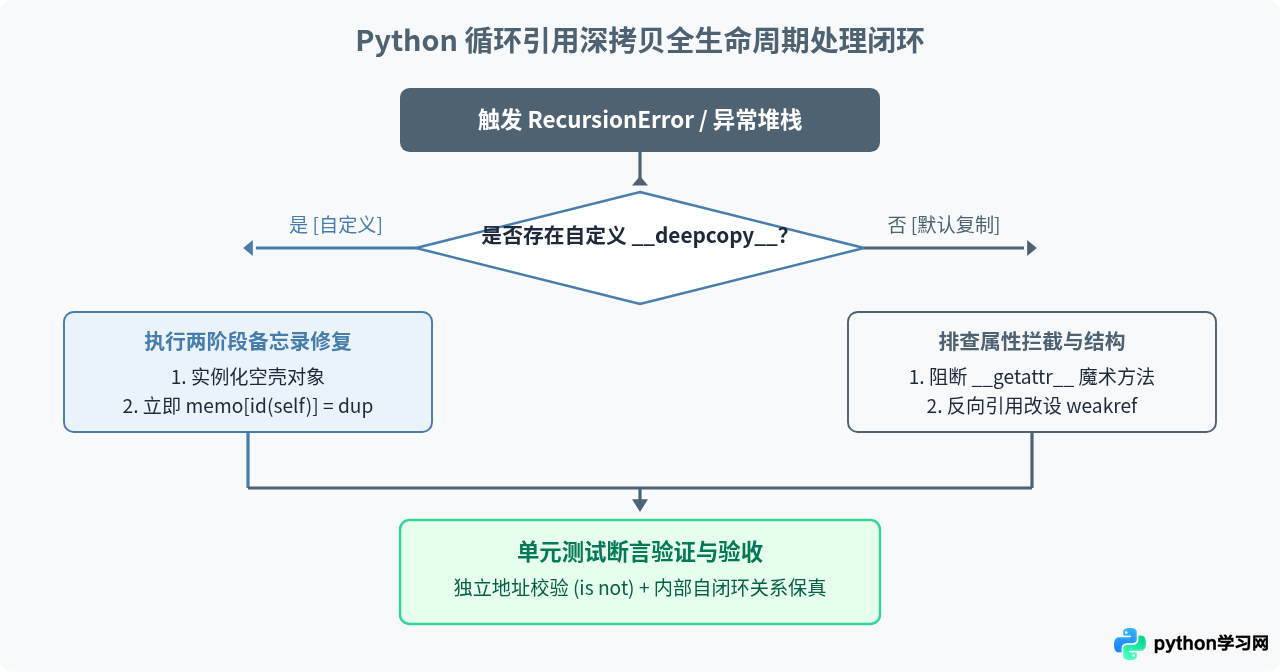
综上所述,Python 面对循环引用并不是束手无策,其底层设计完全具备防环能力。业务中遇到递归报错时,应当摒弃“盲目增大递归上限”的治标做法,从识别异常栈帧入手,落实“两阶段 memo 填充原则”,并在架构层面合理引入弱引用。这样既能保证深拷贝行为的正确性与独立性,又能保障应用运行期内存的健康稳定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









