

Python有序和无序数据结构怎么选

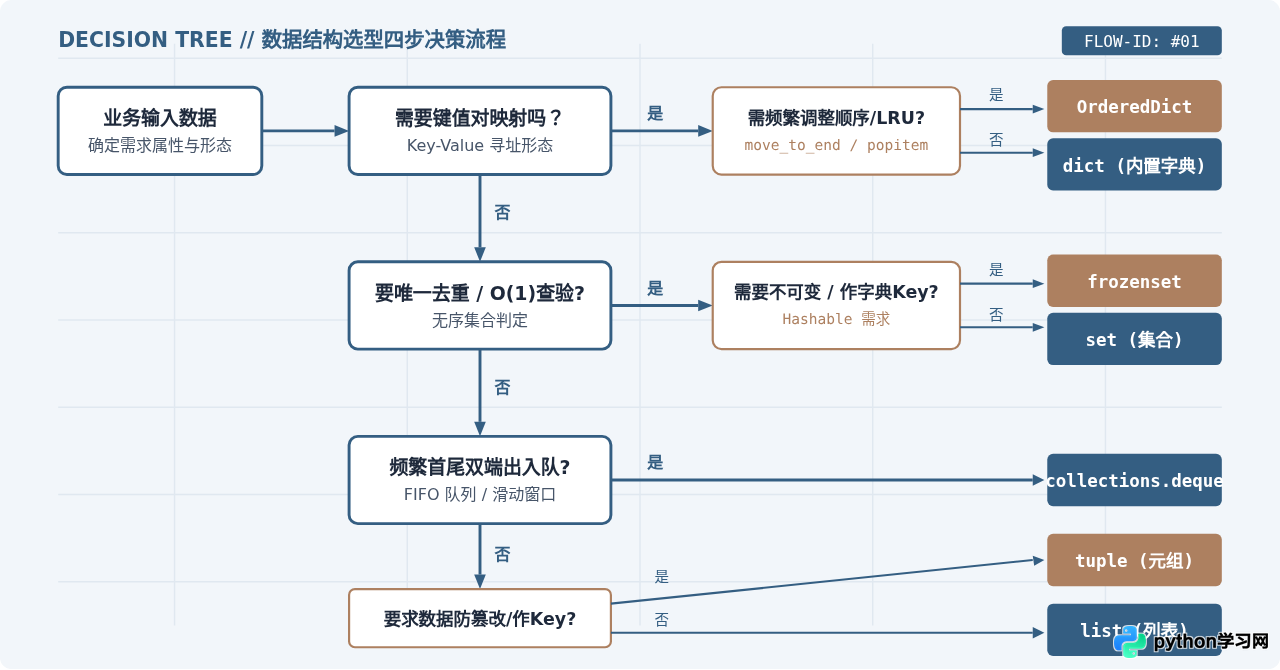
list、tuple、deque 或 dict;如果业务要求元素唯一且需要 $O(1)$ 极速成员判定(in 查询),则选用 set 或 frozenset。
一、厘清关键概念:有序(Ordered)与排序(Sorted)不是一回事
在 Python 中,初学者容易把“有序”与“已排序”混为一谈。理解它们的概念边界是选型的前提:
- 有序(Order Preserving / Ordered):指的是容器保留元素的录入或排列次序。你先存入 A 再存入 B,那么无论何时遍历,A 始终在 B 前面,同时容器通常支持基于固定位置的索引(如
seq[0])或确定的遍历链条。典型代表有list、tuple、deque以及自 Python 3.7 起正式作为语言规范承诺保持插入顺序的dict。 - 排序(Sorted):指的是元素按照某种大小规则(例如数值递增、字母字典序)排定次序。一个有序数据结构(如
list)默认并不处于“已排序”状态,除非显式调用sort()或sorted()。 - 无序(Unordered):指的是容器不保留插入次序,也不能通过下标索引访问。遍历该容器时,输出顺序只取决于底层的哈希离散与扩容历史,逻辑上不可预测且不应依赖。典型代表是
set和frozenset。
二、底层存储机制:为什么有序与无序性能差异悬殊
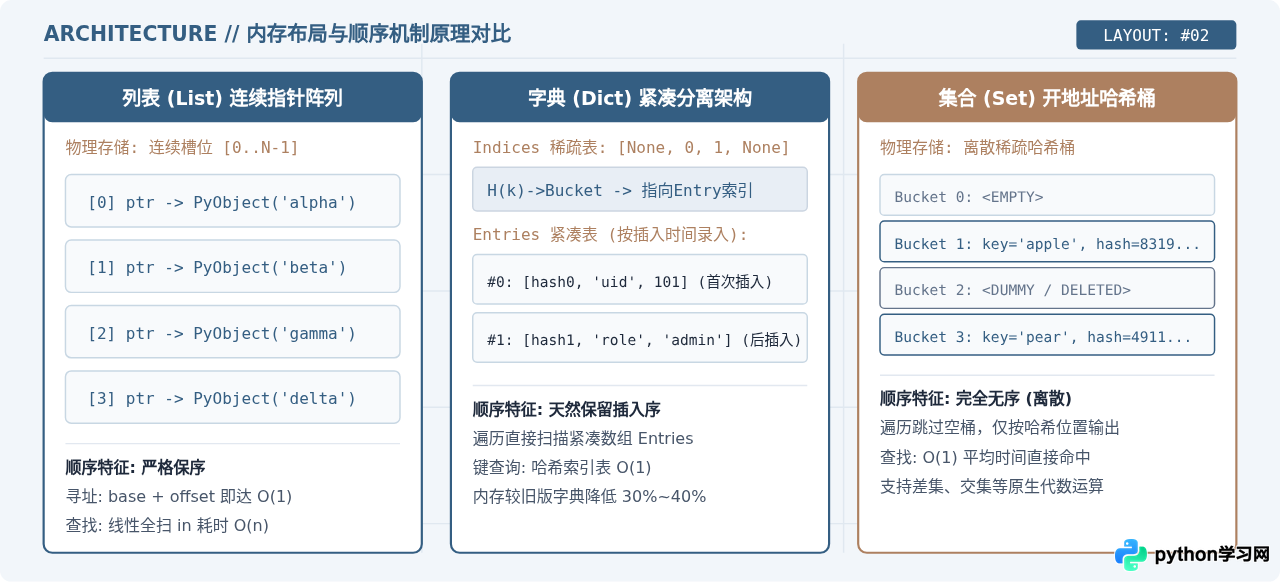
数据结构的外部行为是由其底层内存布局决定的。理解 Python 解释器(以标准 CPython 为例)如何存储数据,能直接指导我们在性能和空间之间做权衡:
1. 列表与元组(list / tuple):连续内存指针数组
list 在底层是一个动态长度的连续指针数组(PyObject**)。每个槽位保存指向实际 Python 对象的内存地址。
- 按索引寻址为 $O(1)$:因为内存连续,访问
items[i]只需进行简单的基地址偏移计算(base_address + i * pointer_size),速度极快。 - 保持绝对顺序:元素在数组中的物理槽位顺序与逻辑插入位置完全绑定。
- 成员查询(
in)为 $O(n)$:由于元素没有按值排布,查找某个特定值必须从头到尾线性扫描,数据规模越大越慢。
2. 集合与冻结集合(set / frozenset):稀疏哈希表
set 底层基于哈希表实现,但只有 Key 没有 Value。向集合添加元素时,Python 计算元素的哈希值(hash(item)),并通过模运算映射到哈希表的一个桶中。
- 成员查询为 $O(1)$:查找
x in my_set时直接计算哈希并跳转到对应桶,耗时与集合元素数量无关。 - 遍历无序性:随着元素的不断增删和哈希表的扩容重哈希(Resize),元素在哈希桶中的分布会发生跳跃和重排。因此,遍历
set时的顺序只是当前桶排布的副产品,任何外部操作都可能改变下一次迭代的顺序。
3. 现代字典(dict):紧凑索引数组与顺序项数组分离
Python 3.6 之前,字典同样是稀疏哈希表,因此是无序的。从 Python 3.6 引入并在 3.7 写入规范的新型字典实现中,字典被重构为两个数组:
- Indices 稀疏数组:负责哈希映射,只保存小整数索引(指向真实项数组)。
- Entries 紧凑数组:保存具体的
hash, key, value,且严格按照插入时间先后顺序追加。
这种架构既节省了近 30% 到 40% 的内存空间,又天然保证了遍历字典时始终与键值对录入的顺序一致。
三、按业务场景做选择:四大维度的权衡法则
维度 1:高速判断成员是否存在(in 判定)
当业务需要频繁检查“某元素是否在容器中”时,数据量一旦达到几千以上,有序的 list 和无序的 set 会产生数百倍的性能差异。
# 示例代码:验证大批量数据下的查找耗时
# 运行环境:Python 3.8+
import time

data_count = 100_000
query_target = -1  # 不存在的值,触发全表扫描

# 构建列表与集合
num_list = list(range(data_count))
num_set = set(range(data_count))

# 测试 list 成员查询
t0 = time.perf_counter()
found_in_list = query_target in num_list
t_list = time.perf_counter() - t0

# 测试 set 成员查询
t0 = time.perf_counter()
found_in_set = query_target in num_set
t_set = time.perf_counter() - t0

print(f"List 查询耗时: {t_list * 1000:.4f} ms")
print(f"Set 查询耗时: {t_set * 1000:.6f} ms")Set 查询耗时: 0.0007 ms
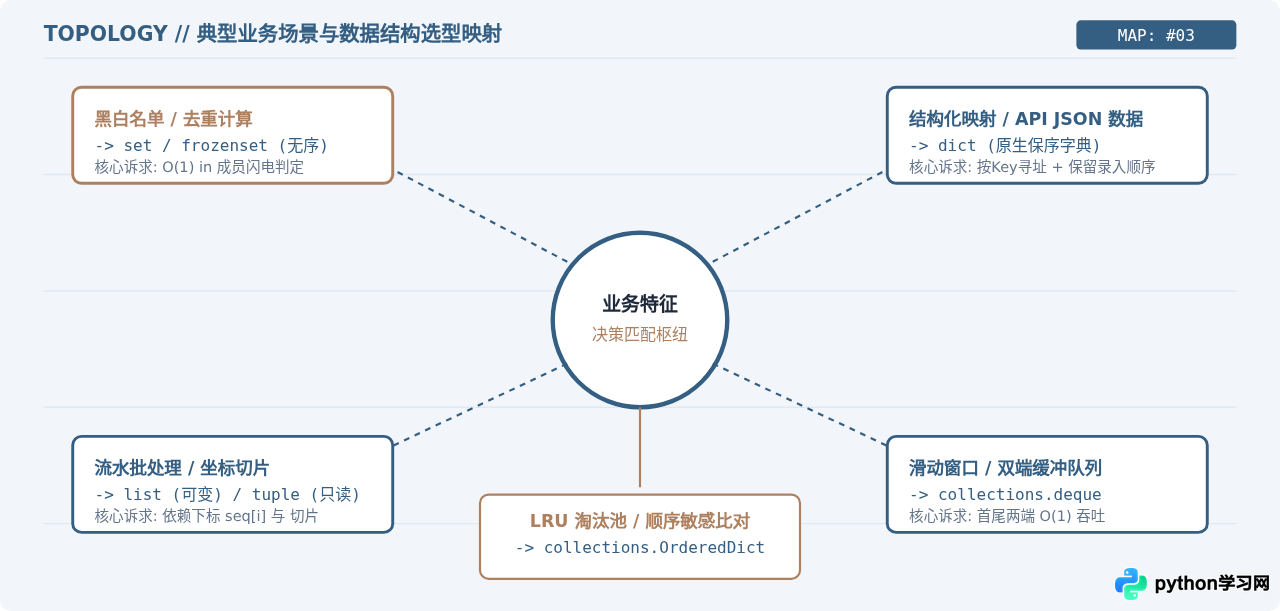
选择结论:如果数据核心用途是黑白名单拦截、权限点校验、去重去杂,无条件选择无序的 set;仅当需要维持显示顺序或元素不可哈希(如包含字典、子列表)时,才使用 list。
维度 2:数据是否依赖索引访问与切片操作
集合结构无法通过下标获取元素,执行 s[0] 会直接抛出 TypeError: 'set' object is not subscriptable。
- 需要根据位置定位:如获取“前五名”、“倒数第三个提交”,或者使用
[::2]步长切片,必须使用有序的list或tuple。 - 不可变快照约束:如果这组位置数据一旦初始化就不允许代码逻辑意外追加或修改(例如函数返回的多值坐标
(x, y, z)、数据库连接参数),优先选用tuple。这既能在语义上表达不变性,又能避免并发或多模块传递时的副作用。
维度 3:频繁在队列头部/两端增删元素
list 在末尾 append() 和 pop() 的复杂度是分摊 $O(1)$,非常高效;但在头部 insert(0, val) 或 pop(0) 时,会导致整个底层数组的所有元素向后或向前搬移一位,时间复杂度为 $O(n)$。
在需要实现生产者-消费者队列、任务管道或滑动窗口时,应该从标准库 collections 导入 deque(双端队列)。它在底层采用双向链表/块状缓冲区,头部和尾部的推拉操作均为纯粹的 $O(1)$。
# 示例代码:deque 与 list 在头部弹出时的性能差异
from collections import deque
import time

total_ops = 50_000
raw_data = list(range(total_ops))

# 测试 list.pop(0)
lst = list(raw_data)
t0 = time.perf_counter()
while lst:
    lst.pop(0)
t_list_pop = time.perf_counter() - t0

# 测试 deque.popleft()
dq = deque(raw_data)
t0 = time.perf_counter()
while dq:
    dq.popleft()
t_deque_pop = time.perf_counter() - t0

print(f"List pop(0) 5万次耗时:  {t_list_pop:.4f} s")
print(f"Deque popleft() 5万次耗时: {t_deque_pop:.4f} s")Deque popleft() 5万次耗时: 0.0032 s
维度 4:键值映射中,标准 dict 与 OrderedDict 的取舍
既然 Python 3.7+ 的标准 dict 已经保证了插入顺序,那么 collections.OrderedDict 还有存在的必要吗?答案是:在特定顺序操作场景中仍然必不可少。
- 顺序敏感的等价比较:标准
dict判定==时只检查键值映射内容,忽略插入顺序;而两个OrderedDict进行相等性比较时,必须键值一致且插入顺序完全相同才会判定为 True。 - 显式重排控制:
OrderedDict原生提供了move_to_end(key, last=True/False)方法,可以在 $O(1)$ 时间内把某个键移动到链表最前或最后。这是实现高效 LRU(最近最少使用)缓存淘汰的核心工具。
# 示例代码:OrderedDict 的顺序敏感与重排能力
from collections import OrderedDict

# 1. 字典等价性比较差异
dict_a = {'x': 1, 'y': 2}
dict_b = {'y': 2, 'x': 1}
print(f"普通字典比较结果: {dict_a == dict_b}")

od_a = OrderedDict([('x', 1), ('y', 2)])
od_b = OrderedDict([('y', 2), ('x', 1)])
print(f"OrderedDict 比较结果: {od_a == od_b}")

# 2. LRU 重排场景
lru_cache = OrderedDict()
lru_cache['task_a'] = 'pending'
lru_cache['task_b'] = 'running'
lru_cache['task_c'] = 'done'

# 重新激活 task_a,将其移动到最末尾表示最近使用
lru_cache.move_to_end('task_a')
print(f"更新后遍历顺序: {list(lru_cache.keys())}")OrderedDict 比较结果: False
更新后遍历顺序: ['task_b', 'task_c', 'task_a']
四、工程避坑:日常开发中的三个高频陷阱
陷阱 1:试图通过 set 去重的同时保持原有序列顺序
很多开发者为了过滤列表中的重复值,习惯直接使用 list(set(original_list))。这会导致原本的先后顺序彻底被打乱。
正确解法:在 Python 3.7+ 中,利用 dict.fromkeys() 可以在 $O(n)$ 时间内完成去重,并且严格保留第一次出现的先后顺序。
# 示例代码:保持顺序的去重方式
raw_items = ['apple', 'banana', 'orange', 'apple', 'banana', 'pear']

# 错误做法:顺序被破坏
unordered_unique = list(set(raw_items))
print(f"set 去重结果:         {unordered_unique}")

# 正确做法:利用 dict.fromkeys 保持首次插入顺序
ordered_unique = list(dict.fromkeys(raw_items))
print(f"dict.fromkeys 去重结果: {ordered_unique}")dict.fromkeys 去重结果: ['apple', 'banana', 'orange', 'pear'] (严格保序)
陷阱 2:把可变对象放入 set 或用作 dict 的 key
集合与字典的键必须是可哈希对象(Hashable)。如果试图将 list 或 dict 存入 set,会立即触发 TypeError: unhashable type: 'list'。
list 转为 tuple;将可变集合 set 转为 frozenset。
陷阱 3:在长列表中使用 list.remove() 或 in 循环去重
在 for item in my_list: if item not in result: result.append(item) 中,每次 item not in result 都是 $O(k)$ 的线性扫描。整个去重循环的综合复杂度会恶化为 $O(n^2)$。处理 10 万条数据时,耗时可能从几毫秒飙升到几分钟。
五、总结与快速决策清单
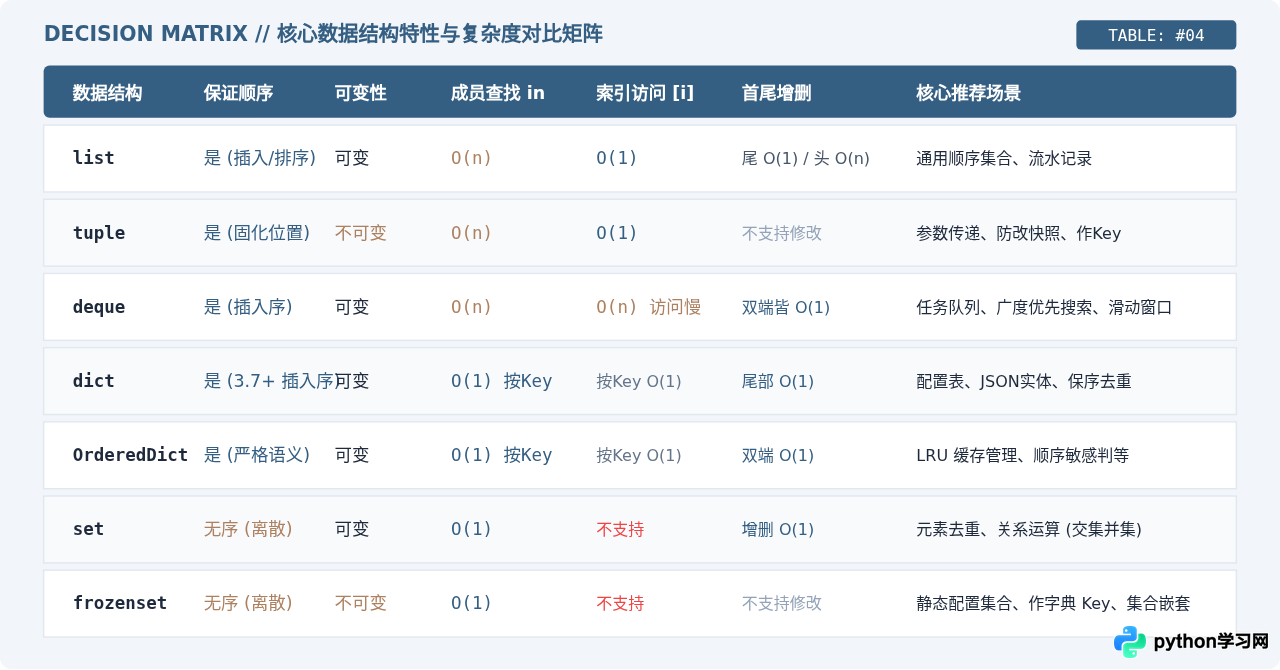
在实际编写代码时,可以对照下表在 5 秒内敲定数据结构:
- 需要按内容极速找人、判重:首选
set;如果该集合本身需要作为字典的键,选用frozenset。 - 需要保留时间顺序的键值对应:首选标准
dict;仅当需要调用move_to_end()实现缓存淘汰或必须按顺序严苛比对两份字典时,才引入OrderedDict。 - 常规按序流式处理:通用场景首选
list;数据仅作只读传递且需防止外部修改时选用tuple。 - 需要频繁在头部插入或弹出(队列/滑动窗口):坚决避免使用
list.pop(0),改用collections.deque。 - 需要保序去重:放弃
list(set(x)),直接调用list(dict.fromkeys(x))。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









