

结构化数据对AI搜索引擎排名有影响吗?怎么正确配置

过去,我们谈论搜索引擎优化(SEO)时,目光往往紧盯着关键词密度、外链数量和页面加载速度。那时候,结构化数据(Structured Data)更像是一种“锦上添花”的技术装饰,主要用于争取搜索结果页上的富媒体摘要——比如那颗显眼的星级评分或食谱图片。
但随着生成式AI和大型语言模型(LLM)逐渐接管信息检索的前端,游戏规则发生了微妙而深刻的变化。AI不再仅仅匹配关键词,它需要“理解”内容。在这种语境下,结构化数据从一种可选的展示优化手段,变成了AI抓取和理解网页内容的“标准说明书”。
**结构化数据本身不直接决定排名高低,但它决定了AI能否准确读取你的内容。**如果AI无法从杂乱的HTML中厘清事实关系,它要么忽略你的页面,要么产生“幻觉”错误引用。因此,正确配置结构化数据,本质上是在为AI降低认知成本,提高被权威引用的概率。
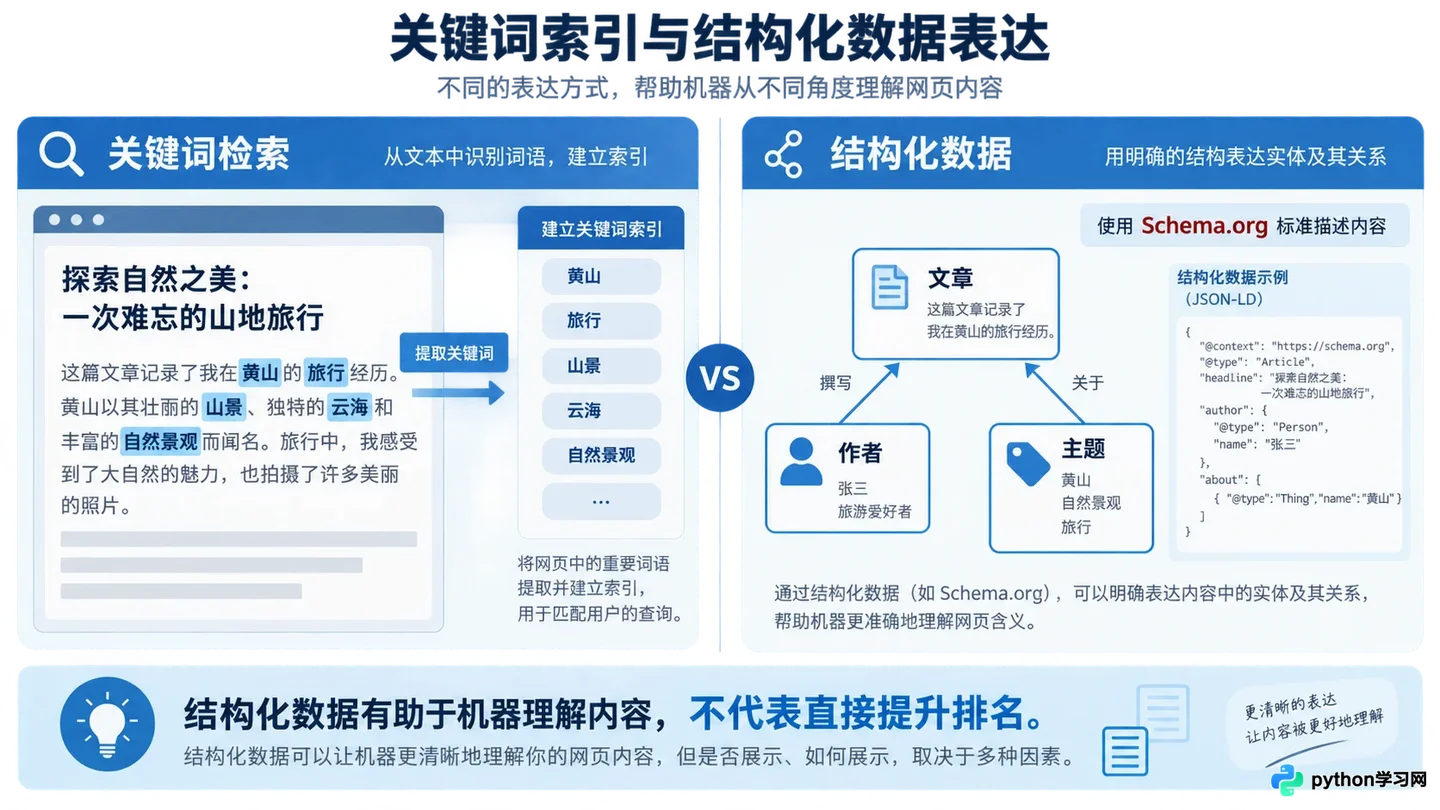
传统搜索基于关键词索引,AI搜索基于实体理解与结构化数据提取
从关键词匹配到实体理解:AI为何依赖结构化数据
传统搜索引擎像是一个勤奋的图书管理员,通过索引卡片(关键词)来寻找书籍。而AI搜索引擎更像是一个正在快速阅读的研究员,它试图构建知识图谱,理解“谁”、“做了什么”、“在哪里”以及“多少钱”之间的逻辑关系。
网页的HTML代码主要是为了给人看的,充满了样式标签和嵌套结构,机器阅读起来噪音极大。结构化数据(通常采用Schema.org词汇表)则像是给这段文字打上了明确的标签。它告诉机器:“这段文字是价格”,“那段文字是作者”,“这个日期是发布时间”。
在这种场景下,结构化数据的作用不再是直接提升权重,而是消除歧义。例如,当用户询问“哪款笔记本电脑适合视频剪辑且价格在1万元左右”时,AI需要从海量文章中提取具体型号和价格。如果你的页面使用了标准的Product Schema标记,AI就能以极高的置信度提取出“价格”字段,而不是去猜测正文中出现的数字是价格还是内存大小。
这种确定性对于AI至关重要。大语言模型倾向于引用那些数据结构清晰、事实边界明确的内容,因为这能降低其输出错误信息的风险。因此,拥有高质量结构化数据的页面,更容易成为AI回答中的“信源”。
关键场景配置:让AI读懂你的核心内容
并非所有页面都需要同等程度的结构化标记。我们应该将精力集中在AI最频繁调用、且最容易产生歧义的内容类型上。以下是三个最具代表性的配置场景。
1. 问答与常见问题(FAQPage)
在AI搜索中,直接回答问题是最常见的交互形式。FAQPage 类型可以帮助AI快速识别问题与答案的对应关系。
配置时,必须确保每个Question都有对应的Answer,且内容简洁直接。避免在答案中包含过多的营销话术,因为AI可能会直接截取这段文字作为回答。如果答案过长或包含无关信息,AI可能会选择忽略该条目,转而寻找更清晰的来源。
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [
    {
      "@type": "Question",
      "name": "结构化数据会影响AI搜索排名吗?",
      "acceptedAnswer": {
        "@type": "Answer",
        "text": "结构化数据不直接决定排名,但能帮助AI更准确地理解内容,从而提高被引用的概率。"
      }
    }
  ]
}
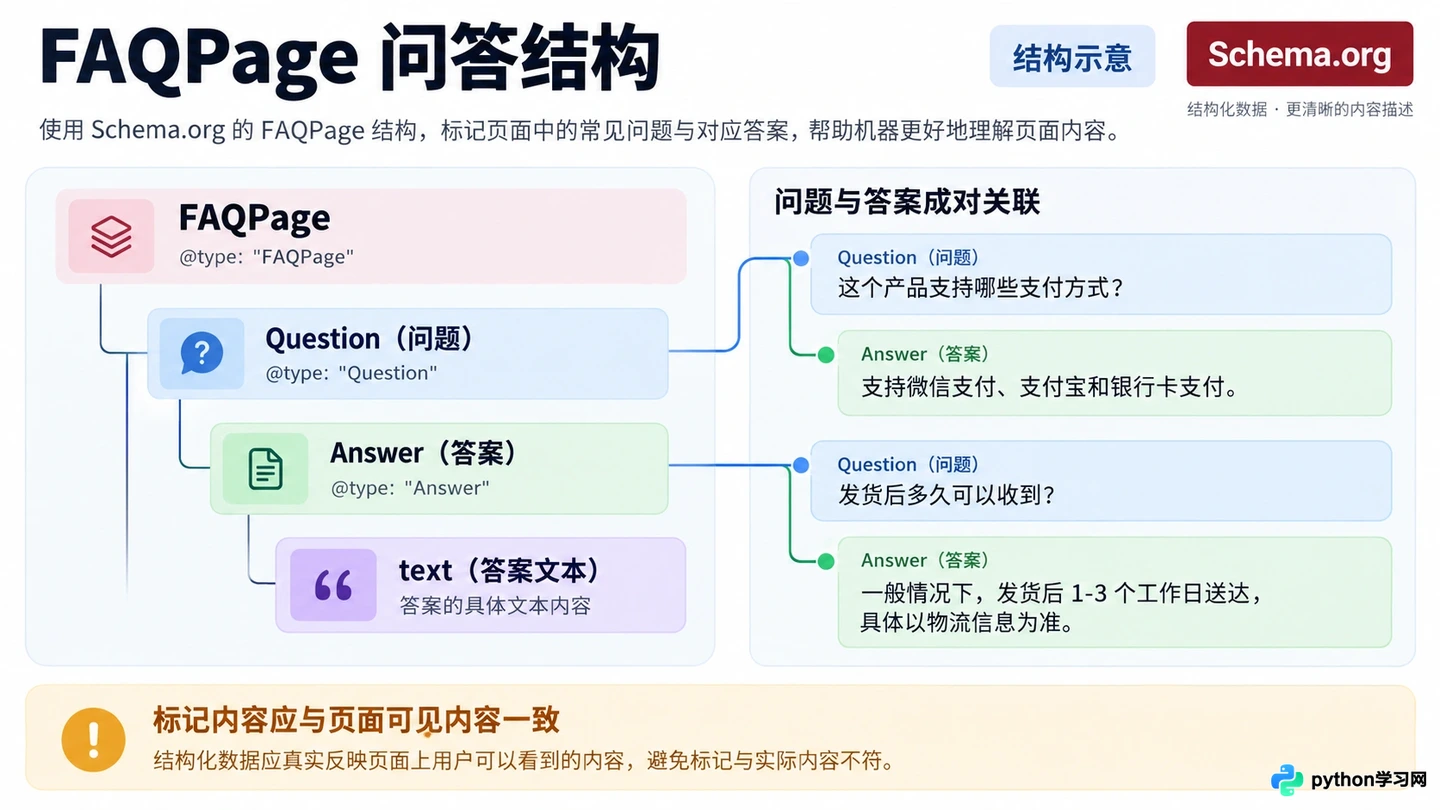
清晰的问答结构有助于AI直接提取答案
2. 产品与服务(Product & Offer)
对于电商或服务类网站,Product 标记是核心。AI在比较产品时,需要精确的参数对比。除了基本的名称和描述,务必配置offers(报价)和aggregateRating(综合评分)。
这里的一个常见误区是只标记价格而忽略货币单位和库存状态。AI在进行实时推荐时,非常看重信息的时效性和可用性。如果availability字段缺失,AI可能会认为该产品已下架或信息过时,从而降低引用优先级。
3. 文章与作者权威性(Article & Person)
在YMYL(你的金钱或你的生活)领域,如医疗、金融、科技建议,AI极其重视来源的权威性。Article 类型应配合Person或Organization使用,明确标注作者姓名、职位以及所属机构。
这不仅有助于AI建立实体关联,还能在AI生成回答时展示来源的可信度。例如,当AI引用一篇关于“Python编程技巧”的文章时,如果结构化数据显示作者是某知名科技公司的资深工程师,这条引用的权重自然会高于匿名博客。
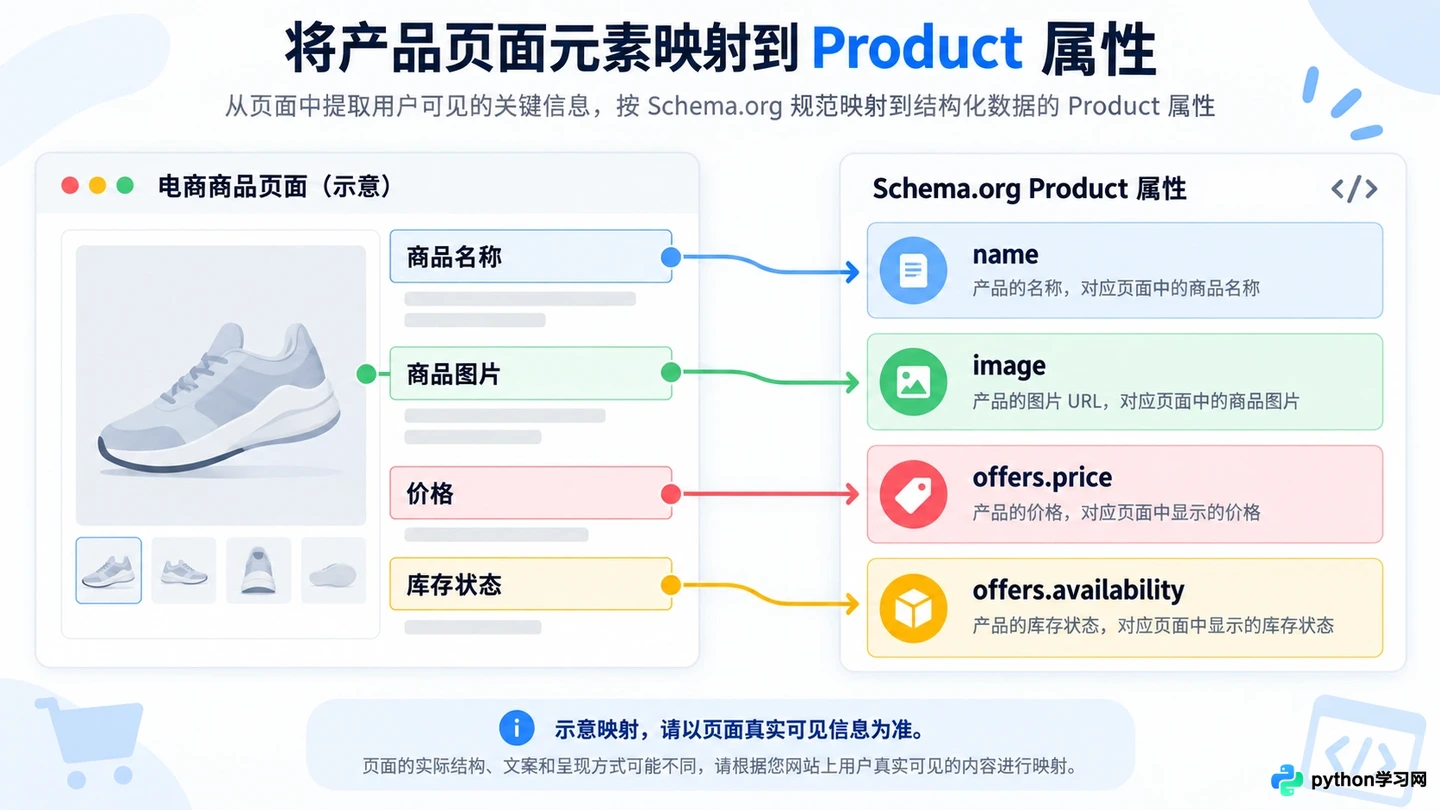
Product Schema将页面元素映射为机器可读的属性
避坑指南:错误配置比没有配置更糟糕
很多站长认为结构化数据越多越好,于是盲目堆砌标记。这种做法在AI时代不仅无效,甚至有害。
首先,严禁标记不可见内容。 结构化数据中的信息必须在页面上对用户可见。如果你在产品页的Schema中标记了“5折优惠”,但页面上实际显示的是原价,这会被视为误导。AI模型具备交叉验证能力,当发现结构化数据与页面视觉内容冲突时,它会判定该站点可信度低,进而减少引用。
其次,保持类型的一致性。 不要在一个页面同时标记为Article和Product,除非它确实是一篇评测文章且包含了具体的购买链接。混乱的类型定义会让AI困惑,导致它无法将该页面归类到正确的知识图谱节点中。
最后,注意嵌套逻辑。 例如,在Review(评论)中嵌套Author(作者)时,确保作者信息是独立的实体,而不是简单的字符串。复杂的嵌套结构如果语法错误,会导致整个代码块被解析器丢弃。
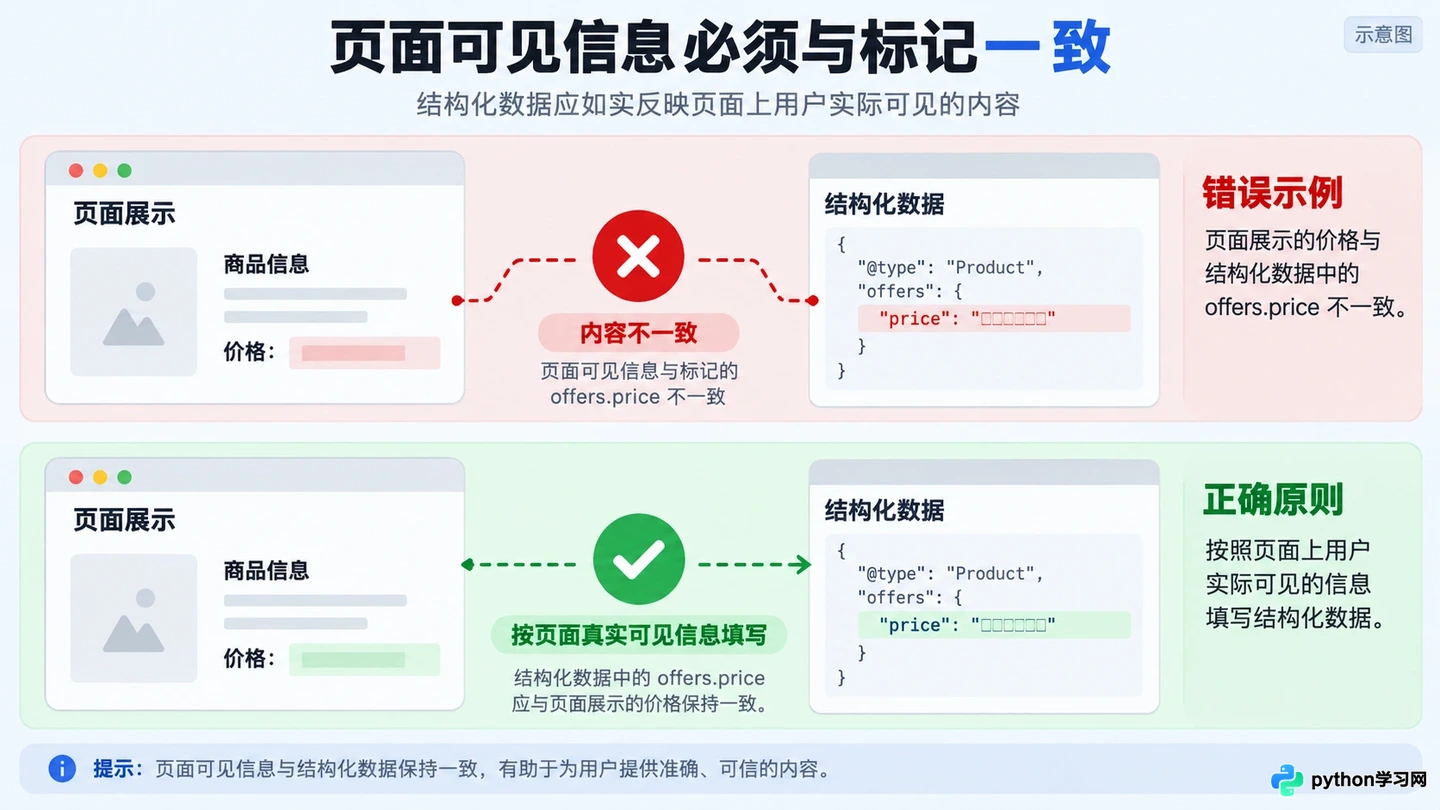
数据不一致会导致AI信任度降低
验证与维护:确保数据被正确读取
配置完成后,工作并未结束。你需要确认搜索引擎和AI爬虫是否能正确解析这些数据。
目前最可靠的工具仍然是Google的“富媒体搜索结果测试”(Rich Results Test)或Schema Markup Validator。这些工具可以模拟爬虫的视角,检查JSON-LD代码的语法错误和属性缺失。
但在AI语境下,我们还需要关注“语义完整性”。你可以尝试将你的页面内容复制给主流的大语言模型,询问它:“从这篇文章中提取产品名称、价格和主要特点。”如果模型提取的信息与你期望的一致,说明你的内容结构(包括隐含的结构化逻辑)是清晰的。如果模型产生了幻觉或遗漏关键信息,可能需要重新审视页面的文本结构或补充更明确的Schema标记。
定期监控搜索控制台中的“结构化数据”报告,关注是否有新增的错误类型。随着Schema.org词汇表的更新和AI模型能力的演进,某些旧的标记方式可能会被废弃,保持更新是维持AI友好性的关键。
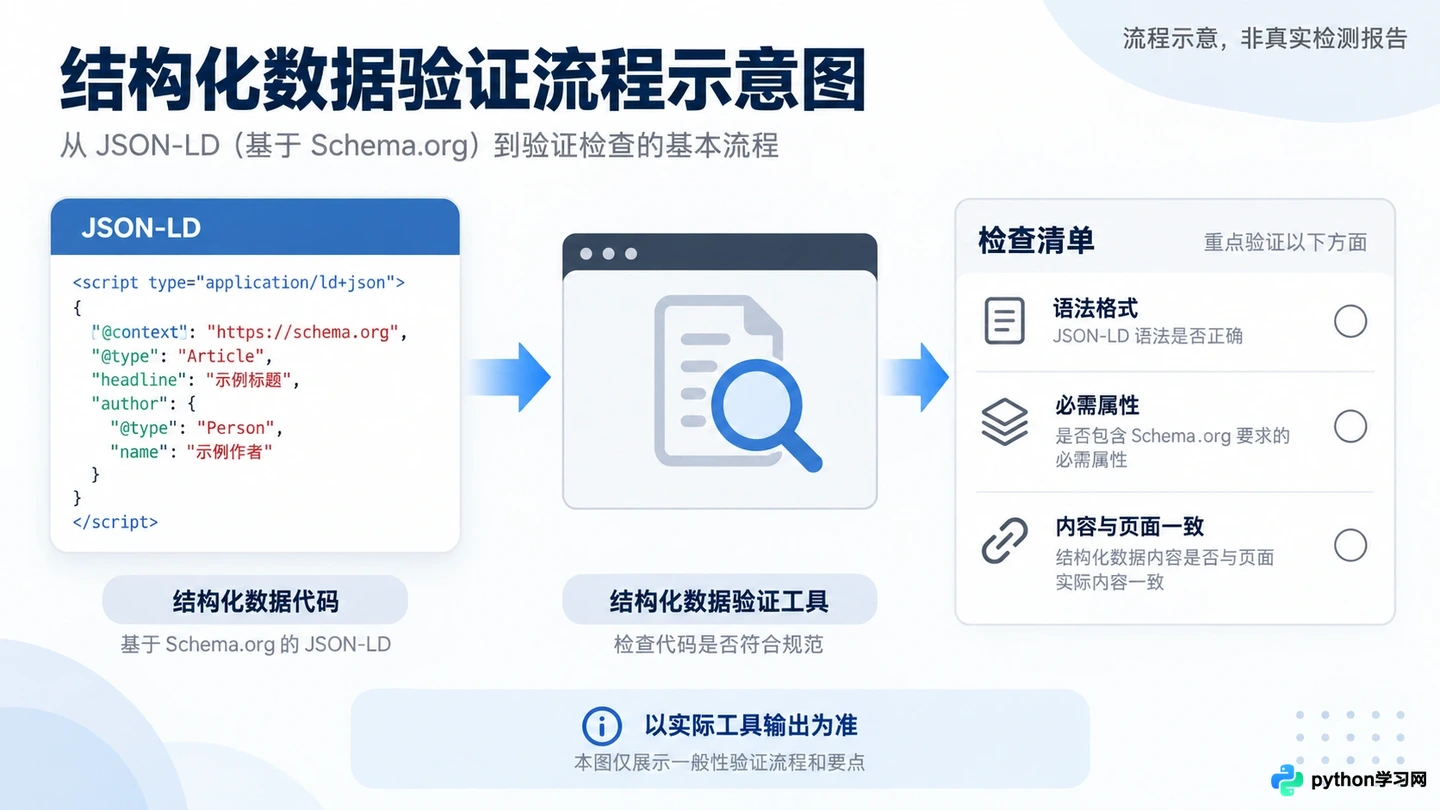
使用验证工具确保代码语法正确且无缺失属性
回到最初的问题:结构化数据对AI搜索排名有影响吗?答案是肯定的,但这种影响是间接且基础的。它不像外链那样直接传递权重,而是像地基一样,决定了你的内容能否被AI这座高楼稳固地接纳。
对于大多数网站而言,不需要追求全覆盖的复杂标记。专注于核心业务场景——无论是产品的价格、文章的作者,还是服务的流程——提供准确、清晰、与页面内容一致的结构化数据,就是在AI搜索时代最好的优化策略。毕竟,在这个由算法主导的世界里,清晰就是力量,准确就是信任。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









