

怎么提高Dify知识库检索准确率:召回参数与重排序优化

很多开发者在使用 Dify 搭建基于知识库的 AI 应用时,都会遇到一个尴尬时刻:用户问得清清楚楚,AI 却答非所问,或者把毫不相关的文档片段强行拼凑在一起。这往往不是大模型本身不够聪明,而是“检索”这个前置环节出了偏差。
在 RAG(检索增强生成)架构中,知识库就像图书馆的管理员。如果管理员找书的速度快但找不准,或者把一堆沾边但不核心的书都堆给读者,最终的阅读体验必然糟糕。很多人第一反应是去清洗数据或切分更细,但这不仅耗时,还可能破坏上下文连贯性。其实,在 Dify 的控制台中,通过精细调整召回策略和引入重排序机制,往往能以极低的成本显著改善检索精度。
平衡查全与查准:Top K 与相似度阈值的博弈
最直接的干预手段,是控制“到底拿多少片段给大模型看”。在 Dify 的知识库设置中,Top K 和相似度分数阈值(Score Threshold)是两个核心杠杆。
想象一下,用户问“如何报销差旅费”。如果 Top K 设得太小,比如只取 1 个片段,可能刚好漏掉了包含“发票要求”的关键段落;如果设得太大,比如取 10 个,可能会混入“员工入职流程”等噪声信息,干扰大模型的判断。
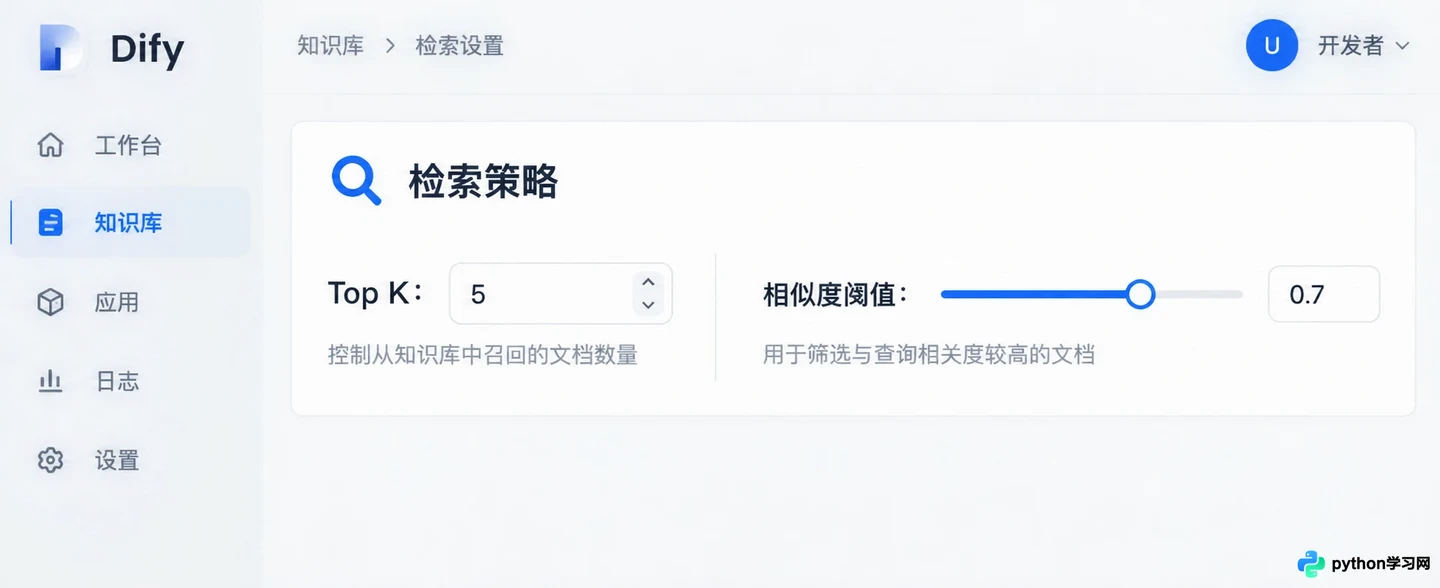
Dify 知识库检索策略设置面板,展示 Top K 和相似度阈值调节选项
在实际操作中,建议采取“宽进严出”或“窄进精出”的策略,具体取决于你的业务场景:
- 对于事实型查询(如政策条款、产品参数),建议适当降低 Top K(如 3-5),并提高相似度阈值(如 0.7 以上)。这样可以确保只有高度相关的片段进入上下文,减少幻觉。
- 对于探索型或复杂推理查询(如方案对比、综合分析),可以适当调高 Top K(如 6-8),并降低阈值(如 0.5 左右),以保留更多潜在相关信息,依靠大模型的总结能力去伪存真。
需要注意的是,相似度阈值并非越高越好。过高的阈值会导致“无结果返回”,此时 Dify 会触发默认回复或告知用户未找到相关信息。因此,观察“无命中”的频率,动态调整阈值,比盲目追求高分更重要。
告别关键词匹配陷阱:引入重排序模型
传统的向量检索基于语义相似度,虽然能理解“借钱”和“贷款”是相近概念,但在处理长尾词或多义句时,往往会出现“语义相关但逻辑无关”的情况。例如,用户问“苹果手机的电池续航”,系统可能召回大量关于“苹果种植技术”或“通用电池原理”的高分片段。
这时,就需要引入重排序(Rerank)模型。它的作用类似于图书馆里的资深专家,在初步筛选出的几十本书中,再根据用户的具体问题,进行一次精细的相关性打分和重新排列。
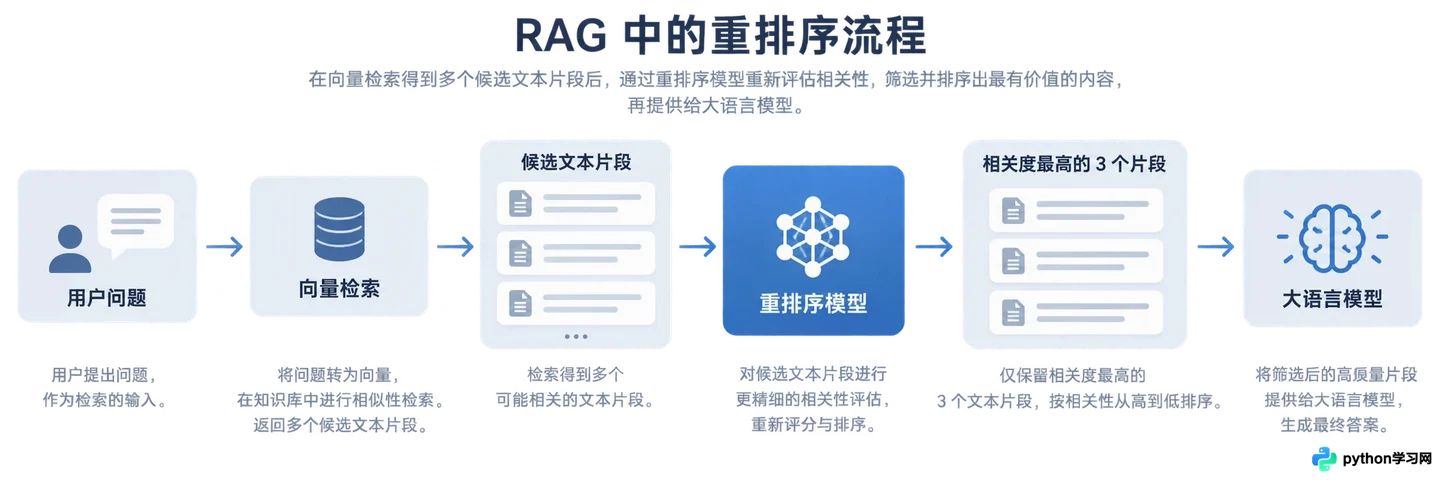
重排序模型在检索链路中的位置示意
在 Dify 中启用重排序功能非常简单,但效果立竿见影:
- 工作原理:系统先通过向量检索召回较多候选片段(如 Top 20),然后利用专门的 Rerank 模型对这些片段与用户问题的相关性进行二次打分,最后只取分数最高的前 N 个(如 Top 3)送给大模型。
- 适用场景:当你的知识库文档结构复杂、存在大量相似术语,或者用户提问非常具体时,重排序能大幅剔除噪声。
- 性能权衡:重排序会增加少量的延迟,因为多了一次模型推理过程。但对于对准确率要求极高的客服、法律咨询等场景,这点延迟换取的准确性提升是完全值得的。
目前 Dify 支持多种主流的 Rerank 模型,如 BGE-Reranker 等。建议在测试环境中对比开启前后的回答差异,通常你会发现,开启重排序后,那些“看似相关实则跑题”的片段被有效过滤了。
混合检索:当向量遇上全文搜索
有些时候,用户的问题包含非常具体的专有名词、订单号或特定代码,这些内容在向量空间中可能并不具备显著的语义特征,导致向量检索失效。这时候,单纯的向量搜索就显得力不从心。
Dify 提供的混合检索(Hybrid Search)模式,结合了向量检索和全文检索(Keyword Search)的优势。向量检索负责理解语义,全文检索负责精确匹配关键词。
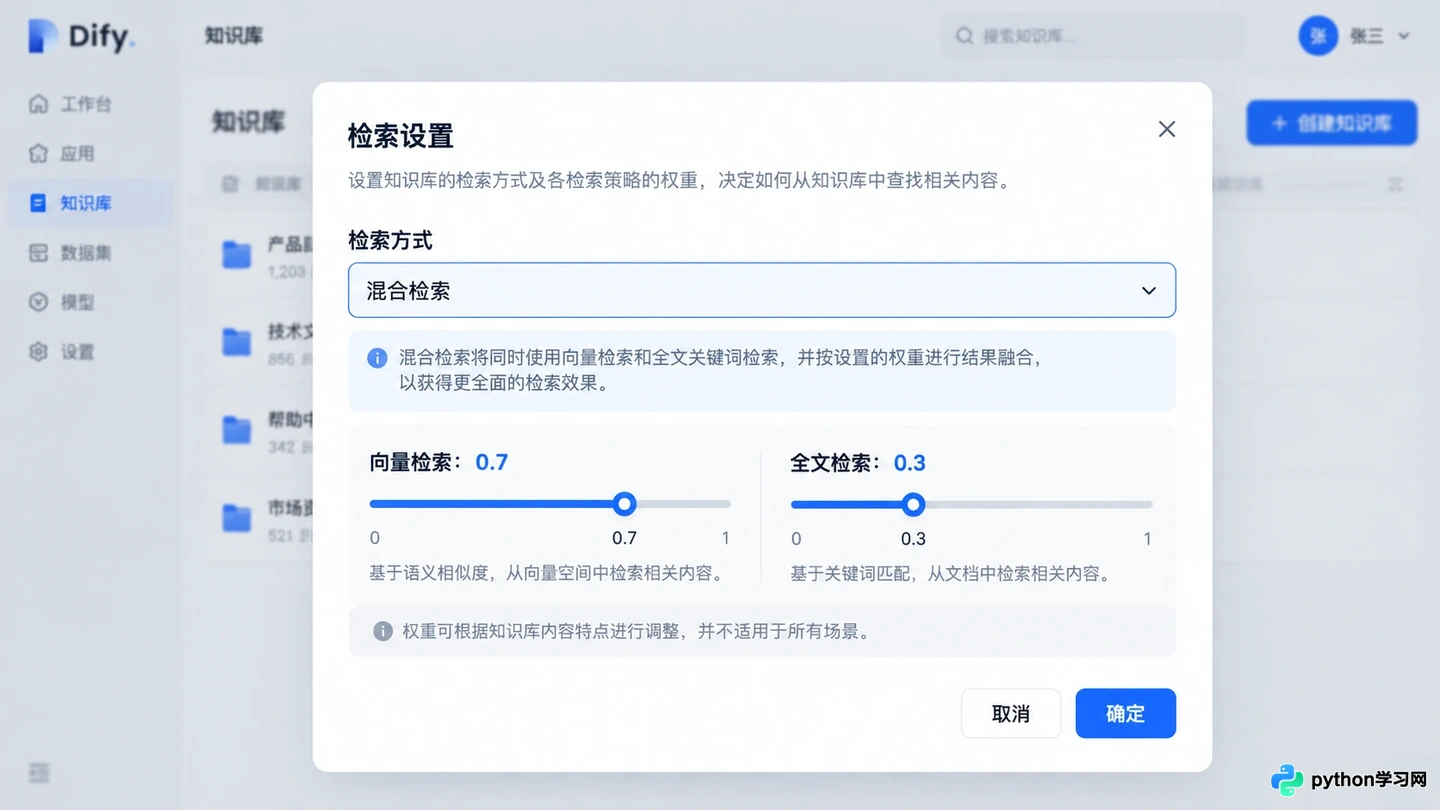
Dify 中启用混合检索及权重配置
在这种模式下,系统会分别执行两种检索,然后通过加权算法合并结果。对于以下场景,混合检索尤为有效:
- 专业术语密集:如医疗、法律、工程技术文档,其中包含大量固定搭配的术语。
- 精确匹配需求:如查询特定的错误代码、产品型号或合同编号。
在 Dify 的设置中,你可以调整向量检索和全文检索的权重。如果不确定如何设置,可以从默认权重开始,观察哪些类型的查询效果不佳,再微调权重比例。例如,如果发现很多包含具体型号的查询漏检,可以适当提高全文检索的权重。
数据质量仍是基石:参数优化的边界
必须承认,参数调整是有边界的。如果原始文档本身杂乱无章、包含大量无关噪音,或者切分策略极其不合理(如将完整的表格强行切断),那么再先进的检索算法也难以回天。
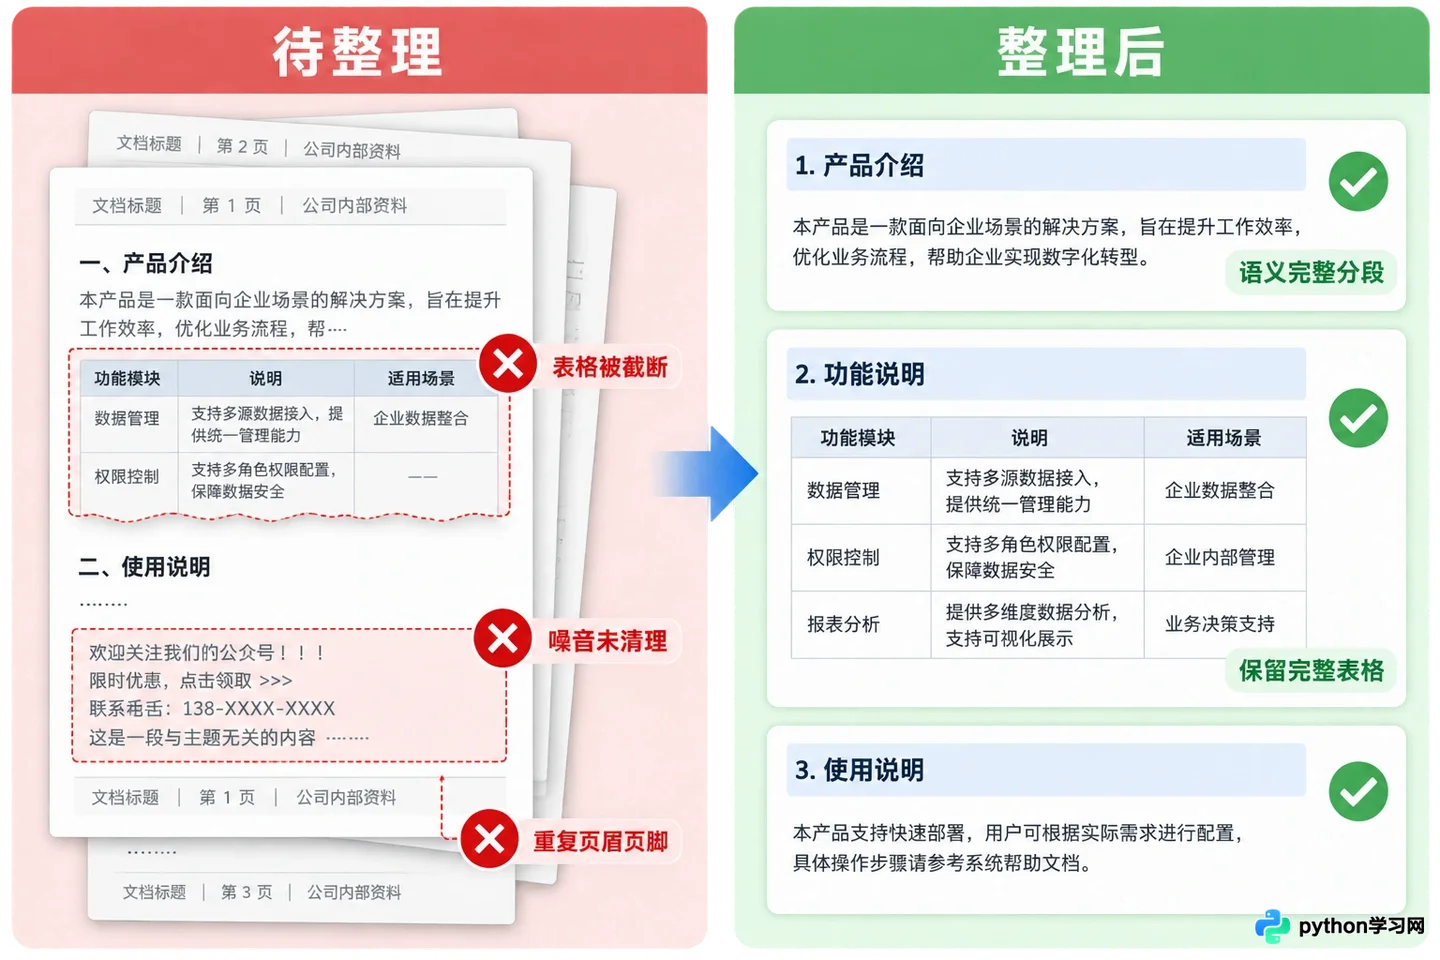
合理的文档分段与噪音清洗对比
在调整参数之前,请先检查以下基础工作:
- 分段合理性:确保每个文本块包含完整的语义单元。对于表格和列表,尽量保持其完整性,避免跨段断裂。
- 元数据利用:如果文档有明确的分类、日期或作者,利用 Dify 的元数据过滤功能,可以在检索前就缩小范围,这比事后过滤更高效。
- 清洗噪音:去除文档中的页眉、页脚、乱码和无意义的广告语,这些内容会严重干扰向量嵌入的质量。
参数优化是“锦上添花”,数据治理才是“雪中送炭”。只有在数据质量达标的前提下,Top K、阈值和重排序的调整才能发挥出最大效能。
回到最初的那个尴尬时刻,当 AI 再次答非所问时,不要急着责怪模型。打开 Dify 的控制台,看看是不是给它的“参考书”太多太杂,还是没请那位“资深专家”来做二次筛选。精准的检索,始于对数据特性的理解,成于对参数的精细打磨。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









