

Dify知识库高质量与经济索引模式有什么区别

刚把文档喂进 Dify 的知识库,点击“创建”那一刻是不是有点纠结?一边是听起来就很靠谱的“高质量”模式,另一边是主打性价比的“经济”模式。选错了可能不仅多花冤枉钱,还会让 AI 回答变得要么太慢、要么太蠢。
其实这两个模式的核心区别,不在于谁更高级,而在于它们处理文本和检索信息的逻辑不同。简单说,一个是为了“答得准”,一个是为了“跑得快且省钱”。
检索精度的直观差异
高质量索引模式采用的是分段后向量化检索。它会把你的长文档切成一个个语义完整的小段落,然后转换成向量存入数据库。当你提问时,系统会计算问题与这些段落的相似度,找出最相关的几段给大模型。
这种方式的优点是上下文关联性强。比如你问“公司的报销流程是什么”,它能精准定位到包含具体步骤的那一段,而不是把整章财务制度都扔给 AI。这对于逻辑复杂、细节繁多的专业文档非常友好。
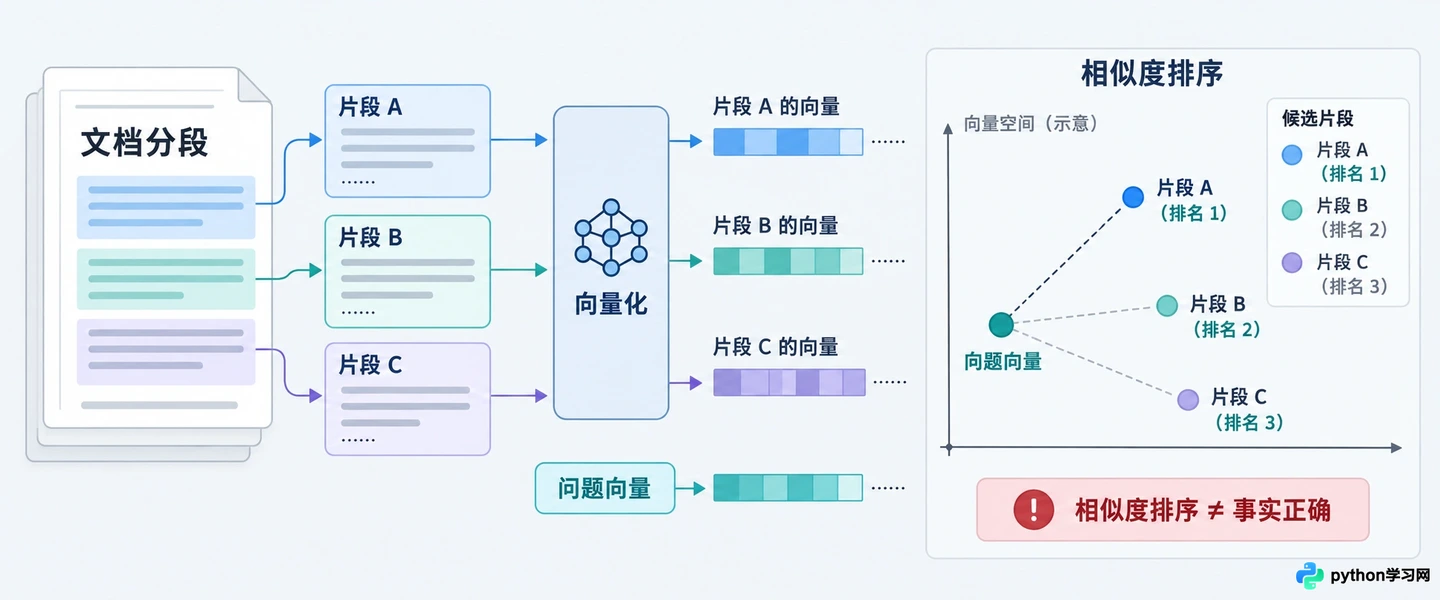
高质量索引通过向量相似度匹配,精准定位语义相关的文本段落
相比之下,经济索引模式通常采用关键词匹配或更简单的全文检索策略,或者在向量检索的基础上做了大量的简化处理。它的优势在于对短文本、明确关键词的响应很快,但在处理“这句话隐含的意思是什么”这类需要语义理解的问题时,容易漏掉关键信息,或者召回一些看似相关实则无用的片段。
处理速度与 Token 消耗
除了准不准,还得看快不快以及贵不贵。高质量索引在创建时需要调用嵌入模型(Embedding Model)将文本转化为向量,这个过程比较耗时,尤其是文档量大时,你会看到进度条走得很慢。
更重要的是推理阶段的成本。因为高质量模式召回的内容通常更精准但可能包含更多必要的背景信息,加上其底层往往配合更复杂的重排序(Rerank)机制,这会显著增加每次问答的 Token 消耗。如果你的应用并发量高,这笔开销不容忽视。
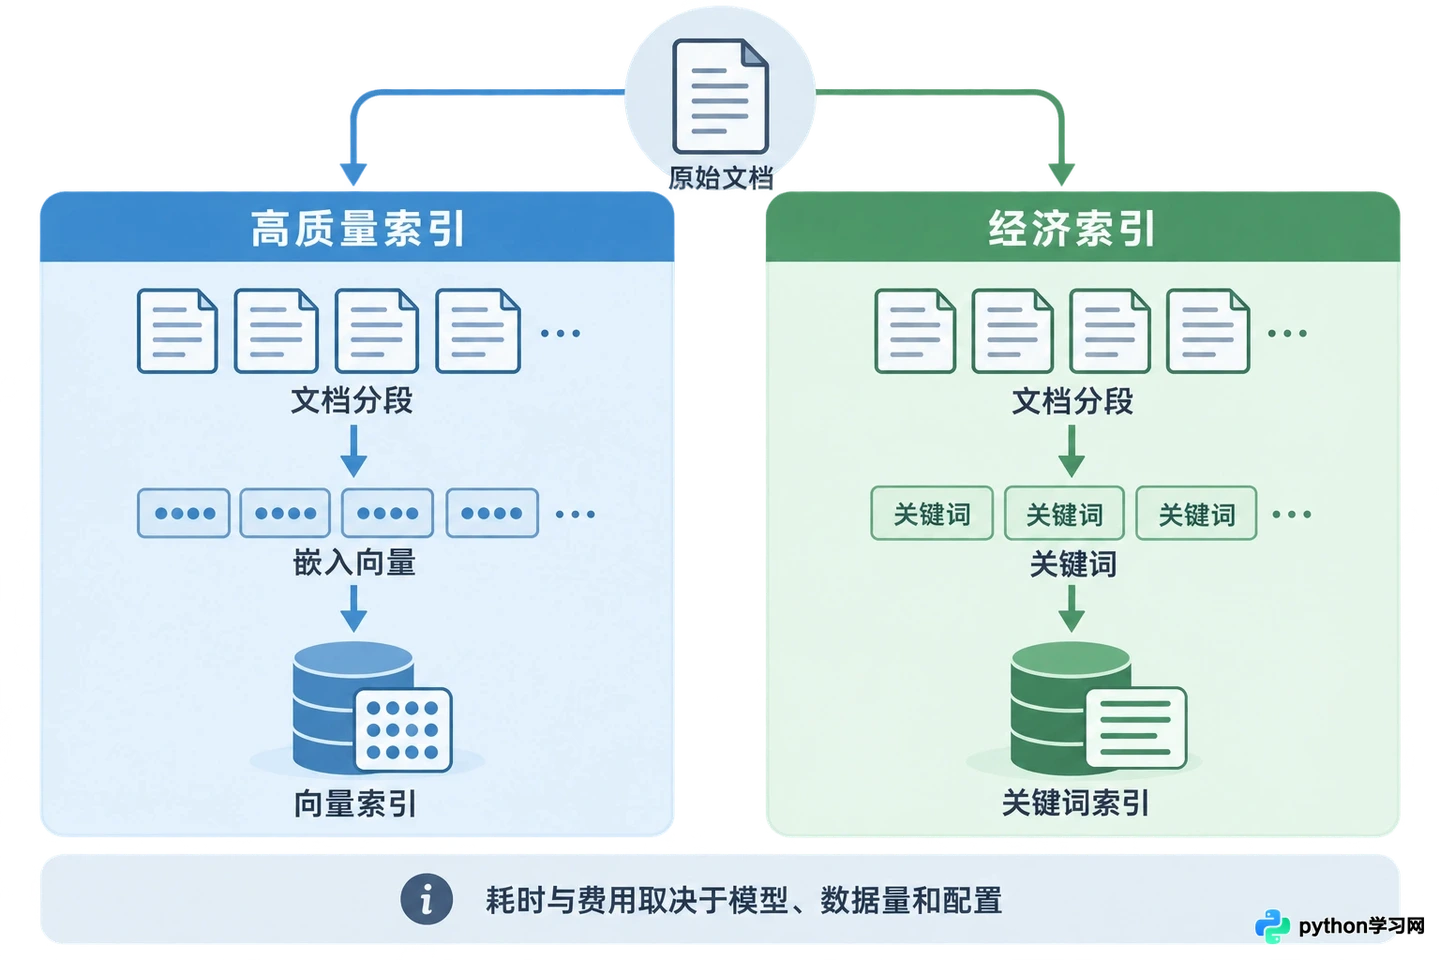
经济索引在创建速度和Token消耗上具有明显优势
经济索引模式则轻量得多。它在创建时几乎不需要复杂的计算资源,索引建立速度快。在检索时,由于策略简单,返回的结果集处理也快,整体延迟更低。对于预算有限或者对实时性要求极高的场景,它是更务实的选择。
到底该选哪一个?
别被名字误导,不是所有场景都需要“高质量”。你可以参考下面这个简单的判断逻辑:
如果你的知识库内容是法律条文、技术手册、医疗指南等容错率低、逻辑严密的文档,且用户的问题通常比较开放或复杂,请毫不犹豫选择高质量索引。这时候,准确性比节省几毛钱 Token 重要得多。
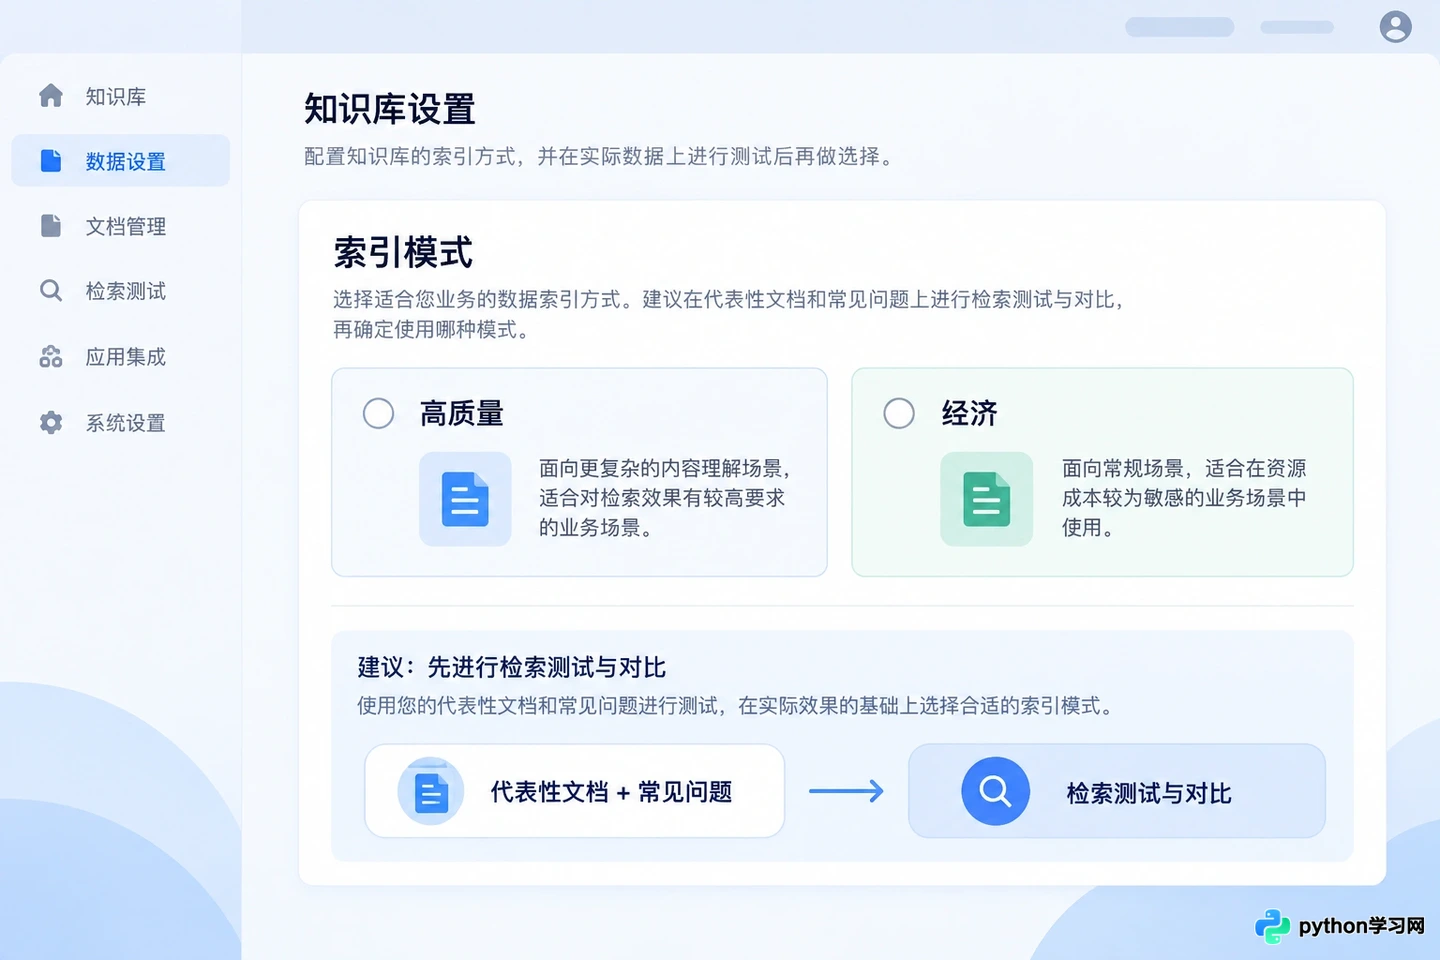
在Dify创建知识库时可根据文档类型选择索引模式
反之,如果你的数据主要是新闻摘要、产品简短介绍、FAQ 列表,或者用户习惯使用非常具体的关键词进行搜索(如“iPhone 15 价格”),经济索引完全够用。它能以极低的成本提供快速的反馈,用户体验并不会因为少了复杂的向量计算而变差。
还有一个折中的思路:先小范围测试。上传几十页典型文档,分别用两种模式创建子集,用几个真实用户常问的问题去测。看看高质量模式带来的精度提升,是否值得它多出的等待时间和成本。有时候,经济模式的“够用”恰恰是项目启动初期的最佳策略。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









