

在线Python编译器运行超时的常见原因及解决

在在线Python编译器中运行程序时,许多初学者和开发者经常会遇到“Time Limit Exceeded”、“Execution Timed Out”或页面长时间转圈后提示超时的错误。这种现象通常并不是编译器故障,而是程序触发了在线沙箱预设的执行时间限制。本文将直接梳理在线编译器超时背后的防护机制、导致超时的五大常见根源,并给出逐一排查与优化的具体方法。
一、为什么在线编译器会严格限制运行时间?
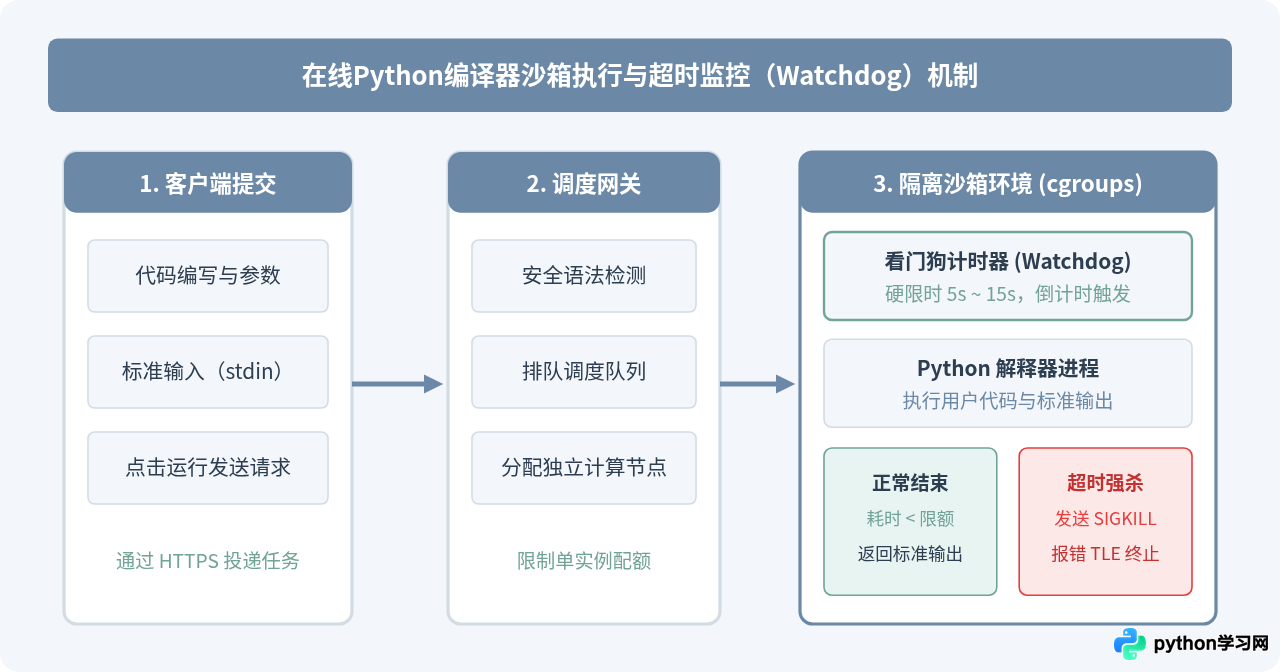
与本地计算机可以无限制运行脚本不同,在线Python编译器属于多租户共享计算资源。为了防止单个用户的死循环或恶意消耗资源的脚本拖垮整台服务器,平台会在运行沙箱中配置资源控制器与看门狗定时器(Watchdog Timer)。
大多数主流在线平台(如各大学习网站的在线练习台、代码片段分享平台、在线OJ等)为单个Python脚本分配的最大运行时间通常在 5 秒到 15 秒 之间。一旦脚本在该时间内未能返回退出码,容器的监控进程就会直接向Python解释器发送 SIGKILL 信号,强行终止执行并向前端返回运行超时提示。
二、导致超时的五大常见根源及诊断
明确了编译器的执行机制后,我们可以针对具体代码进行排查。绝大多数运行超时都归因于以下五种典型问题:
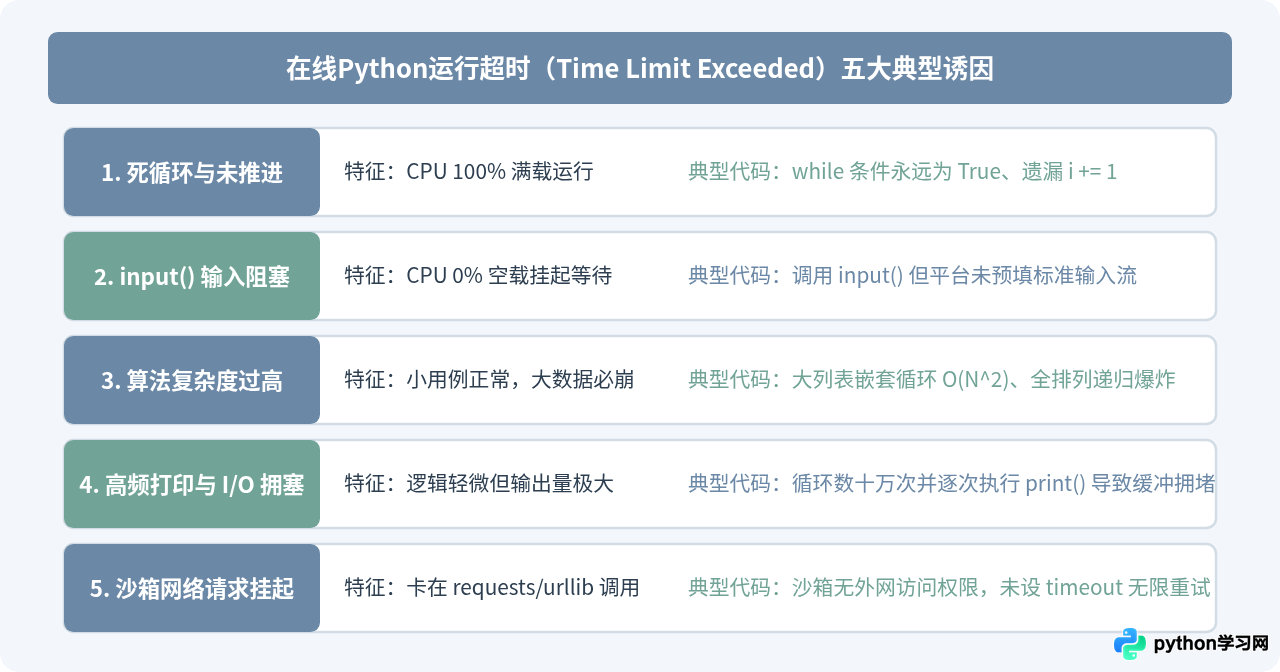
1. 死循环与未正确推进的迭代变量
在编写 while 循环时,如果在循环体内遗漏了对控制条件的更新,或者更新逻辑被 continue 等分支跳过,循环就会无限执行,直到平台强行熔断。
# 错误示例:i 没有自增,条件永远满足,必然超时
i = 0
total = 0
while i < 100000:
    total += i
    # 漏写了 i += 1

# 正确示例:显式推进循环变量
i = 0
total = 0
while i < 100000:
    total += i
    i += 1
RecursionError: maximum recursion depth exceeded。但如果深度设置较大或存在交替递归,则可能在耗尽递归深度前先耗尽执行时间。
2. 等待标准输入(input())导致的无尽阻塞
许多刚接触在线练习平台的读者会遇到一个奇怪现象:代码在本地终端运行正常,但在网页点击运行后立刻超时。这往往是因为代码中包含了 input() 函数。
本地运行 name = input("请输入名字: ") 时,终端会停下来等待用户在键盘输入并回车。但在绝大多数非交互式在线编译器中,并没有实时终端与代码对接。如果平台没有在“标准输入(Stdin)”面板中预填输入数据,解释器在执行到 input() 时就会无限期阻塞等待读取流结束,直到看门狗定时器到期强行杀死进程。
# 易导致超时的写法(当在线平台不支持交互式终端时)
val = input("请输入数据: ")
print("收到:", val)

# 调试与应对方法:优先使用预置变量替代,或确认在平台提供的 stdin 区域填入数据
# 也可以做兼容性防御:
import sys

def get_input():
    line = sys.stdin.readline()
    if not line:
        return "默认测试值"
    return line.strip()
3. 时间复杂度过高,超出算力极限
在线编译器单核 CPU 通常每秒能处理约 $10^7$ 到 $10^8$ 次基础操作。如果算法的时间复杂度为 $O(N^2)$ 或更高,当测试数据集规模达到 $N = 10^5$ 时,计算次数将达到 $10^{10}$ 级别,Python 运行至少需要数十秒,必然触发超时。
# 低效写法:列表成员检测耗时 O(N),整体时间复杂度 O(N^2)
def find_duplicates(data_list):
    duplicates = []
    seen = []
    for item in data_list:
        if item in seen: # 每次查找需遍历整个 seen 列表
            duplicates.append(item)
        seen.append(item)
    return duplicates

# 优化写法:使用集合(Hash Set),查找时间复杂度 O(1),整体 O(N)
def find_duplicates_fast(data_list):
    seen = set()
    duplicates = set()
    for item in data_list:
        if item in seen:
            duplicates.add(item)
        else:
            seen.add(item)
    return list(duplicates)
4. 密集 I/O 与高频 print 调用
打印语句 print() 涉及系统调用和标准输出缓冲刷新。如果把 print() 放在十万级别的循环体内频繁输出,绝大部分耗时都在等待 I/O 缓冲区传输,导致纯算法本该秒级完成的脚本最终超时。
# 低效写法:10万次循环打印 10万次
for i in range(100000):
    print(i) # 频繁系统 I/O 导致超时

# 优化写法:在内存中聚合后一次性输出
import sys
output = '\n'.join(str(i) for i in range(100000))
sys.stdout.write(output + '\n')
5. 沙箱安全策略拦截外部网络请求
在线编译器为了防止被黑客利用进行 DDoS 攻击或扫描内网,一般会对沙箱容器做严格的无外网策略。如果代码中使用了 requests.get() 或 socket 尝试建立网络连接,且没有设置超时参数,脚本就会卡在 TCP 握手重试中,直到平台判定超时。
import requests

# 危险写法:未设置超时,在封闭网络环境中无限等待
# response = requests.get("https://api.example.com/data")

# 安全做法:显式设置短超时,并捕获异常
try:
    response = requests.get("https://api.example.com/data", timeout=3.0)
except requests.exceptions.RequestException as e:
    print("在线环境网络受限或连接超时:", e)
三、系统化排查超时的四步操作流程
遇到在线运行超时时,切忌盲目乱改代码。按照以下四个步骤可以迅速定位瓶颈:
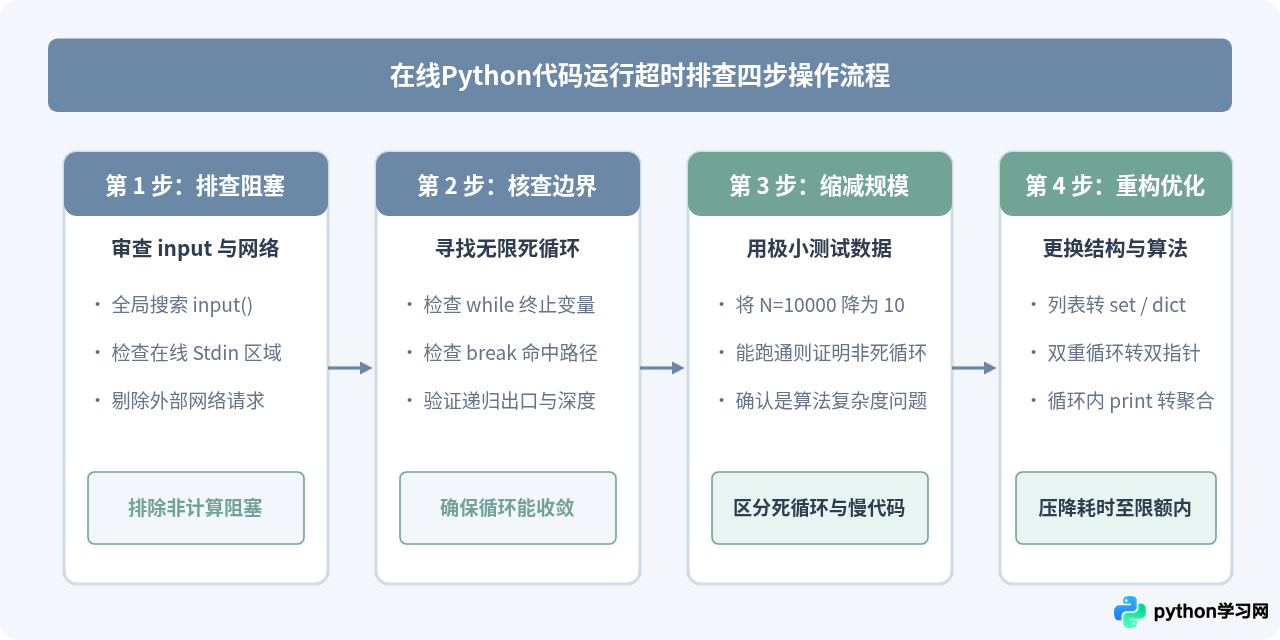
- 第 1 步:排查非计算阻塞。首要任务是检查代码中是否无意中包含了
input()或requests外部网络调用。先注释掉输入并硬编码一个静态变量,再次运行;如果立刻正常输出,说明问题完全在于平台的输入流阻塞。 - 第 2 步:核查循环边界。检查所有
while循环,确认条件中使用的变量在每一次循环中都必定发生向终止条件方向的有效变化;如果是递归,打印递归深度确认基线条件是否被触发。 - 第 3 步:缩减规模法诊断。如果无法肉眼分辨是死循环还是算法执行慢,把输入规模压缩为极小值(例如测试列表长度从 10000 缩减为 5 个元素)。如果极小数据量下仍然超时,100% 是死循环或阻塞;如果极小数据量能秒出正确结果,则证明代码逻辑正确,单纯是时间复杂度无法承受大数据量。
- 第 4 步:重构结构与算法。使用高效的内置容器(哈希表、集合、双端队列),用二分法替代顺序查找,将循环内的频繁
print抽取到循环外部一次性打印。
四、在线环境与本地环境的选择建议
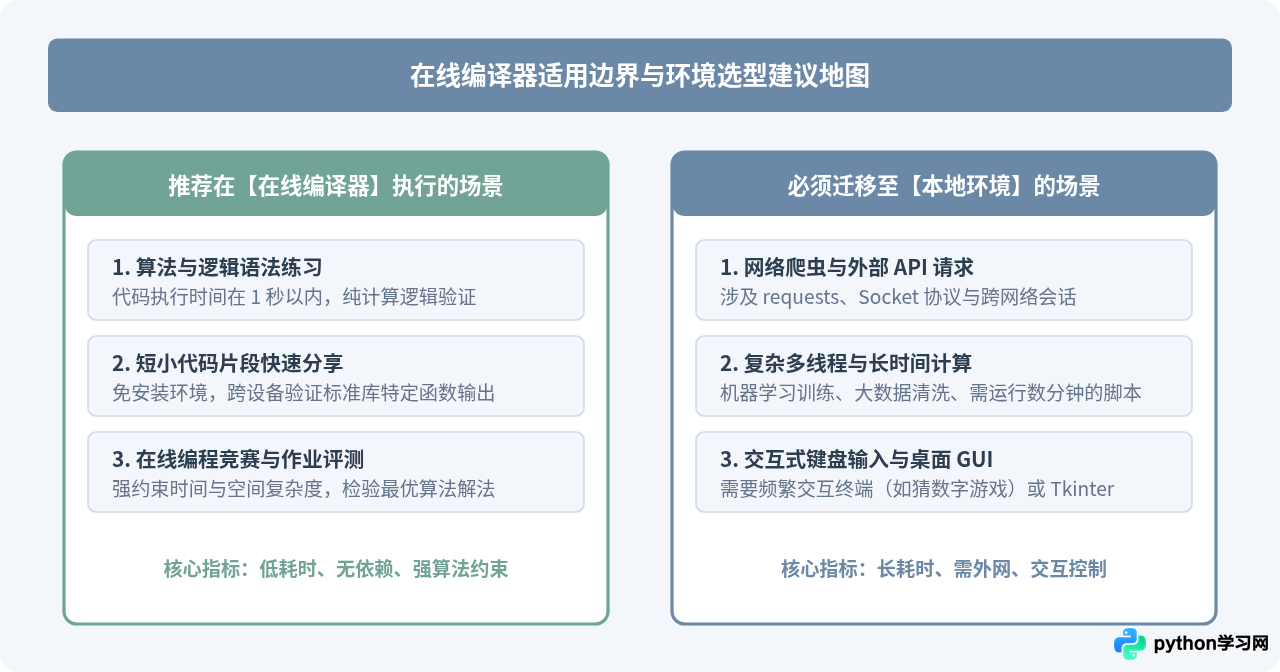
虽然通过算法优化可以解决大部分在线编译器的超时问题,但在线环境由于其沙箱特性,并不适用于所有 Python 开发任务。读者应根据具体任务性质明确环境选择:
五、快速排查与解决速查表
| 现象与报错 | 核心根因 | 直接应对举措 |
|---|---|---|
| 点击运行后立刻转圈至 10 秒超时 | 代码中存在 input() 且无前置标准输入流 |
在平台提供的 Stdin 框中粘贴测试数据,或临时硬编码变量。 |
| 无输入但持续满载至强杀 | while 条件未更新或递归缺少出口 |
检查循环体内是否有 i += 1,确保 break 分支可达。 |
| 小用例秒过,提交大数据用例超时 | 算法时间复杂度为 $O(N^2)$ 或更高 | 使用 set / dict 哈希查找;优化双重循环为双指针或贪心算法。 |
| 计算结果正确,但最后提示超时 | 在循环中频繁调用 print() |
使用 '\n'.join() 汇聚结果后单次输出,避免 I/O 阻塞。 |
调用 requests 时直接超时 |
在线沙箱关闭外网权限导致连接挂起 | 设置 timeout=3 并捕获异常;网络爬虫任务应转至本地环境执行。 |
总结来说,在线Python编译器提示运行超时并非系统故障,而是提示代码触发了平台的安全限额。面对超时提示,先通过排查 input() 阻塞与死循环解决“不收敛”问题,再通过缩减数据规模区分“死循环”与“算法效率瓶颈”,最后利用合适的数据结构和 I/O 优化将耗时压缩到限额以内即可顺利解决。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









