

Python性能分析工具推荐:cProfile与memory_profiler使用详解

排查与解决 Python 程序的运行效率问题,最忌凭直觉臆断哪段代码更慢或更占资源。真正的性能调优通常分为两个清晰的维度:一是运行耗时(CPU执行与函数调用等待),二是空间消耗(内存分配与对象泄漏)。针对这两个核心维度,社区中最成熟、最具实操价值的组合就是 Python 内置的 cProfile 模块与第三方的 memory_profiler 库。本文将围绕这两个工具的实际工作方式、典型调用场景、关键数据解读以及联合诊断方法展开系统讲解。
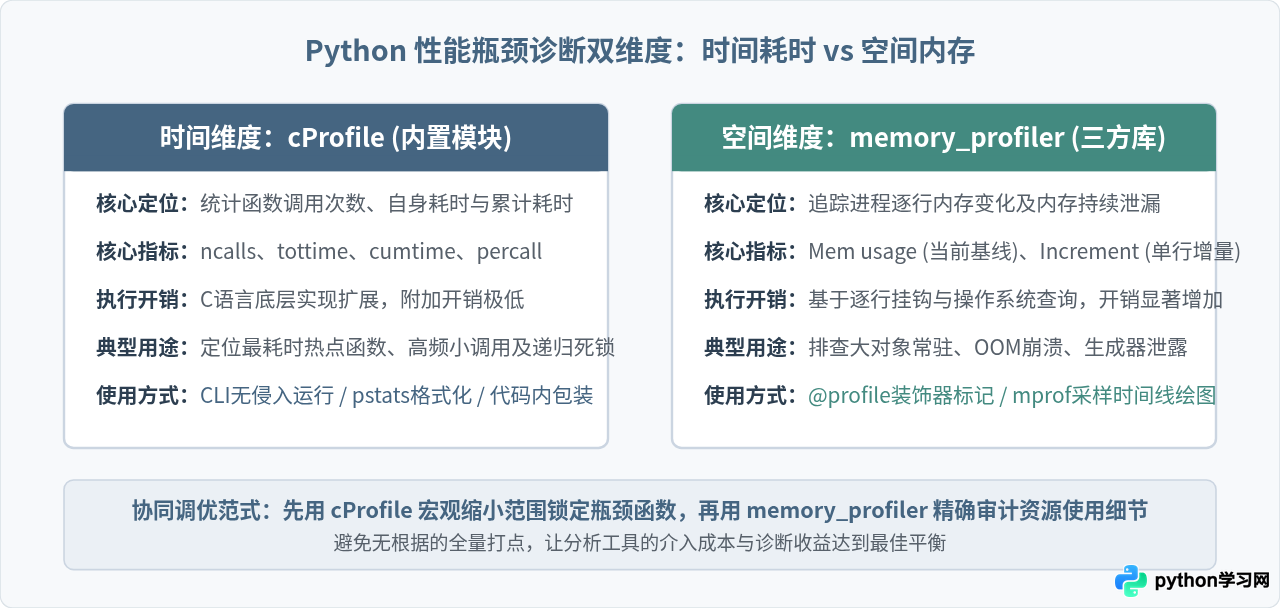
一、cProfile:执行耗时与调用关系分析
cProfile 是 Python 官方标准库自带的确定性性能分析器。与基于计时的纯 Python 实现(如 profile 模块)相比,cProfile 是用 C 语言编写的扩展,在分析过程中产生的钩子开销很小,非常适合分析复杂应用或带有密集计算的场景。
1. 输出核心指标解读
运行 cProfile 后会输出一张统计表格。初次接触时,理解表头的五个关键列名是找到性能热点的关键:
- ncalls:函数的调用次数。如果出现类似于
3/1的斜杠格式,代表存在递归调用,右侧数字为主调次数,左侧数字为含递归在内的总调用次数。 - tottime:函数在自身代码内部执行花费的总耗时(以秒为单位),不包含调用其他子函数所消耗的时间。
- percall(第一列):等于
tottime / ncalls,即该函数每次被调用的自身平均耗时。 - cumtime:累计耗时,指该函数从进入到退出所经历的总时间,包含了调用所有子函数所花费的时间。
- percall(第二列):等于
cumtime / ncalls,即该函数每次调用的平均累计耗时。 - filename:lineno(function):对应函数定义所在的文件绝对路径、起始行号及函数名称。
2. 命令行零侵入运行
对于不需要修改源代码的场景,可以直接在命令行使用 -m cProfile 启动程序,并通过 -s 参数指定排序规则:
# 按照累计耗时(cumtime)降序排列输出前20行
python -m cProfile -s cumtime myscript.py
如果程序输出内容较多或需要保留数据后续分析,建议将分析结果转储为二进制文件:
# 将 profiling 结果保存到 output.prof 文件
python -m cProfile -o output.prof myscript.py
3. 代码段内嵌分析与 pstats 模块
如果只需要对程序中的特定关键函数或业务流程进行分析,可以直接在 Python 代码中使用 cProfile.Profile 对象进行包裹,并结合标准库中的 pstats 模块进行精准过滤与展示:
import cProfile
import pstats
import io

def heavy_computation():
    data = [x ** 2 for x in range(1000000)]
    return sum(data)

# 初始化分析器
profiler = cProfile.Profile()
profiler.enable()

# 执行目标代码
result = heavy_computation()

profiler.disable()

# 格式化输出统计结果
stream = io.StringIO()
stats = pstats.Stats(profiler, stream=stream)
# 按照累计耗时降序排列,并只打印前 10 行关键信息
stats.strip_dirs().sort_stats("cumtime").print_stats(10)

print(stream.getvalue())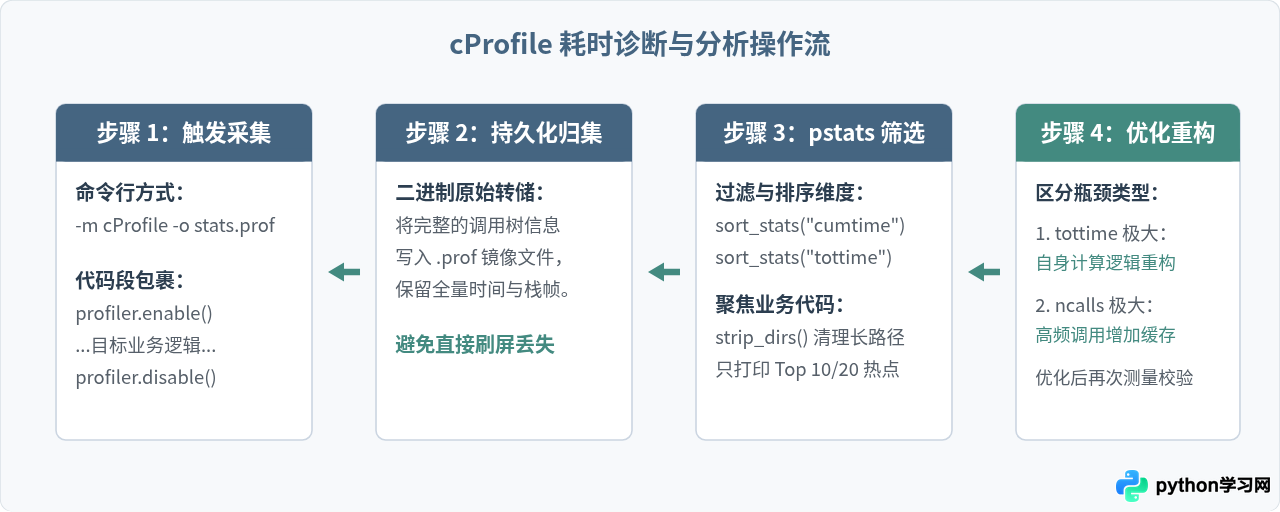
二、memory_profiler:逐行内存分析与泄漏定位
当 Python 进程内存占用居高不下,甚至在循环运行过程中触发操作系统的 OOM Killer(内存溢出终止)时,单靠耗时分析器无法排查问题。此时需要借助 memory_profiler。它能够监控进程的内存增长,并精确提供每一行代码执行前后进程内存的变化增量。
1. 安装与依赖
memory_profiler 是一个第三方模块,依赖 psutil 获取精准的跨平台进程状态。可以通过 pip 进行安装:
pip install memory_profiler psutil matplotlib其中 matplotlib 是可选依赖,但如果需要使用时间线可视化绘图工具 mprof,则必须安装。
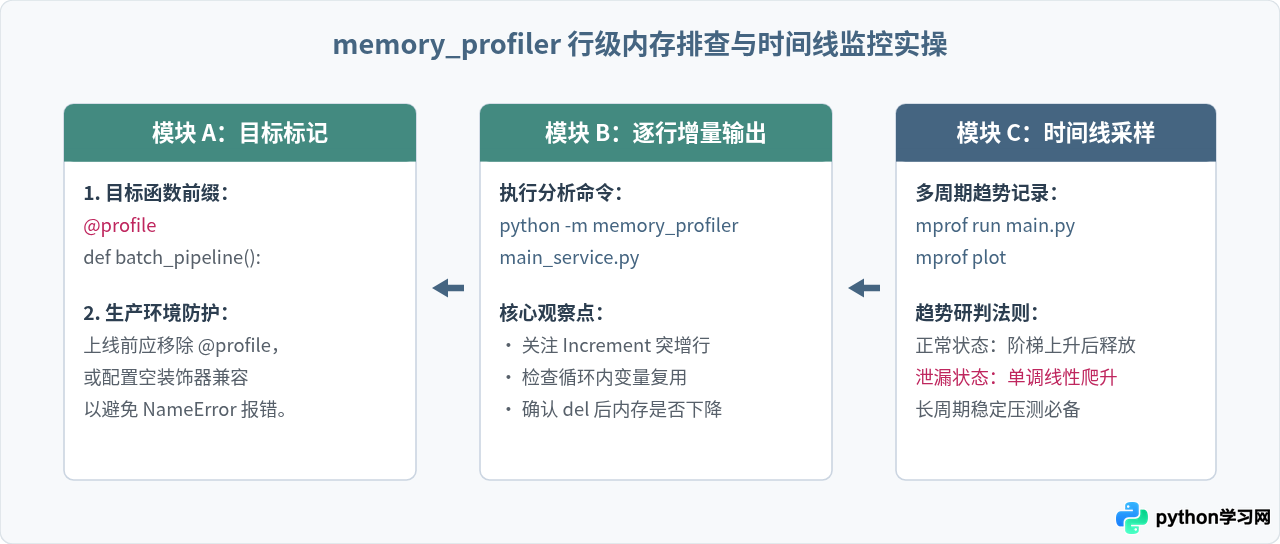
2. 使用 @profile 装饰器进行行级追踪
在待分析的函数上方添加 @profile 装饰器。不需要显式在代码顶部 import profile,运行器会在执行时自动将该装饰器注入全局内置命名空间:
# demo_mem.py
@profile
def load_and_process():
    # 阶段 1:创建一个占用较大内存的列表
    raw_data = [i for i in range(2000000)]

    # 阶段 2:进行过滤计算
    filtered_data = [x for x in raw_data if x % 2 == 0]

    # 阶段 3:显式清理不再使用的大列表
    del raw_data

    return len(filtered_data)

if __name__ == "__main__":
    load_and_process()
在终端使用 -m memory_profiler 运行脚本:
python -m memory_profiler demo_mem.py执行完成后,终端会输出清晰的逐行内存快照:
Line #    Mem usage    Increment  Occurrences   Line Contents
=============================================================
     1     38.4 MiB     38.4 MiB           1   @profile
     2                                         def load_and_process():
     4    115.2 MiB     76.8 MiB           1       raw_data = [i for i in range(2000000)]
     6    154.0 MiB     38.8 MiB           1       filtered_data = [x for x in raw_data if x % 2 == 0]
     8     77.2 MiB    -76.8 MiB           1       del raw_data
    10     77.2 MiB      0.0 MiB           1       return len(filtered_data)
关键数据说明:
- Line #:代码对应行号。
- Mem usage:该行执行完毕后,当前 Python 进程所占用的物理内存总量(MiB)。
- Increment:该行代码执行所带来的内存增量。正数表示内存分配,负数表示对象被垃圾回收释放。通过关注正值显著偏大的行,即可准确定位大对象构建点。
- Occurrences:该行代码被执行的次数(例如处于循环体内部时)。
3. mprof:全生命周期的内存时间线采样
有些内存泄漏并非由单个大列表创建引起,而是在连续处理成千上万个任务时,微小对象未能及时释放带来的累积爬升。针对这种场景,memory_profiler 提供了配套的命令行工具 mprof,它可以以固定时间间隔对进程进行物理内存采样:
# 1. 运行目标脚本并以固定间隔采样内存数据,生成 mprofile_*.dat 文件
mprof run myscript.py

# 2. 调用 matplotlib 将采样数据绘制成可视化时间线折线图
mprof plot
生成的图表横轴为运行时间(秒),纵轴为内存占用(MiB)。如果图表呈现出持续单调递增的锯齿形且没有回落,即可直接证实代码中存在未释放的全局缓存、闭包泄漏或循环引用。
三、两款工具的关键特性与选型对比
在面对具体的性能瓶颈时,很多开发者容易混淆两款工具的适用边界。下面的对照表格整理了两者的核心差异,帮助根据实际问题特征选择诊断工具:
| 对比维度 | cProfile | memory_profiler |
|---|---|---|
| 分析目标 | CPU运行耗时、函数执行频率与调用栈关系 | 物理内存占用量(RAM)、行级内存分配与泄漏 |
| 分析粒度 | 函数级(Function-level)全量调用树 | 单行代码级(Line-by-line)及全局时间线 |
| 性能开销 | 极低(底层为C语言扩展驱动) | 较高(单行执行时均需挂钩查询进程状态,通常放慢10倍以上) |
| 引入依赖 | 内置标准库,无需安装任何额外依赖 | 需安装 memory_profiler 与 psutil |
| 使用侵入性 | 零侵入(可纯命令行启动)或模块内轻量包装 | 需要在目标函数添加 @profile 装饰器 |
| 典型解决场景 | 接口响应过慢、批量计算超时、死循环与高频无效调用 | 内存持续暴涨、容器被 OOM 强杀、大集合数据载入爆仓 |
memory_profiler 对每一行代码执行都会执行内核级别的内存查询,它会使被装饰函数的运行速度显著降低(通常变慢 10 到 50 倍)。因此,严禁在生产环境的高并发主流程中开启它;建议在本地开发环境或使用测试数据集重现问题时使用。
四、联合诊断实战:从宏观到微观定位瓶颈
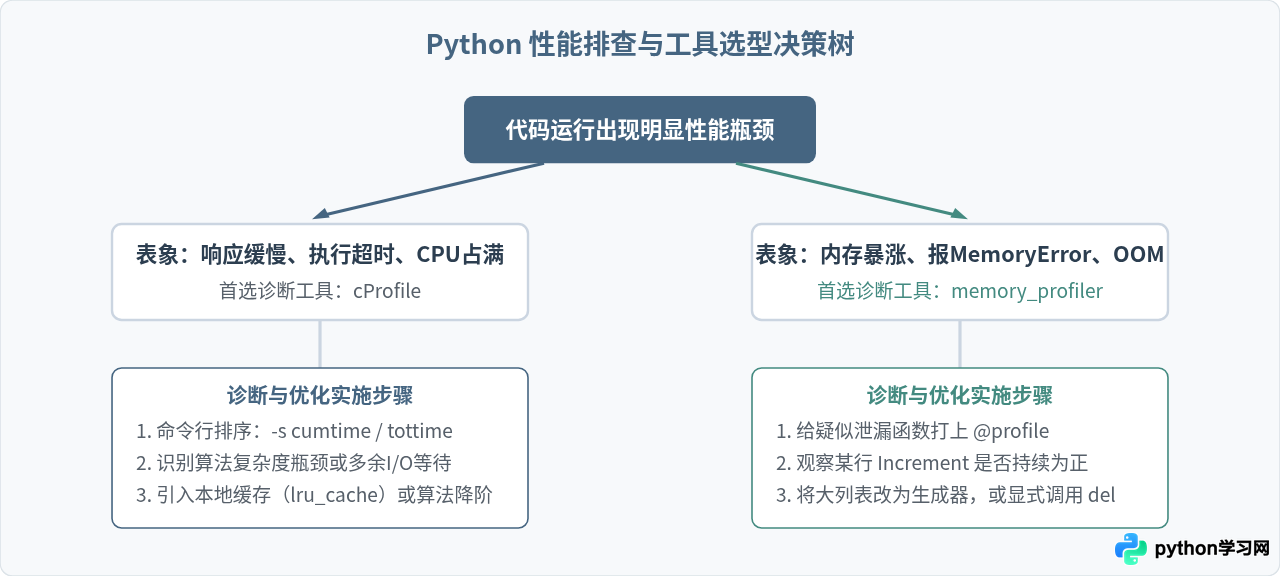
在面对生产中较为复杂的性能问题时,推荐遵循“由宏观到微观、先时间后空间”的递进排查节奏:
- 宏观筛选:首先使用
python -m cProfile -s cumtime main.py运行整个业务主流程。此时不要陷入细节代码,而是观察整个调用栈中耗时最长的前 3 个核心函数。 - 识别计算特征:
- 如果发现
tottime主要集中在内置的排序、哈希检索或特定数学计算函数上,说明是算法设计问题,此时应针对该热点函数进行算法降阶或改写循环。 - 如果发现耗时主要集中在等待外部响应或大文件读写上,则属于 I/O 密集型,此时应考虑并发或异步处理。
- 如果耗时随处理的数据批次成非线性增长,且程序运行逐渐变卡顿,往往伴随着内存分配的开销与垃圾回收停顿。
- 如果发现
- 微观锁定:对上一步锁定的重点函数添加
@profile,使用memory_profiler逐行观察其内存创建情况。很多时候,将一次性全量加载的列表表达式[...]替换为惰性求值的生成器表达式(...),不仅能大幅降低数十倍的内存占用,还能因消除频繁的大块内存申请而显著缩短运行时间。
五、总结
cProfile 与 memory_profiler 构成了 Python 性能调优中最实用的基础工具箱。cProfile 作为标准库工具,具有零侵入、低开销、全视角的优势,是排查执行缓慢、定位热点代码的第一道关卡;而 memory_profiler 凭借精准的行级内存增量与 mprof 时间线采样,是揪出内存泄漏、消除 OOM 隐患的利器。在日常开发与重构中,先通过量化测量锁定根因,再进行有针对性的代码重构,才能避免无效优化,写出真正高效、稳健的 Python 应用程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









