

Python在线编译器运行超时或报错的常见原因与解决

很多初学者在使用网页端Python在线编译器时,经常遇到代码还没输出结果就弹出“Time Limit Exceeded”(运行超时)或者莫名报出“EOFError”、“NameError”的情况。在线编译器的底层机制不同于本地已安装的Python解释器,它运行在云端隔离的轻量容器或受限沙箱中,有着严格的单次运行时间截断(通常为5秒至15秒)、内存上限与受限的输入输出通道。理解这些运行边界并掌握针对性的排查步骤,能够帮助我们快速定位问题并恢复正常的调试体验。
一、运行超时(Time Limit Exceeded)的常见原因与解决
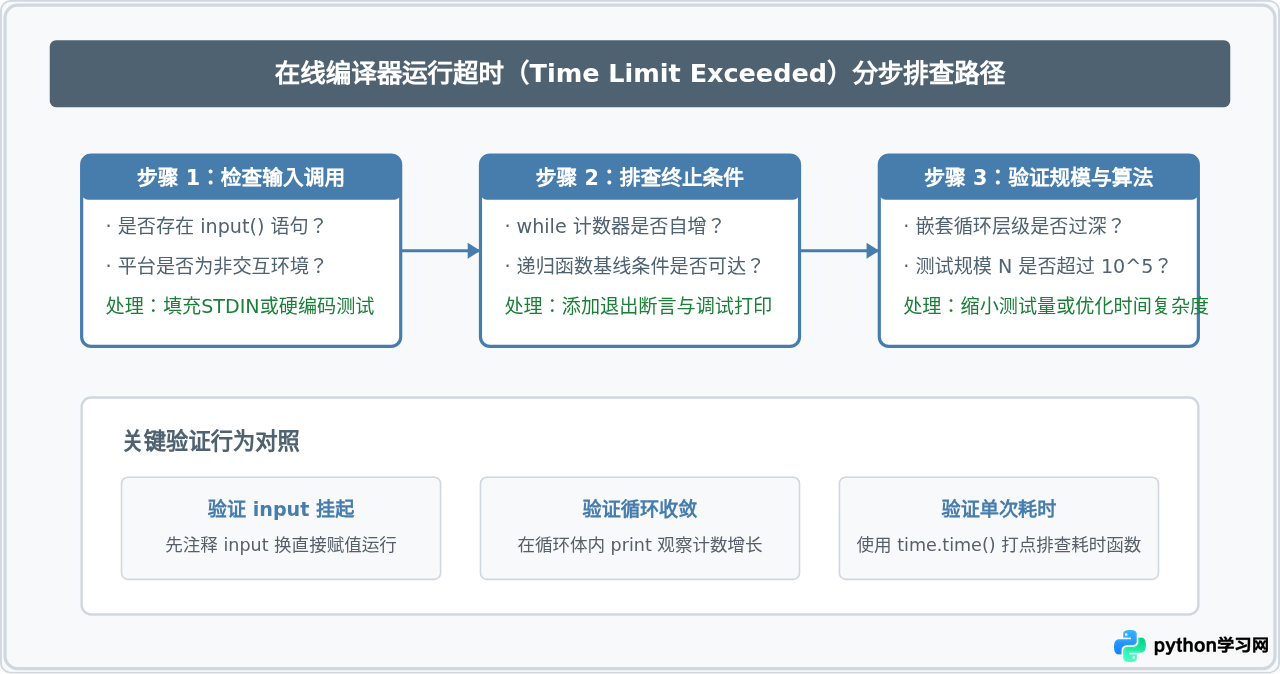
运行超时意味着云端看门狗(Watchdog)在设定时限到达后强制终止了执行进程。这通常并非服务器计算性能不足,而是代码逻辑陷入了“无终止循环”或在等待外部无法提供的输入数据。
1. 交互式输入阻塞:未提供预置输入的 input()
本地IDE(如PyCharm或VS Code终端)允许用户在控制台实时打字交互,但多数轻量在线编译器采用非交互式标准输入(Non-interactive STDIN)。当执行到 input() 时,程序会一直等待终端送入数据:
- 如果在线平台不支持实时键盘输入,也没有在运行前配置“标准输入文本框”,进程便会永远停滞在输入指令处,直到平台计时耗尽判定为超时。
- 在部分平台上,该情况甚至会抛出
EOFError: EOF when reading a line。
解决方法:在在线平台右侧或下方的“STDIN / 输入设置”面板中,提前填入测试所需的输入文本;若纯粹测试算法逻辑,建议直接在代码中将输入值赋值给变量:
# 改造前(在线编译器可能因无交互终端而阻塞超时):
# age = int(input("请输入年龄: "))

# 改造后(直接使用模拟数据排查后续逻辑):
age = 18
print(f"测试年龄为: {age}")
2. 条件未迭代或步长缺失的死循环
while 循环条件始终为真是在线超时的第二大高发点。只要循环体内遗漏了状态更新,程序在毫秒内就能空转上百万次,直接触发平台的超时防御。
# 错误示例:缺少步长更新
count = 0
while count < 10:
    # 忘记写 count += 1,导致循环永远无法终止
    pass

# 正确示例:确保循环条件有明确收敛路径
count = 0
while count < 10:
    count += 1
print("计算完成:", count)
3. 数据规模过大与未记忆化的深层递归
在线沙箱单核算力通常受到限制。如果测试用例直接使用大规模列表循环(如双重 for 遍历 $10^5$ 级元素),或者使用朴素递归计算斐波那契数列(指数级复杂度 $O(2^n)$),极易触碰5秒限制。此时应当改用带备忘录的动态规划,或者缩小测试数据集进行验证。
二、沙箱与环境限制引发的运行报错
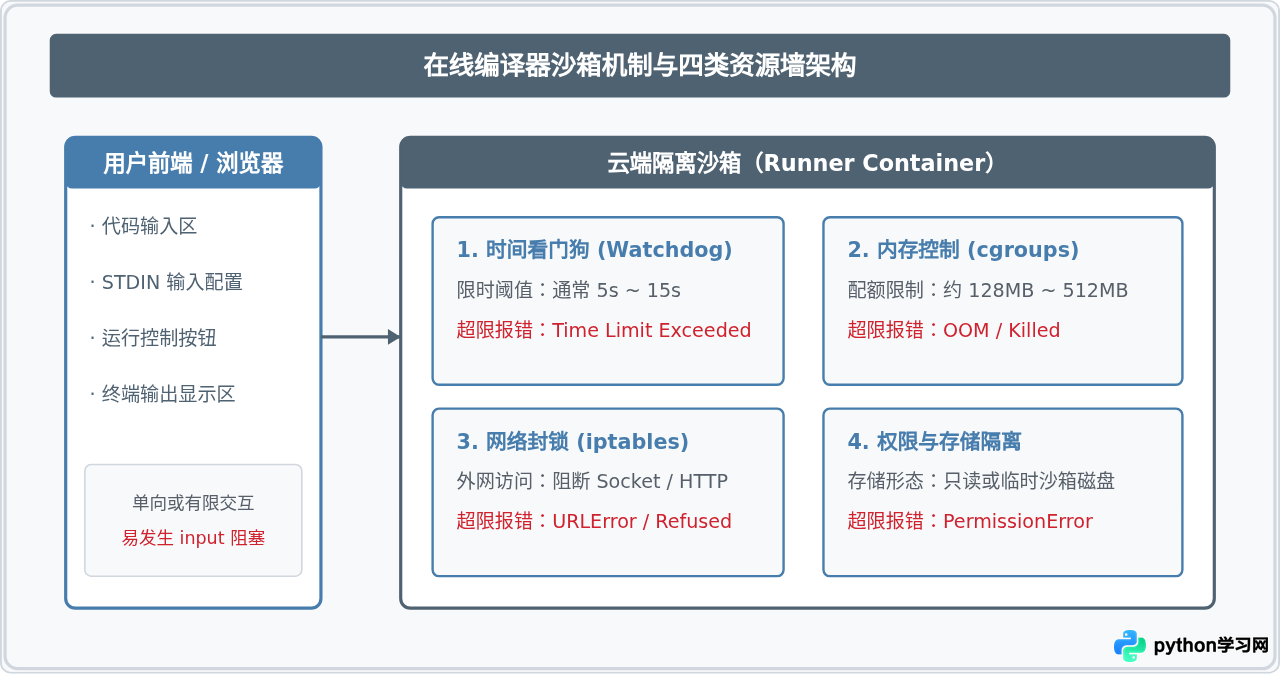
在线编译器的后端并非毫无保留地执行所有Python指令。为了多租户安全与服务器稳定性,平台会在轻量容器中对资源与系统调用加以严密限制,这也是产生各类异常报错的核心源头。
1. ModuleNotFoundError:第三方库未安装
许多学习者在学习爬虫、图像处理或数据分析时,习惯直接导入第三方库(如 import requests、import numpy 或 import cv2)。普通在线编译器通常只预装了 Python 核心标准库(如 math、random、datetime、os 等)。当尝试导入未配置在云端基础镜像中的模块时,解释器便会抛出:
ModuleNotFoundError: No module named 'requests'
解决途径:检查平台是否提供包管理器开关(如某些平台左侧的“Packages / 依赖管理”面板支持键入名称自动安装);若使用的是轻量单页编译器且无法安装外部包,应使用Python内置库替代(例如使用内置的 urllib.request 替代 requests),或者迁移至本地环境执行。
2. 内存超限(OOM)与 RecursionError
在线容器分配给单次任务的内存通常在 128MB 到 512MB 之间。如果代码一次性读取几百兆的大文本,或者在列表中不断追加海量数据,会触发操作系统的 OOM-Killer(内存溢出终止),在前端表现为“Process killed”或“Memory Limit Exceeded”。此外,Python默认最大递归深度一般为 1000 层,超出时会抛出 RecursionError: maximum recursion depth exceeded。
3. 网络请求与本地文件系统被禁止
出于网络安全防范与防范肉鸡攻击的考虑,大部分在线环境通过 Linux cgroups / iptables 完全禁用了外部网络访问(Socket Connect),并对本地磁盘进行了只读挂载(Read-only rootfs):
- 调用外部 API、爬取外网网页时抛出
urllib.error.URLError或ConnectionRefusedError。 - 尝试使用
open("data.txt", "w")写入文件时抛出PermissionError: [Errno 13] Permission denied或Read-only file system。
三、常见语法与运行时报错对照解决
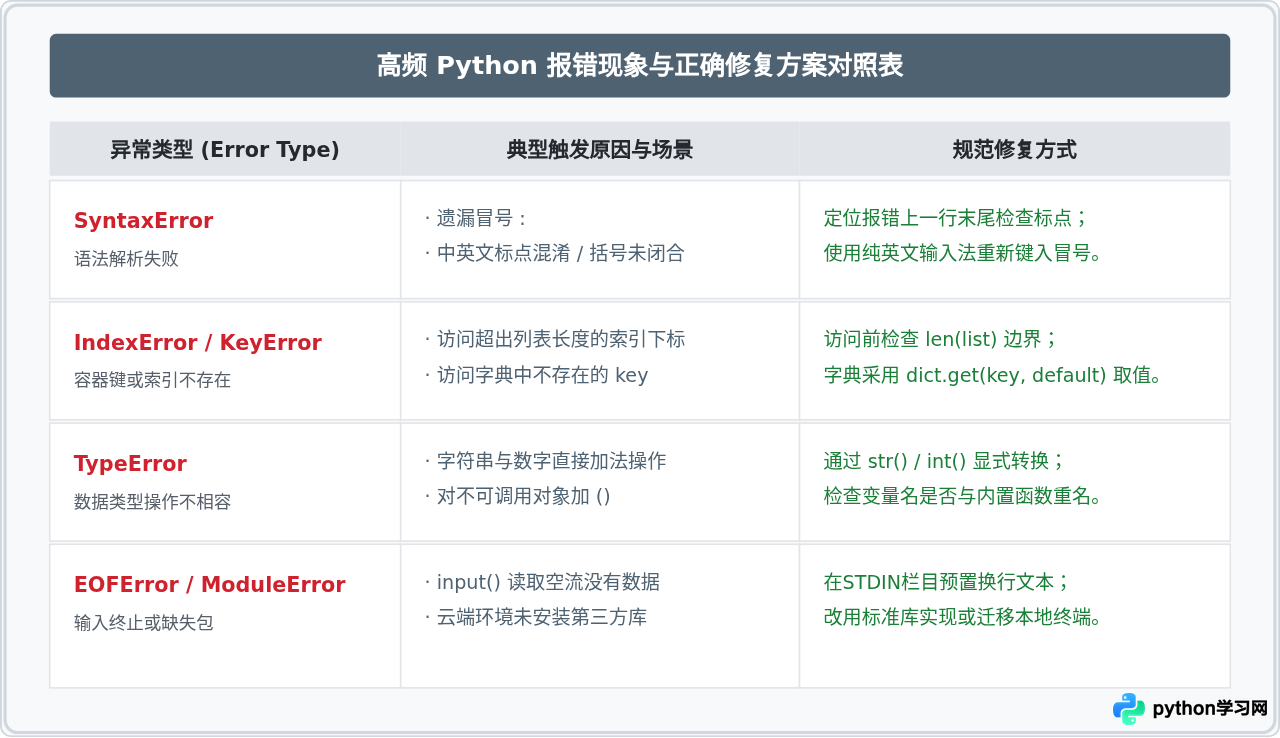
除了沙箱机制带来的限制,多数初学者遇到的报错仍然源自Python基础语法或变量引用的疏漏。在线编译器的错误回溯(Traceback)能直接指出出错的文件行号与异常名称,学会识别高频报错是解决问题的关键技能。
1. SyntaxError:语法错误(冒号、括号与缩进)
SyntaxError: invalid syntax 发生在代码编译阶段。只要语法不符合规范,代码甚至不会开始执行第一行。最常见的漏写包括:
- 在
if、for、while、def、class语句末尾漏写英文半角冒号:。 - 括号、单双引号未成对闭合,或者误用了中文标点符号(如中文分号
;或中文引号“”)。 - 缩进混合了空格与制表符(在 Python 3 中严禁同一代码块混用 Tab 和 Space,报错为
TabError: inconsistent use of tabs and spaces in indentation)。
2. NameError 与 UnboundLocalError:未定义或提前引用
当执行到未声明的标识符时,会抛出 NameError: name 'xxx' is not defined。常见成因:
- 拼写错误或大小写不匹配:Python严格区分大小写,如把
True误写为true,或变量名user_id误敲为userId。 - 定义顺序颠倒:在调用变量或函数的语句之后才编写其定义代码。
- 局部变量遮蔽:在函数内部尝试修改同名全局变量而未声明
global。
3. TypeError 与 ValueError:类型与传参不匹配
初学者在处理数字和文本输入时,最常遇到类型不相容的问题。例如直接拼接字符串与整数:
# 错误代码:字符串与整型不能直接使用 + 拼接
score = 95
# print("成绩为: " + score) # 抛出 TypeError: can only concatenate str (not "int") to str

# 正确写法:采用类型转换或格式化字符串(f-string)
print(f"成绩为: {score}")
此外,使用 int("abc") 解析非数字字符时会触发 ValueError: invalid literal for int() with base 10: 'abc',在执行类型转换前需要确保输入字符合法。
四、排查调试技巧与自查总结
当面对在线编译器中复杂的逻辑错误或意外的输出结果时,合理利用以下排查方法能大幅缩短定位故障的时间:
1. 分段插入 print 探针排查卡顿点
如果代码运行超时且无法确定是哪一行卡住,可以在关键循环和函数入口处添加清晰的打印语句。通过输出的最后一行文字,能立刻圈定死循环或阻塞发生的具体代码块:
print("--- 步骤 1:开始读取数据 ---")
# 某些处理
print("--- 步骤 2:进入核心运算循环 ---")
for i in range(10):
    # 如果输出在此中断,说明问题在循环内部
    pass
print("--- 步骤 3:运算完成 ---")
2. 确认在线编译器与本地环境的适用边界
在线编译器非常适合快速验证语法细节、练习算法逻辑、展示简短的代码片段。但如果你的任务涉及以下场景,应当毫不犹豫切换回本地 Python 环境:
- GUI 界面开发:如
tkinter、PyQt,在线环境无桌面图形渲染通道。 - 音视频与本地硬件调用:如摄像头读取、多声卡播放等。
- 复杂网络爬虫与并发:需要大量发送 HTTP 异步请求、绕过反爬机制的任务。
- 本地多文件项目管理:跨模块导入多个
.py业务文件以及大规模数据库操作。
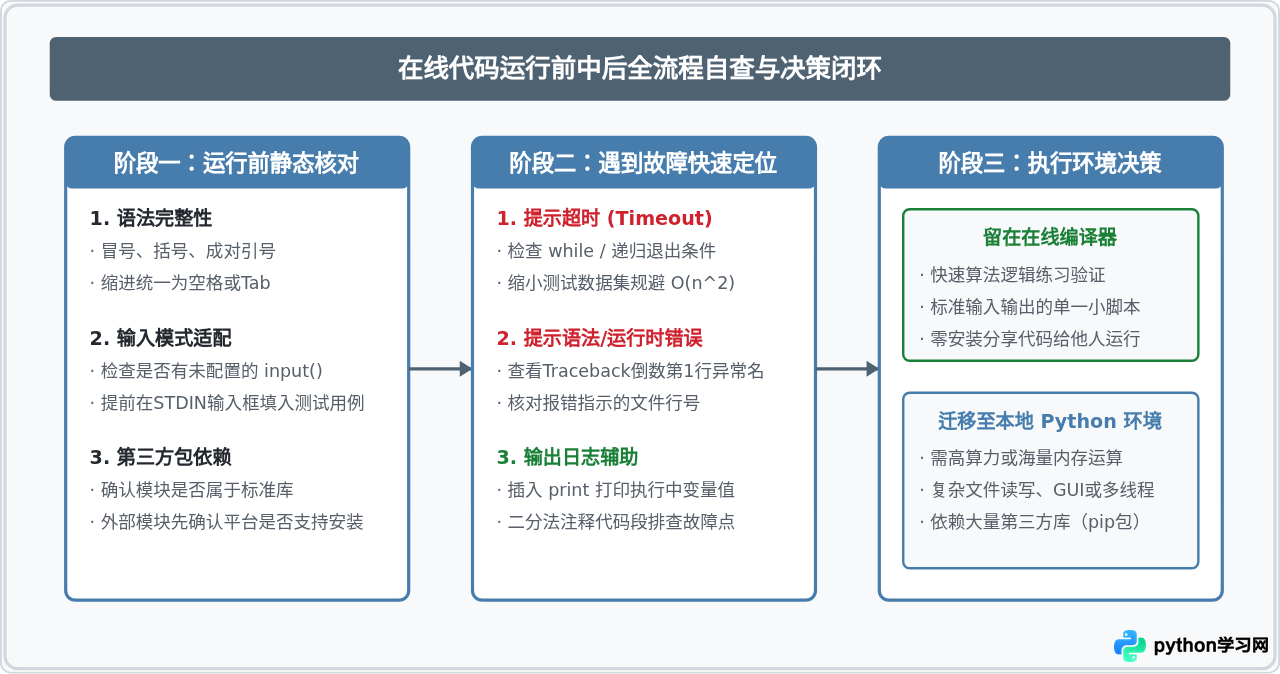
总的来说,遇到在线编译器报错或超时,不要盲目重复点击运行按钮。首先通过异常名称区分是“语法错误”、“沙箱权限超限”还是“逻辑死循环”;其次利用标准输入预置(STDIN)或硬编码临时变量排除输入挂起;最后根据任务规模与第三方库依赖,理智选择是在线微调还是转入本地环境,即可高效解决各类运行障碍。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









