

怎么在Python在线编译器中处理stdin输入数据?
讲解在各类Python在线编译器中如何正确配置和读取标准输入(stdin)数据,涵盖单行读取、多行批量处理、常见报错排查及性能优化技巧。
在本地终端运行 Python 脚本时,程序执行到 input() 会暂停并等待用户实时敲击键盘;但在多数在线编译器(如 LeetCode、牛客网、Programiz 或各种在线 OJ 平台)中,代码往往运行在隔离的沙盒容器内,并不支持实时的人机交互对话。要在这些网页工具中正常获取输入,核心解决路径是将所需数据预先填入平台提供的 STDIN 输入框,再配合 Python 对应的标准输入读取方法(如 input()、sys.stdin.read() 或 sys.stdin.readline())进行解析。
在线编译器读取 stdin 的运行机制
理解在线编译器的输入机制,是避免各种输入报错的第一步。主流网页端 Python 运行平台通常分为两种运行模型:
- 非交互式批处理模式(最常见): 平台提供一个名为“STDIN”、“Standard Input”或“测试用例输入”的独立文本框。用户在点击运行前,必须把所有需要的数据一次性写入该区域。后端执行代码时,会通过管道重定向直接将这段文本灌入 Python 进程的标准输入流中。当数据读完后再调用读取函数,会直接触发 EOF(文件结束符)。
- 交互式 Web 终端模式: 少数平台(如基于 xterm.js 配合 WebSocket 或 WebAssembly/Pyodide 的运行环境)支持类似真实终端的交互,允许在输出面板中实时等待并敲击键盘。但出于安全和服务器资源回收考虑,大多数评测机均强制采用批处理模式。
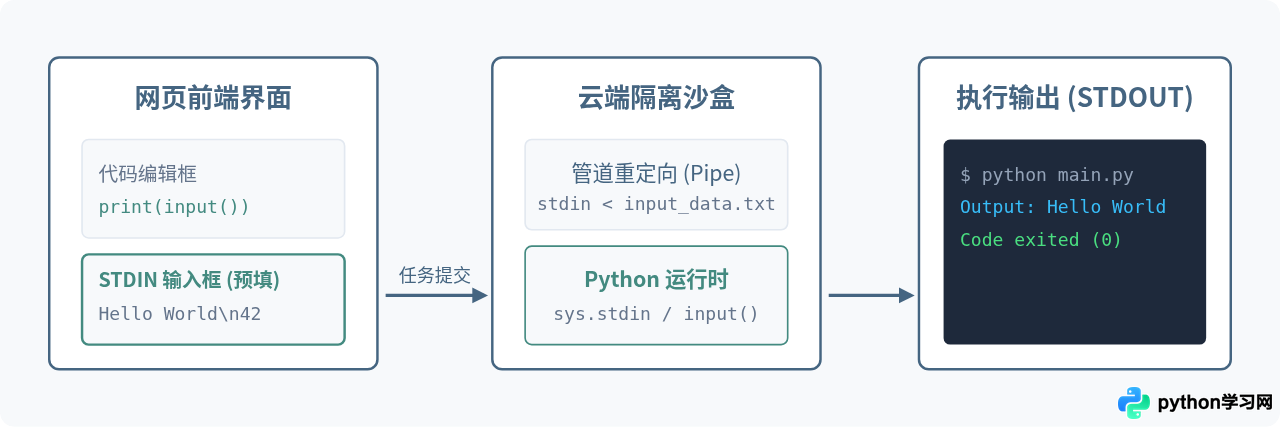
在在线编译器中配置与执行输入的具体步骤
要在大部分网页在线平台成功执行带输入的 Python 程序,请按照以下标准化流程操作:
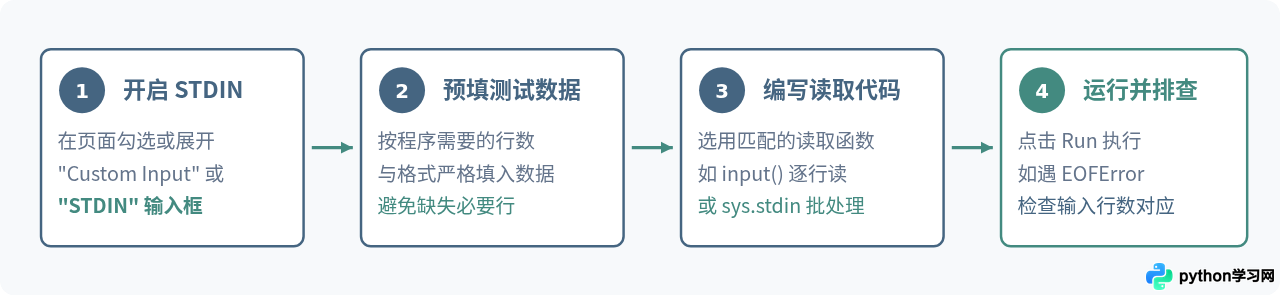
- 定位并启用输入区域: 打开在线编译器(如 Ideone、OnlineGDB 或各类在线学习平台)页面,寻找标有 "Custom Input"、"Interactive Mode off"、"Command Line Arguments / STDIN" 或 "STDIN" 的折叠面板或复选框,确保其处于启用状态。
- 填入待处理数据: 在该文本框中完整粘贴需要测试的数据。若程序需要输入 3 行,输入框中必须保证至少换行输入 3 行数据。
- 编写无提示语句的代码: 避免写类似
input("请输入您的名字:")的提示语,因为在很多在线平台中,该提示字符会被作为标准输出混入最终结果,导致自动化用例比对失败。推荐直接使用input()。 - 点击 Run 执行并验证: 在结果面板查看程序输出。
常见数据读取场景与代码实现
根据在线评测或实际运算中输入数据组织形式的不同,主要有以下几种读取策略:
1. 读取单行与固定行数数据
当输入数据量较小且行数固定时,input() 是最直接的方式。input() 每次读取一行,并自动去除行尾的换行符 \n。
# 场景:STDIN 输入框中有两行数据
# 第一行为用户名,第二行为两个以空格分隔的整数

name = input().strip()
a, b = map(int, input().split())

print(f"User: {name}")
print(f"Sum: {a + b}")
15 27
Sum: 42
2. 读取未知行数的数据(直到输入结束)
在算法练习或在线评测中,经常遇到“没有说明具体输入多少行,读到文件末尾为止”的题目。在本地按回车无法结束输入,但在重定向了 stdin 的在线编译器中,可以通过异常捕获或 sys.stdin 来精准处理。
方式 A:使用 try...except EOFError 处理 input()
lines = []
while True:
    try:
        line = input()
        lines.append(line)
    except EOFError:
        # 当输入流中的数据全部读取完毕时,input() 会抛出 EOFError
        break

print(f"共接收到 {len(lines)} 行数据")
方式 B:直接遍历 sys.stdin(推荐)
sys.stdin 本身就是一个可迭代的文件对象,直接用 for 循环迭代是 Python 中处理未知行数最优雅、最高效的方式。需要注意,每次迭代得到的字符串末尾包含换行符 \n,通常需要使用 .strip() 清理。
import sys

total = 0
for line in sys.stdin:
    line = line.strip()
    if not line:
        continue  # 忽略可能存在的空行
    total += int(line)

print(f"数值求和结果为: {total}")
3. 一次性读取全部内容
如果需要一次性获取所有输入文本进行统一的正则匹配或切分,直接调用 sys.stdin.read() 是最高效的选择:
import sys

# 一次性读入所有内容为一个完整字符串
raw_data = sys.stdin.read()

# 使用 split() 自动按所有空白字符(空格、换行、制表符)分割为元素列表
tokens = raw_data.split()
print(f"提取到的所有词元列表: {tokens}")
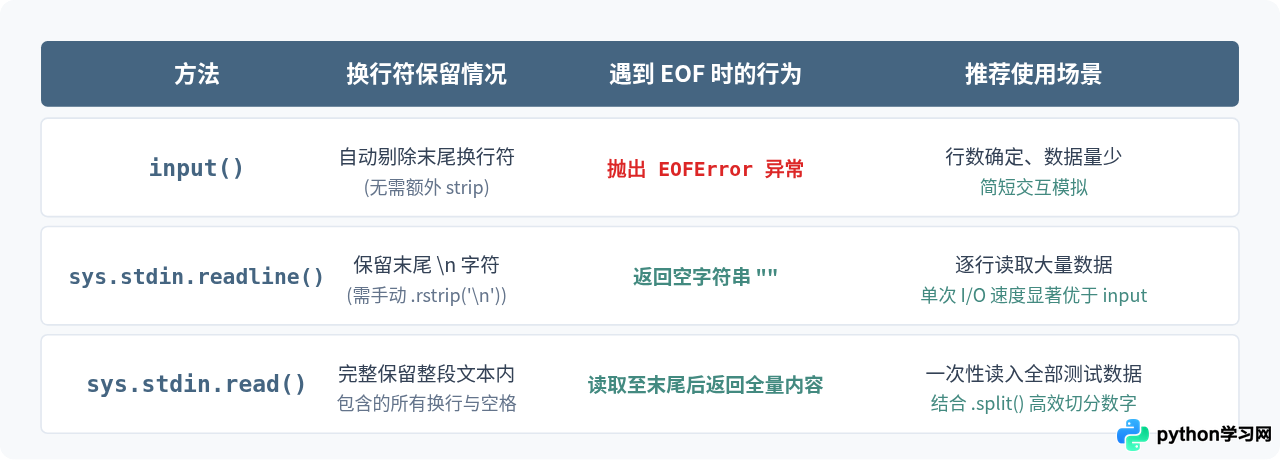
三种主要 stdin 读取方式的适用场景与差异
不同读取函数在遇到输入末尾(EOF)时的表现、是否保留换行符以及处理大数据量时的吞吐性能均存在客观差异:
高频报错与调试要点
1. EOFError: EOF when reading a line
这是在线编译器中最常出现的错误。其根本原因是:代码中执行读取函数(如 input())的次数,超过了在 STDIN 输入框中实际提供的行数。
- 检查在线编辑器的“自定义输入(Custom Input/STDIN)”选项是否被打勾激活。未激活时,输入流为空文件,第一次调用
input()就会立即崩溃。 - 检查循环读取逻辑,确保有合理的退出条件,或使用
try...except EOFError将读取包裹起来。
2. 提示文本被判为“输出错误”
在本地终端编程时,我们习惯写 name = input("Enter your name: ")。但如果平台判定输出是严格比对 STDOUT,这段提示字符串也会被当做程序的输出结果,进而导致与预期输出不匹配。在在线编译运行环境下,务必保持 input() 括号内为空。
3. 大规模输入下的 Time Limit Exceeded (TLE)
当在线题目或测试数据集包含数万甚至数十万行输入时,input() 的执行耗时相对较高。这是因为 input() 在底层每次都需要处理标准输出刷新及末尾换行符的动态剥离。此时推荐将 input 别名重定向至 sys.stdin.readline:
import sys
# 在文件头部重定向,后续即可保持 input() 的书写习惯,同时享受 C 级别的读取速度
input = sys.stdin.readline

# 注意:readline 会保留末尾换行符,如果读取字符串建议加上 strip()
first_line = input().strip()
总结与速查清单
在 Python 在线编译器中正确操作 stdin 数据,关键在于牢记“预先填入、匹配读取、防护末尾”三大原则:
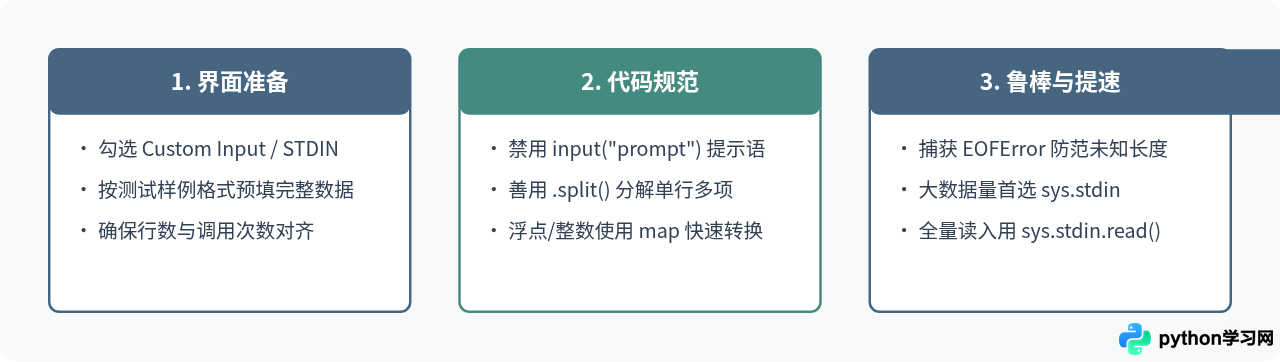
只要根据实际数据量选好对应的读取函数,并在提交运行前在配置面板补齐预设输入,就能彻底解决在线调试 Python 时因标准输入引发的中断与报错问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









