

Python re模块正则表达式使用详解:匹配、替换与分割

本文详细解析Python中re模块的核心功能,涵盖match、search、findall等匹配方法,sub替换及split分割操作。通过具体代码示例演示参数pattern、string及flags的使用,重点讲解分组匹配与Match对象属性获取,帮助开发者掌握字符串处理技巧。
一、前言
Python内置了re模块以支持正则表达式操作。在实际开发中,开发者可以直接调用re模块提供的函数(如search()、match()、findall()等)对字符串进行处理;或者先通过compile()方法将正则模式字符串编译为正则表达式对象,再利用该对象的方法执行字符串操作。
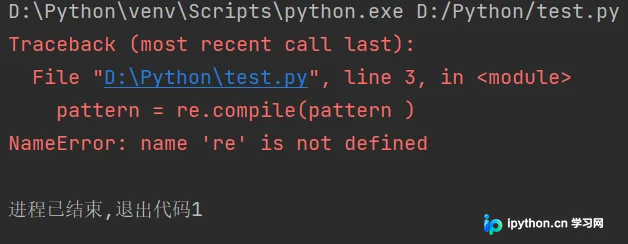
若在代码中未导入re模块而直接调用相关方法,程序将抛出异常,具体报错信息如图所示:
二、匹配字符串
利用re模块进行字符串匹配,主要依赖match()、search()和findall()等内置方法。
1.使用match()方法进行匹配
match()方法旨在从字符串起始位置尝试匹配。若起始位置匹配成功,则返回一个Match对象;若失败,则返回None。其语法结构如下:
re.match(pattern, string, [flags])
参数说明:
- pattern:代表模式字符串,即由正则表达式转换而来的匹配规则。
- string:代表待匹配的原始字符串。
- flags:可选参数,用于控制匹配行为(例如是否忽略大小写)。常用标志位详见下表:
| 标志 | 说明 |
|---|---|
| A或ASCII | 对于\w、\W、\b、\B、\d、\D、\s和\S只进行ASCII匹配(仅适用于Python3.X) |
| I或IGNORECASE | 执行不区分字母大小写的匹配 |
| M或MULTILINE | 将^和$用于包括整个字符串的开始和结尾的每一行(默认情况下,仅适用于整个字符串的开始和结尾处) |
| S或DOTALL | 适用(.)字符匹配所有字符,包括换行符 |
| X或VERBOSE | 忽略模式字符串中未转义的空格和注释 |
例如,判断字符串是否以“mr_”开头,且忽略大小写,实现代码如下:
import re

pattern = r"mr_\w+" #模式匹配字符串
string = "MR_SHOP mr_shop" #要匹配的字符串
match = re.match(pattern,string,re.I)#匹配字符,不区分大小写
print(match) #输出匹配结果
string = "项目名称MR_SHOP mr_shop"
match = re.match(pattern,string,re.I)#匹配字符,不区分大小写
print(match) #输出匹配结果
执行结果如下:
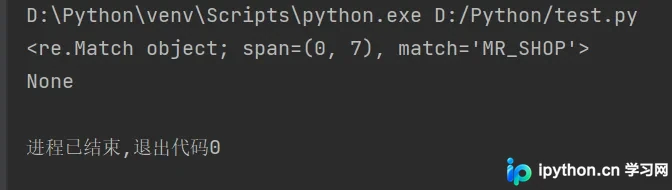
从上述运行结果可见,字符串“MR_SHOP”因以“mr_”开头(忽略大小写)而返回Match对象;而“项目名称MR_SHOP”因起始字符不符合条件,直接返回None。这是因为match()严格从字符串首字符开始匹配,一旦首字符不满足条件即停止并返回None。
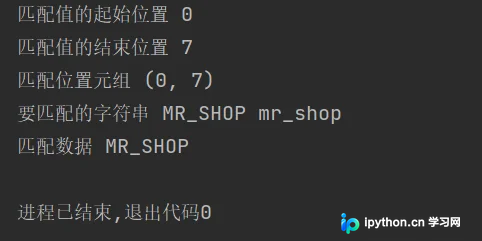
Match对象中封装了匹配内容的起始位置及具体数据,相关属性与方法包括:
- 调用Match对象的start()方法可获取匹配内容的起始索引;
- 调用end()方法可获取匹配内容的结束索引;
- 通过span()方法可返回包含起始和结束位置的元组;
- 利用string属性可获取原始待匹配字符串。
具体代码如下:
import re
pattern = r"mr_\w+"  # 模式匹配字符串
string = "MR_SHOP mr_shop"  # 要匹配的字符串
match = re.match(pattern, string, re.I)  # 匹配字符,不区分大小写
print("匹配值的起始位置", match.start())
print("匹配值的结束位置", match.end())
print("匹配位置元组", match.span())
print("要匹配的字符串", match.string)
print("匹配数据", match.group())
执行结果如下:
2.使用search()方法进行匹配
search()方法用于在整个字符串中搜索第一个符合正则表达式的子串。若找到匹配项,返回Match对象;否则返回None。语法格式如下:
re.search(pattern, string, [flags])
参数说明:
- pattern:代表模式字符串,由正则表达式转换而来。
- string:代表待匹配的字符串。
- flags:可选参数,用于控制匹配方式(如是否区分大小写)。
例如,针对以“mr_”开头的字符串进行不区分大小写的匹配,代码如下:
import re

pattern = r"mr_\w+" #模式匹配字符串
string = "MR_SHOP mr_shop" #要匹配的字符串
match = re.search(pattern,string,re.I)#匹配字符,不区分大小写
print(match) #输出匹配结果
string = "项目名称MR_SHOP mr_shop"
match = re.search(pattern,string,re.I)#匹配字符,不区分大小写
print(match) #输出匹配结果
执行结果如下:
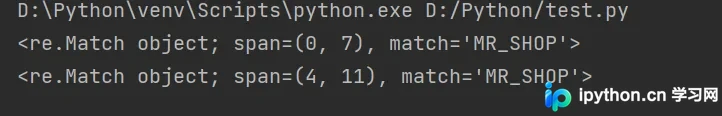
对比运行结果可知,search()方法不仅限于字符串起始位置,只要字符串中任意位置存在符合模式的子串,即可成功匹配。
3.使用findall()方法进行匹配
findall()方法用于在整个字符串中查找所有符合正则表达式的子串,并以列表形式返回。若匹配成功,返回包含所有匹配结果的列表;若无匹配项,则返回空列表。语法格式如下:
re.findall(pattern, string, [flags])
参数说明:
- pattern:代表模式字符串,由正则表达式转换而来。
- string:代表待匹配的字符串。
- flags:可选参数,用于控制匹配方式(如是否区分大小写)。
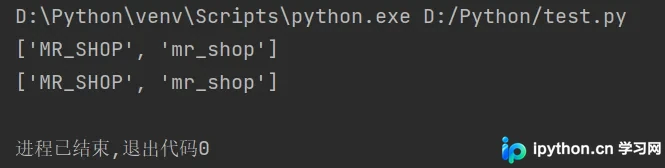
例如,对以“mr_”开头的字符串进行不区分大小写的匹配,代码如下:
import re

pattern = r"mr_\w+" #模式匹配字符串
string = "MR_SHOP mr_shop" #要匹配的字符串
match = re.findall(pattern,string,re.I)#匹配字符,不区分大小写
print(match) #输出匹配结果
string = "项目名称MR_SHOP mr_shop"
match = re.findall(pattern,string,re.I)#匹配字符,不区分大小写
print(match) #输出匹配结果
执行结果如下:
若模式字符串中包含分组(括号部分),findall()将返回与分组匹配的文本列表,而非整个模式的匹配结果。例如:
import re

pattern = r"[1-9]{1,3}(\.[0-9]{1,3}){3}"  # 模式字符串
str1 = "127.0.0.1 192.168.1.66"  # 要匹配的字符串
match = re.findall(pattern, str1)  # 进行模式匹配
print(match)
执行结果如下:
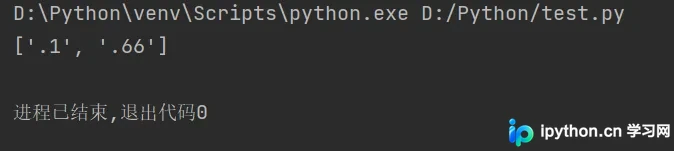
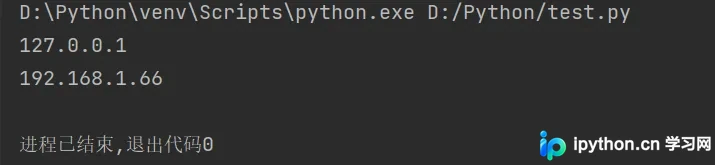
从上述结果可见,并未直接获取到完整的IP地址,原因在于模式中使用了分组,导致返回的是分组内的匹配内容,即“(.[0-9]{1,3})”的匹配结果。若需获取整个模式的匹配值,可将整个模式用一对小括号包裹形成分组,并在处理结果时,仅提取返回列表中每个元组的第1个元素。代码如下:
import re

pattern = r"([1-9]{1,3}(\.[0-9]{1,3}){3})"  # 模式字符串
str1 = "127.0.0.1 192.168.1.66"  # 要匹配的字符串
match = re.findall(pattern, str1)  # 进行模式匹配
for item in match:
    print(item[0])
执行结果如下:
三、替换字符串
sub()方法用于执行字符串替换操作,语法格式如下:
re.sub(pattern, sep1, string, count, flags)
参数说明:
- pattern:代表模式字符串,由正则表达式转换而来。
- sep1:代表用于替换的新字符串。
- string:代表原始待处理字符串。
- count:可选参数,指定最多替换的次数。
- flags:可选参数,用于控制匹配方式(如是否区分大小写)。
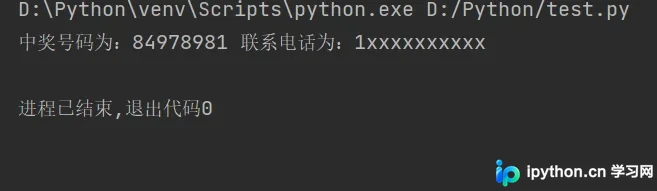
import re

pattern = r"1[34578]\d{9}"  # 定义要替换的模式字符串
string = "中奖号码为:84978981 联系电话为:13611111111"
result = re.sub(pattern, "1xxxxxxxxxx", string)
print(result)
执行结果如下:
四、使用正则表达式分割字符串
split()方法(注:原文拼写为splist,此处按标准修正或保留原意说明)用于根据正则表达式分割字符串,并以列表形式返回。其功能类似于字符串对象的split()方法,区别在于分割符由正则模式指定。语法格式如下:
re.split(pattern, string, [maxsplit], [flags])
参数说明:
- pattern:代表模式字符串,由正则表达式转换而来。
- string:代表待分割的字符串。
- maxsplit:可选参数,指定最大分割次数。
- flags:可选参数,用于控制匹配方式(如是否区分大小写)。
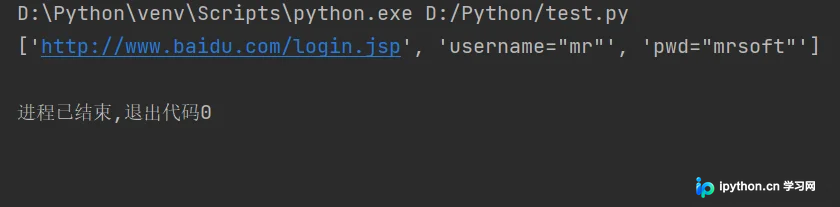
例如,从给定的URL地址中提取请求路径及参数,代码如下:
import re

pattern = r"[?|&]"  # 定义分割符
url = 'http://www.baidu.com/login.jsp?username="mr"&pwd="mrsoft"'
result = re.split(pattern, url)  # 分割字符串
print(result)
执行结果如下:
总结
本文介绍了Python中re模块实现正则表达式匹配、替换与分割的核心操作。更多Python正则表达式相关内容,可参考本站过往文章或继续浏览后续教程,感谢支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









