

Python实现阿里云盘资源抓取与按时间排序

本文介绍如何使用Python抓取第三方网站的阿里云盘资源,并通过解析网页获取资源名称、日期及链接。脚本自动按时间降序排列结果,解决原网站排序混乱问题。同时,利用模板生成可直接访问的HTML报告,提升使用便捷性。
近期阿里云盘因赠送大量存储空间且下载不限速而备受关注,其体验远优于百度网盘。目前存在第三方网站可搜索阿里云盘资源,但其默认排序并非按时间排列,导致早期失效资源排在前面。为此,使用Python进行抓取并按时间重新排序,能更有效地定位有效资源。
网页分析
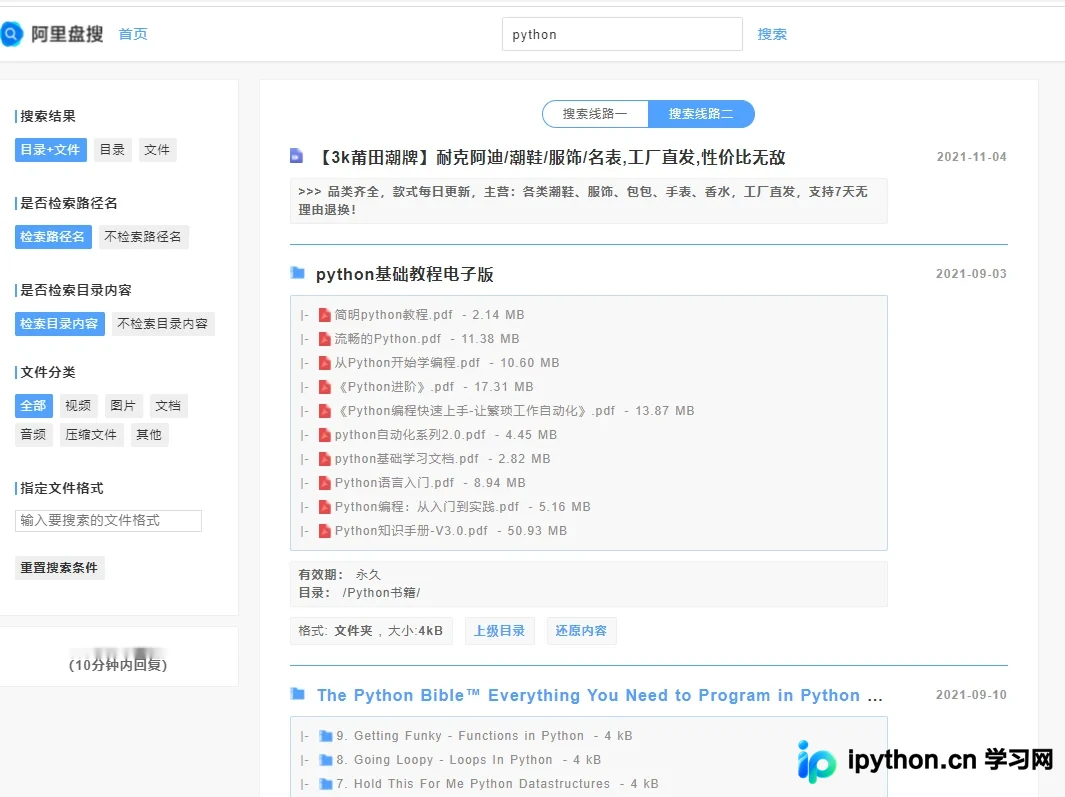
该网站提供两种搜索路径:搜索线路一和搜索线路二。本文教程基于搜索线路二进行开发。
通过浏览器开发者工具中的网络面板,可以观察到一个针对 seach.html 的 GET 请求。
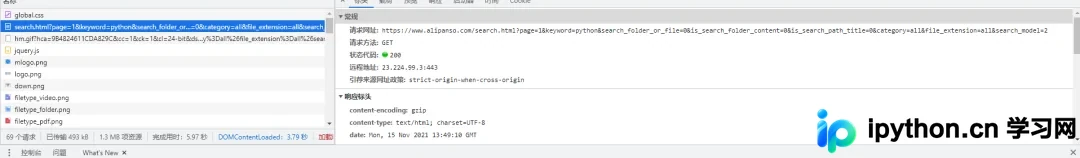
该请求包含多个参数,其中四个为关键参数:
- page:表示当前搜索的页码。
- keyword:用户输入的搜索关键词。
- category:文件分类,可选值包括 all(全部)、video(视频)、image(图片)、doc(文档)、audio(音频)、zip(压缩文件)和 others(其他)。脚本中默认设置为 all。
- search_model:指定使用的搜索线路。
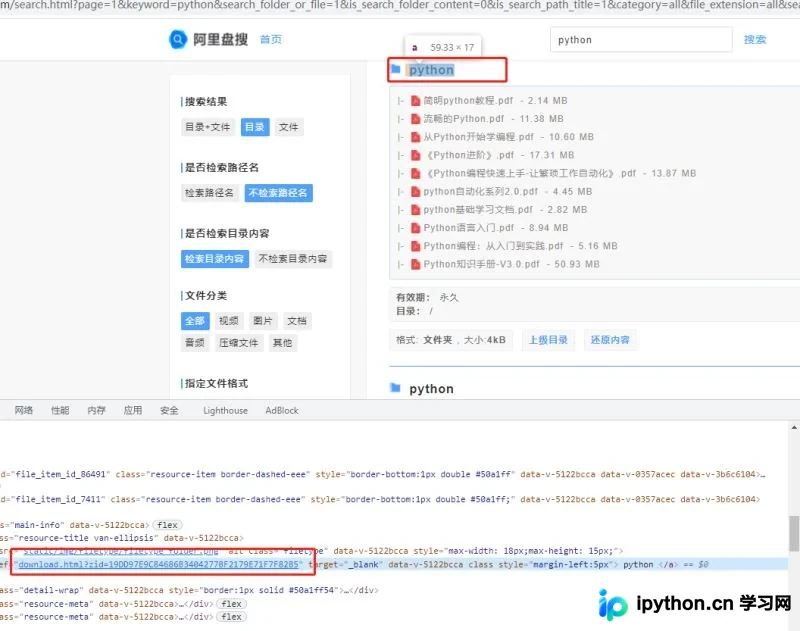
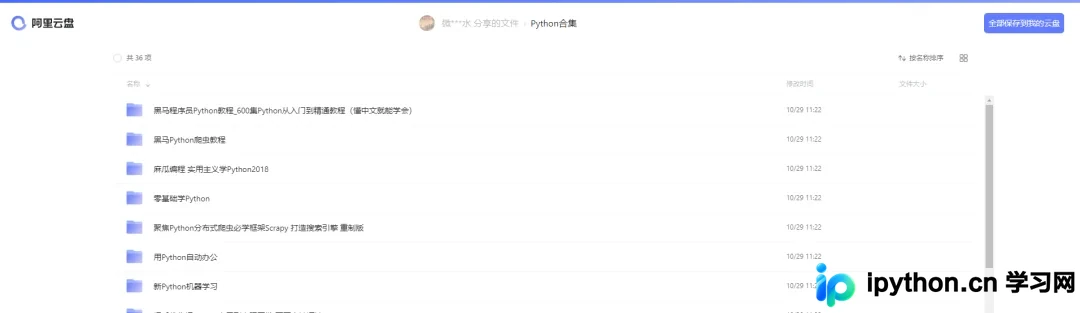
同样在开发者工具中观察到,网页通过跳转至阿里云盘获取真实链接。使用 bs4 解析页面中 class 为 resource-item border-dashed-eee 的 div 标签下的 a 标签,即可获取跳转至网盘的地址;同时解析该 div 下的 p 标签以获取资源发布日期。
抓取与解析
首先,需要安装 bs4 第三方库以支持页面解析功能。
pip3 install bs4
以下是抓取并解析网页的脚本代码,最终结果将按日期进行降序排列。
import requests
from bs4 import BeautifulSoup
import string


word = input('请输入要搜索的资源名称:')

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36'
}

result_list = []
for i in range(1, 11):
    print('正在搜索第 {} 页'.format(i))
    params = {
        'page': i,
        'keyword': word,
        'search_folder_or_file': 0,
        'is_search_folder_content': 0,
        'is_search_path_title': 0,
        'category': 'all',
        'file_extension': 'all',
        'search_model': 0
    }
    response_html = requests.get('https://www.alipanso.com/search.html', headers = headers,params=params)
    response_data = response_html.content.decode()

    soup = BeautifulSoup(response_data, "html.parser");
    divs = soup.find_all('div', class_='resource-item border-dashed-eee')

    if len(divs) <= 0:
        break

    for div in divs[1:]:
        p = div.find('p',class_='em')
        if p == None:
            break

        download_url = 'https://www.alipanso.com/' + div.a['href']
        date = p.text.strip();
        name = div.a.text.strip();
        result_list.append({'date':date, 'name':name, 'url':download_url})

    if len(result_list) == 0:
        break

result_list.sort(key=lambda k: k.get('date'),reverse=True)
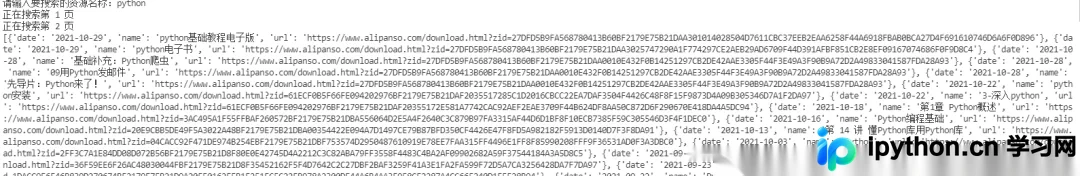
示例输出结果如下:
模板
抓取内容后,若需逐个复制到 Google 浏览器中访问,操作较为繁琐。若能直接点击访问则更为便捷。因此,这里利用 Python 的模板功能生成一个 HTML 文件,以优化访问体验。
模板文件基于 elements-ui 构建,关键代码如下:
<body>
    <div id="app">
        <el-table :data="table" style="width: 100%" :row-class-name="tableRowClassName">
            <el-table-column prop="date" label="日期" width="180"> </el-table-column>
            <el-table-column prop="name" label="名称" width="600"> </el-table-column>
            <el-table-column label="链接">
              <template slot-scope="scope">
              <a :href="'http://'+scope.row.url" rel="external nofollow"
                target="_blank"
                class="buttonText">{{scope.row.url}}</a>
            </template>
        </el-table>
    </div>

    <script>
      const App = {
        data() {
          return {
              table: ${elements}

          };
        }
      };
      const app = Vue.createApp(App);
      app.use(ElementPlus);
      app.mount("#app");
    </script>
  </body>
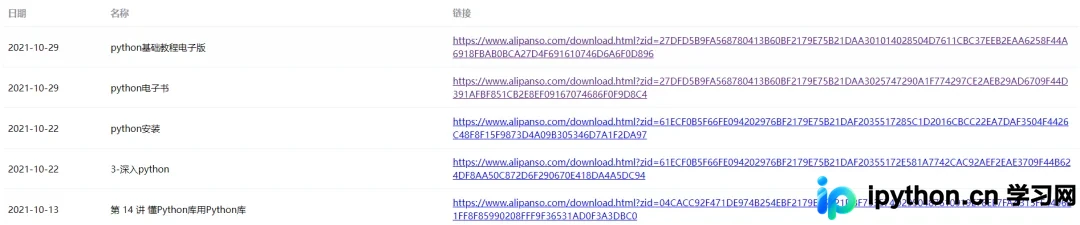
在 Python 中读取该模板文件,并将 ${elements} 占位符替换为上述解析得到的结果数据。最终生成名为 report.html 的文件。
with open("aliso.html", encoding='utf-8') as t:
    template = string.Template(t.read())

final_output = template.substitute(elements=result_list)
with open("report.html", "w", encoding='utf-8') as output:
    output.write(final_output)
生成的模板示例结果如下:
跳转到阿里云盘界面
完整代码
aliso.html
<html>
  <head>
    <meta charset="UTF-8" />
    <meta name="viewport" content="width=device-width,initial-scale=1.0" />
    <script src="https://unpkg.com/vue@next"></script>
    <!-- import CSS -->
    <link rel="stylesheet" href="https://unpkg.com/element-plus/dist/index.css">
    <!-- import JavaScript -->
    <script src="https://unpkg.com/element-plus"></script>
    <title>阿里云盘资源</title>
  </head>
  <body>
    <div id="app">

        <el-table :data="table" style="width: 100%" :row-class-name="tableRowClassName">
            <el-table-column prop="date" label="日期" width="180"> </el-table-column>
            <el-table-column prop="name" label="名称" width="600"> </el-table-column>
            <el-table-column label="链接">
              <template v-slot="scope">
              <a :href="scope.row.url"
                target="_blank"
                class="buttonText">{{scope.row.url}}</a>
            </template>
        </el-table>
    </div>

    <script>
      const App = {
        data() {
          return {
              table: ${elements}

          };
        }
      };
      const app = Vue.createApp(App);
      app.use(ElementPlus);
      app.mount("#app");
    </script>
  </body>
</html>
aliso.py
# -*- coding: UTF-8 -*-

import requests
from bs4 import BeautifulSoup
import string


word = input('请输入要搜索的资源名称:')

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/96.0.4664.45 Safari/537.36'
}

result_list = []
for i in range(1, 11):
    print('正在搜索第 {} 页'.format(i))
    params = {
        'page': i,
        'keyword': word,
        'search_folder_or_file': 0,
        'is_search_folder_content': 0,
        'is_search_path_title': 0,
        'category': 'all',
        'file_extension': 'all',
        'search_model': 2
    }
    response_html = requests.get('https://www.alipanso.com/search.html', headers = headers,params=params)
    response_data = response_html.content.decode()

    soup = BeautifulSoup(response_data, "html.parser");
    divs = soup.find_all('div', class_='resource-item border-dashed-eee')

    if len(divs) <= 0:
        break

    for div in divs[1:]:
        p = div.find('p',class_='em')
        if p == None:
            break

        download_url = 'https://www.alipanso.com/' + div.a['href']
        date = p.text.strip();
        name = div.a.text.strip();
        result_list.append({'date':date, 'name':name, 'url':download_url})

    if len(result_list) == 0:
        break

result_list.sort(key=lambda k: k.get('date'),reverse=True)
print(result_list)

with open("aliso.html", encoding='utf-8') as t:
    template = string.Template(t.read())

final_output = template.substitute(elements=result_list)
with open("report.html", "w", encoding='utf-8') as output:
    output.write(final_output)
总结
使用 Python 编写小型爬虫,不仅能去除网站上的广告干扰,还能显著提升资源获取的便利性。
以上就是利用Python抓取阿里云盘资源的详细内容,更多关于Python抓取云盘资源的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









