

Python正则表达式提取中英文数字详解:sub、findall与compile用法

本文详细介绍Python中利用正则表达式提取字符串中英文及数字的三种核心方法。通过re.sub替换非目标字符、findall匹配所有子串以及compile预编译优化性能,结合具体代码示例,演示如何高效处理混合文本数据,适用于数据处理与清洗场景。
前言
在数据处理过程中,提取字符串中的中英文内容是一项常见需求。最高效且常用的方法是通过正则表达式进行判断与处理。以下整理的相关笔记旨在提供实用的解决方案,希望对读者有所帮助。
一、re模块中的sub函数
Python内置的re模块提供了sub函数,专门用于替换字符串中符合正则表达式匹配规则的部分。
re.sub(pattern, repl, string, count=0)
参数说明如下:
- pattern:定义正则匹配模式的字符串。
- repl:用于替换匹配内容的字符串或函数。
- string:需要进行替换操作的原始字符串。
- count:指定替换的最大次数,默认为0,表示替换所有匹配项。
1.1 提取中文
思路在于将非中文字符替换为空字符串,从而保留中文内容。
具体示例如下:
import re
str = "重出江湖hello的地H方。。的,world"
str = re.sub("[A-Za-z0-9\,\。]", "", str)
print(str)
输出:神的孩子在唱歌
1.2 提取英文
import re
str = "重123出江湖hello的地H方。。的,world"
str = re.sub("[\u4e00-\u9fa5\0-9\,\。]", "", str)
print(str)
输出:helloHworld
1.3 提取数字
import re
str = "重123出江湖hello的地H方。。的,world"
str = re.sub("[A-Za-z\u4e00-\u9fa5\,\。]", "", str)
print(str)
输出:123
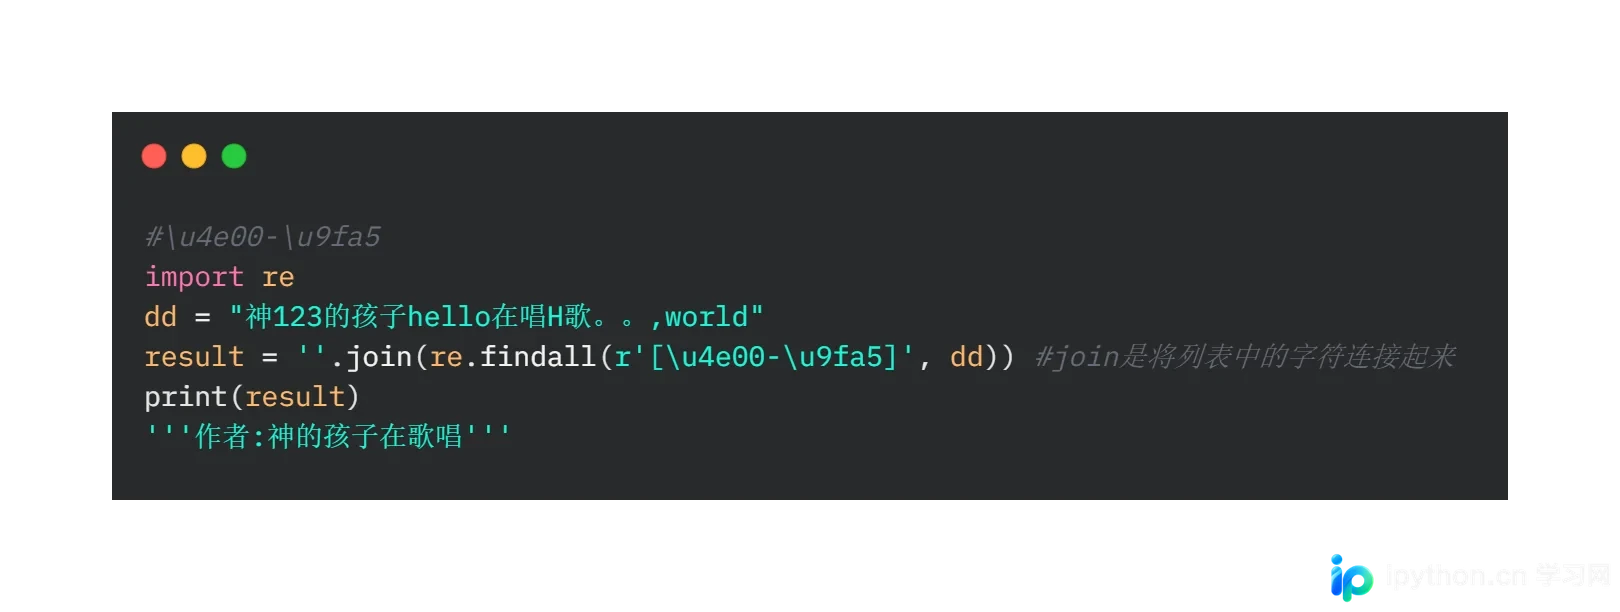
二、re模块中的findall函数
findall函数用于在字符串中查找所有符合正则表达式的子串,并以列表形式返回。若未找到匹配项,则返回空列表。
其语法格式为:
findall(string[, pos[, endpos]])
参数说明:
- string:待匹配的源字符串。
- pos:可选参数,指定搜索起始位置,默认为0。
- endpos:可选参数,指定搜索结束位置,默认为字符串长度。以下示例展示了查找字符串中所有数字的方法:
扩展知识:正则表达式中match和search仅匹配一次,而findall用于匹配所有结果。如需了解更多细节,可参考菜鸟教程等相关文档。
具体了解可以到菜鸟教程查看
2.1 提取中文
2.2 提取英文
通俗写法
import string#提供a-z的小写字母
dd = "神的孩子hello在H唱歌,world"
#准备英文字符
temp=""
letters=string.ascii_lowercase#包含a-z的小写字母
for word in dd:#for循环取出单个词
    if word.lower() in letters:#判断是否是英文
        temp+=word#添加组成英文单词
print(temp)
输出:helloHworld
正则
#A-Za-z
import re
dd = "重出123江湖hello的地方的,world"
result = ''.join(re.findall(r'[A-Za-z]', dd))
print(result)
输出:helloHworld
2.3 提取数字
#0-9注意这个数字前面不能\,要不然他连,都给算上
import re
dd = "神123的孩子hello在唱H歌。。,world"
result = ''.join(re.findall(r'[0-9]', dd))
print(result)
输出:123
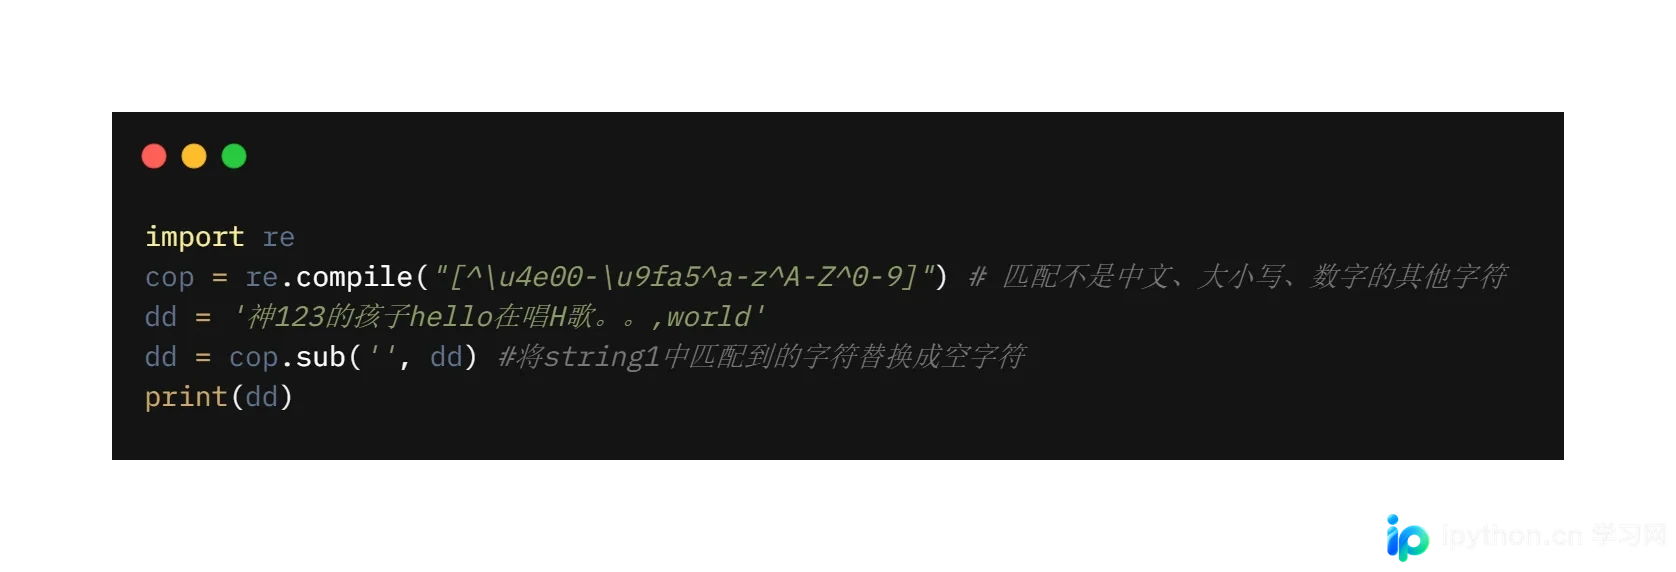
三、re模块中的compile函数
compile函数用于将正则表达式字符串编译成正则表达式对象(Pattern),以便在后续操作中复用,提高执行效率。
其语法格式为:
re.compile(pattern[, flags])
参数说明:
pattern:表示正则表达式的字符串。
flags:可选参数,用于指定匹配模式,如忽略大小写、多行模式等。具体标志位如下:
- re.I:忽略大小写。
- re.L:表示特殊字符集 \w, \W, \b, \B, \s, \S 依赖于当前环境。
- re.M:多行模式。
- re.S:使 . 匹配包括换行符在内的任意字符(默认情况下 . 不匹配换行符)。
- re.U:表示特殊字符集 \w, \W, \b, \B, \d, \D, \s,\S 依赖于 Unicode 字符属性数据库。
- re.X:为了增加可读性,忽略空格和 # 后面的注释。
3.1 同时匹配中英文数字去除其他字符
总结
本文介绍了如何使用Python提取字符串中的中英文内容。更多相关Python提取字符串中英文的内容,请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









