

DeepSeek模型量化怎么选?GGUF与AWQ格式对速度的影响

在本地部署大语言模型时,我们往往面临一个经典的取舍困境:是保留模型的完整智力,还是换取流畅的交互速度?对于DeepSeek这样参数量庞大的模型而言,未经量化的原始权重不仅对显存提出苛刻要求,更会让推理过程变得迟缓如泥。许多用户在尝试本地运行时,常被GGUF、AWQ、GPTQ等术语困扰,不知道该如何选择才能既不让电脑“冒烟”,又不让模型变“笨”。
量化并非简单的压缩,而是一场关于精度与效率的精密博弈。 不同的量化格式针对不同的硬件架构和推理后端进行了优化,选错格式可能导致速度提升微乎其微,甚至出现逻辑混乱。本文将剥离复杂的数学公式,从实际使用场景出发,剖析GGUF与AWQ在DeepSeek模型部署中的真实表现,帮你找到最适合自己硬件的那把钥匙。
CPU友好型方案:GGUF格式的通用性与灵活性
如果你使用的是MacBook,或者是一台没有高端NVIDIA显卡的Windows笔记本,GGUF几乎是你唯一且最好的选择。这种格式由llama.cpp项目推广,其核心优势在于对CPU和Apple Silicon芯片的极致优化,以及极高的跨平台兼容性。
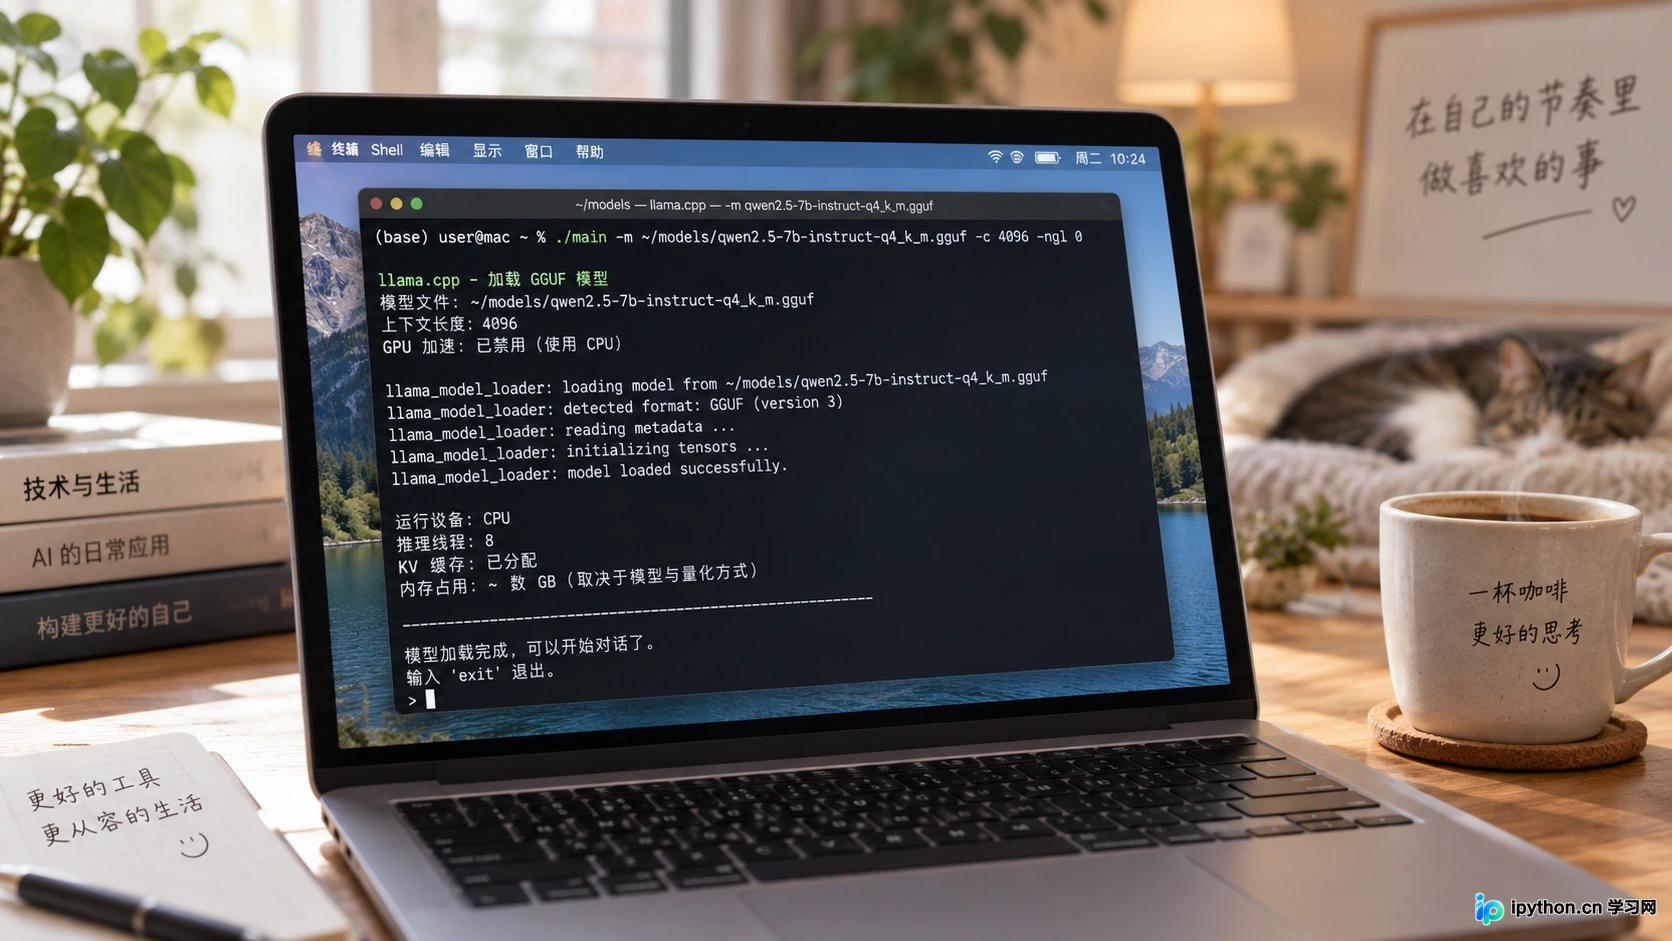
MacBook上通过llama.cpp运行GGUF格式DeepSeek模型,展示CPU推理的兼容性与内存占用情况
GGUF格式允许模型在纯CPU环境下运行,虽然速度远不及GPU,但它打破了硬件门槛。在这种场景下,你可以选择Q4_K_M或Q5_K_M等中等量化等级。Q4意味着每个权重仅用4位存储,相比原始的16位浮点数,显存或内存占用减少了约75%。对于DeepSeek-7B这样的模型,Q4量化后仅需约6GB内存即可加载,这使得它在大多数现代轻薄本上都能跑起来。
然而,GGUF的代价是推理速度。在CPU上,即使使用AVX-512指令集加速,生成速度通常也在每秒几个token到十几个token之间,难以实现真正的“实时对话”体验。但在Apple M系列芯片上,得益于统一内存架构和高带宽,GGUF的表现令人惊喜,Q4量化的DeepSeek-7B可以达到每秒30-50 token的速度,足以满足日常辅助写作和代码补全的需求。GGUF的价值不在于极致速度,而在于让大模型触手可及,它牺牲了部分并行计算能力,换来了最广泛的硬件支持。
GPU加速利器:AWQ格式在NVIDIA显卡上的爆发力
当你拥有一张NVIDIA RTX 30系或40系显卡时,AWQ(Activation-aware Weight Quantization)格式则展现出截然不同的面貌。与GGUF主要依赖CPU不同,AWQ专为GPU推理设计,通常配合ExLlamaV2或vLLM等后端使用,能够充分释放CUDA核心的并行计算能力。
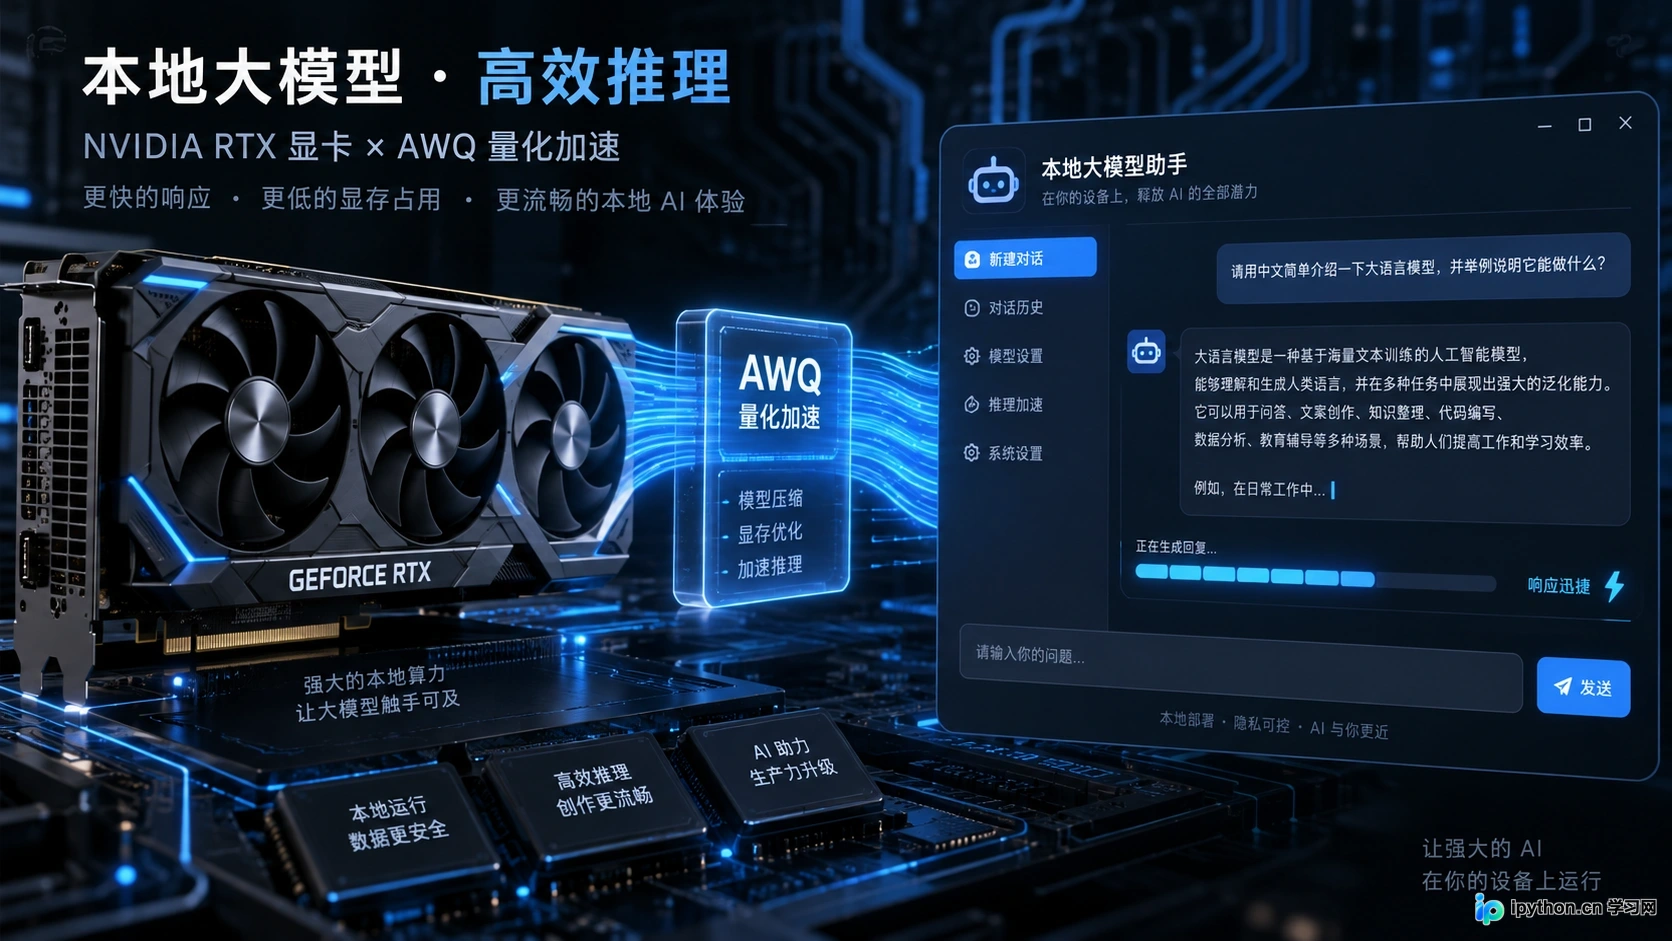
NVIDIA RTX显卡配合ExLlamaV2后端运行AWQ格式,展示高Token生成速度
AWQ的核心技术在于它在量化过程中考虑了激活值的分布,从而在极低比特(如4-bit)下仍能保持较高的精度。在RTX 4090这样的旗舰卡上,运行AWQ 4-bit的DeepSeek-7B,推理速度可以轻松突破每秒100 token,甚至达到200 token以上。这种速度带来的体验是颠覆性的:长文档总结几乎是瞬间完成,代码生成如同打字般流畅。
但AWQ并非没有门槛。首先,它强烈依赖NVIDIA显卡,AMD显卡或Intel Arc的支持尚在完善中,体验不如NVIDIA稳定。其次,AWQ的量化过程相对复杂,虽然社区提供了大量预量化模型,但若想自定义量化,需要较高的技术背景。对于追求极致响应速度的开发者或重度用户,AWQ是目前NVIDIA平台上的首选,它将延迟降到了人类感知的阈值以下,让本地模型真正具备了生产力工具的属性。
精度损失的边界:何时该拒绝低比特量化?
无论选择GGUF还是AWQ,量化必然带来精度损失。这种损失在简单问答中可能不易察觉,但在复杂逻辑推理、数学计算或长上下文理解中会被放大。常见的误区是盲目追求最低的比特数,例如在7B模型上使用Q2量化,这往往会导致模型输出重复、胡言乱语或完全忽略指令。
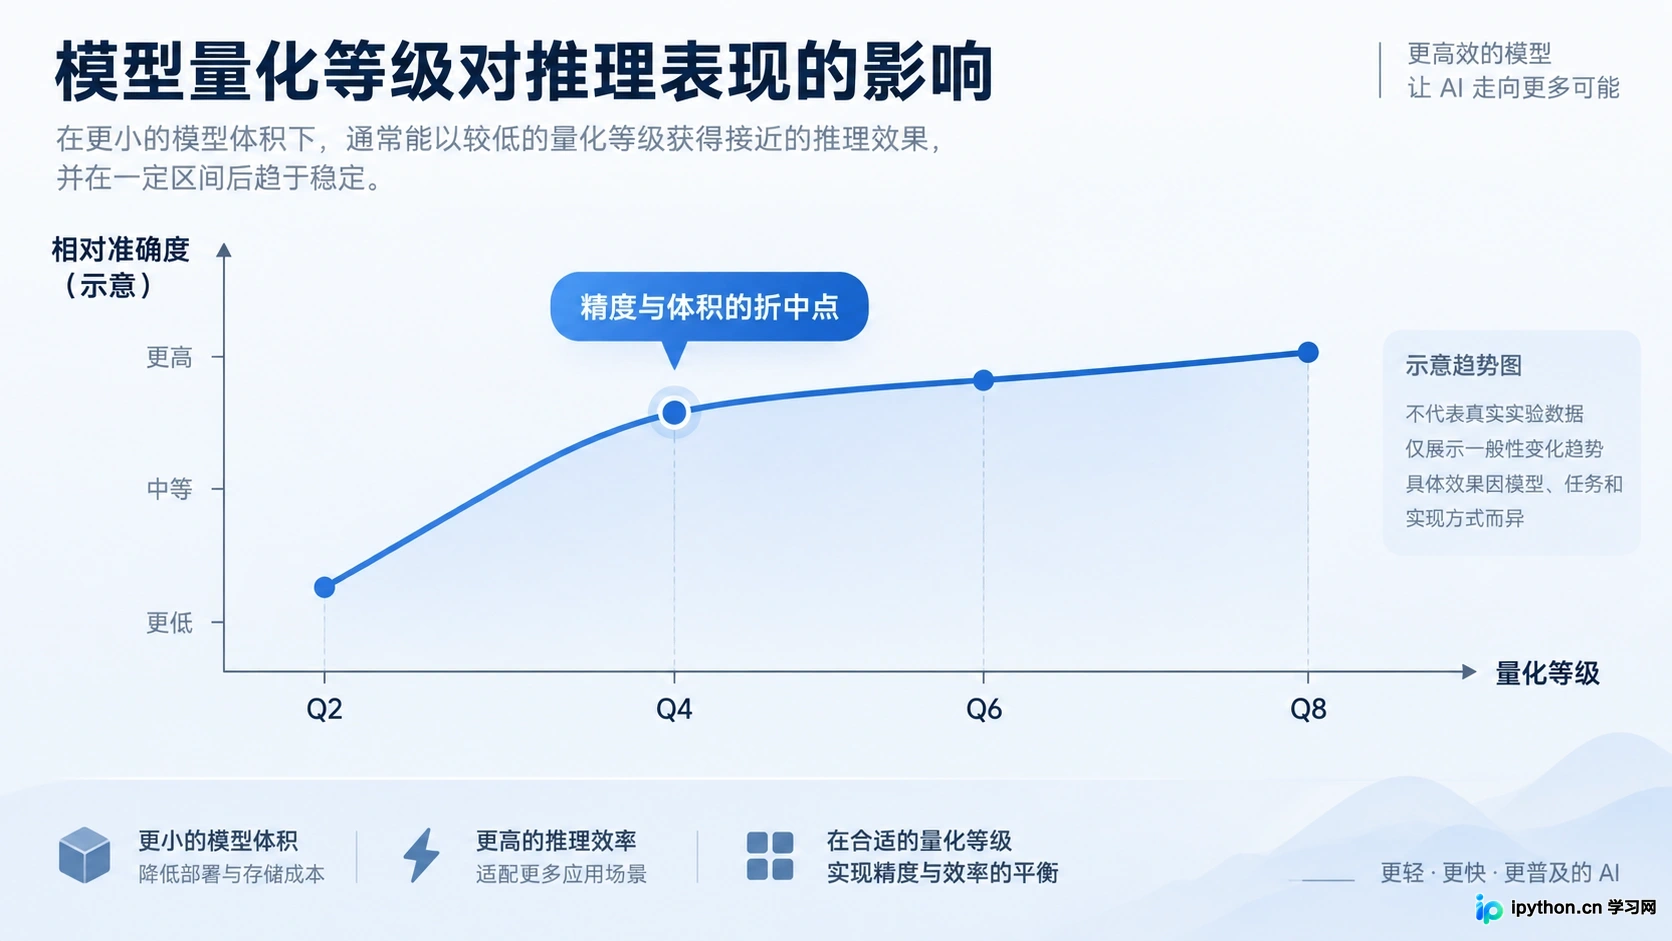
Q2至Q8不同量化等级在逻辑推理任务中的准确率变化趋势
在实际测试中,Q4通常是精度与体积的甜蜜点。对于DeepSeek这类经过高质量训练的模型,Q4量化后的性能损失通常在1-2%以内,对于大多数日常任务可以忽略不计。然而,当涉及到专业领域的深度分析时,Q6或Q8版本会表现出更强的稳定性。如果你发现模型经常犯低级错误,或者在长对话中丢失前文信息,不妨尝试提升一个量化等级,或者切换回更高精度的格式。
此外,不同量化方法对精度的影响也不同。AWQ由于引入了激活感知机制,在同比特下通常比传统的PTQ(Post-Training Quantization)方法保留更多细节。而GGUF中的K-quants系列(如Q4_K_S vs Q4_K_M)也在不断优化,试图在微小体积增加的前提下挽回更多精度。因此,不要只看比特数,还要看具体的量化算法变种。
决策指南:根据硬件与需求锁定最佳格式
面对众多的选择,最终的决策应回归到你的硬件配置和核心需求。这里没有绝对的最好,只有最适合。
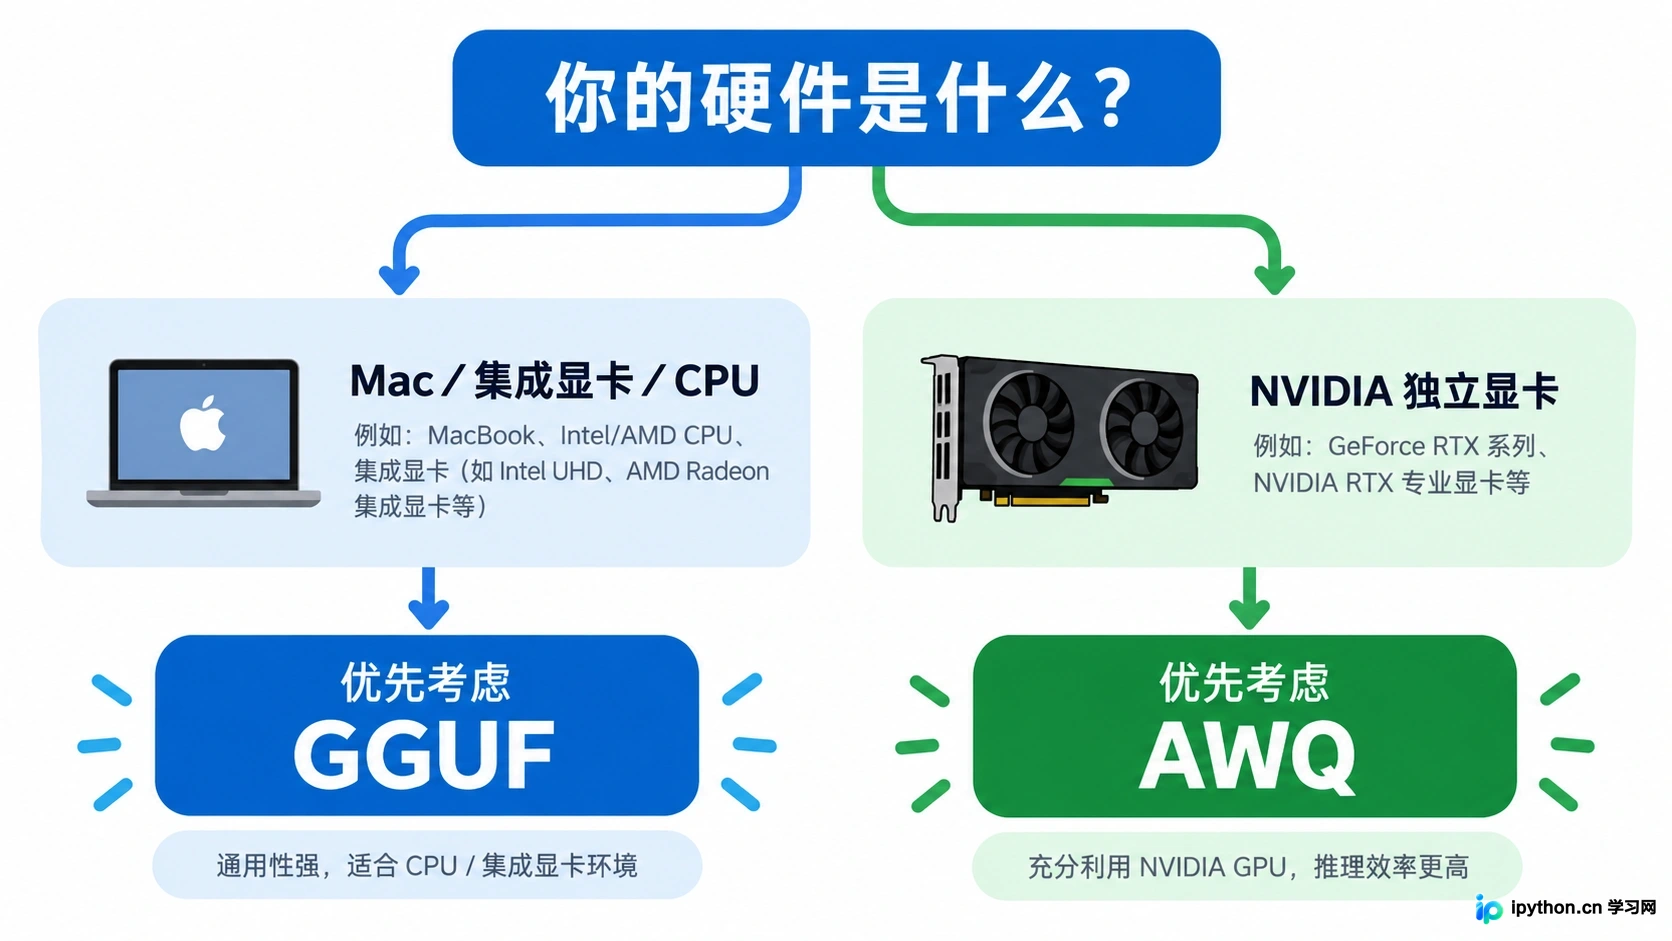
根据硬件类型(Mac/CPU/NVIDIA GPU)选择GGUF或AWQ格式的决策路径
如果你是Mac用户,或者只有集成显卡的笔记本,请坚定选择GGUF格式。优先尝试Q4_K_M,如果内存充裕且追求更高精度,可升级至Q5_K_M或Q6_K。不要指望在CPU上获得GPU般的速度,接受每秒10-20 token的节奏,将其作为离线助手使用。
如果你拥有NVIDIA RTX 3060及以上级别的独立显卡,且显存大于8GB,AWQ格式将带来质的飞跃。优先选择AWQ 4-bit,它能让你在有限的显存内运行更大参数的模型(如DeepSeek-33B的量化版),同时保持极高的吞吐量。若显存非常充足(如24GB以上),甚至可以尝试半精度或Q8,以榨取模型的最后一点智力。
对于介于两者之间的用户,例如拥有入门级独显或较老款NVIDIA卡的用户,可以尝试GGUF的GPU卸载功能(offload layers)。通过将部分层加载到GPU,其余留在CPU,可以在速度和显存占用之间找到折中方案。但这需要细致的参数调整,不如前两种方案来得直接和稳定。
量化技术的进步正在不断拓宽本地运行大模型的边界。GGUF让我们看到了普惠的可能,而AWQ则展示了性能的极限。在选择DeepSeek的量化版本时,不必纠结于微小的参数差异,关键在于认清自己的硬件底线和使用上限。 只有当工具的特性与你的工作流完美契合时,本地部署的大模型才能真正从极客的玩具,变成得力的助手。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









