

Python实现有道词典爬虫:抓包分析与代码实战

本文详细介绍如何使用Python爬取有道词典的翻译结果。通过Chrome开发者工具分析网络请求,获取翻译接口的URL、参数及Header信息,并利用urllib库构建POST请求。文中提供了完整的Python代码示例,演示如何伪装用户代理、提交翻译内容并解析返回的JSON数据,帮助开发者掌握基础爬虫技巧。
前言
大家好
近期Python爬虫技术备受关注,各类抓取案例层出不穷。今天我们也来参与这一热潮,目标是制作一个简单的翻译工具——准确地说,是向有道词典提交翻译请求并抓取返回的翻译结果。
主要内容
所需材料
1. Python 3.8.4版本
2. 一台计算机(假设读者均具备基本的计算设备)
3. Google Chrome浏览器(其他浏览器亦可,此处以Chrome为例进行演示)
写程序前准备
首先打开Google Chrome浏览器,访问有道词典翻译页面(http://fanyi.youdao.com/)。
在页面加载完成后,按下F12键打开开发者工具,切换到Network(网络)选项卡,随后刷新网页以捕获初始请求。
接着,在翻译框中输入任意文本进行翻译(示例中使用了程序员经典的“hello world”),点击翻译按钮。
在Network选项卡的请求列表中,筛选出以“translate”开头的POST请求文件。
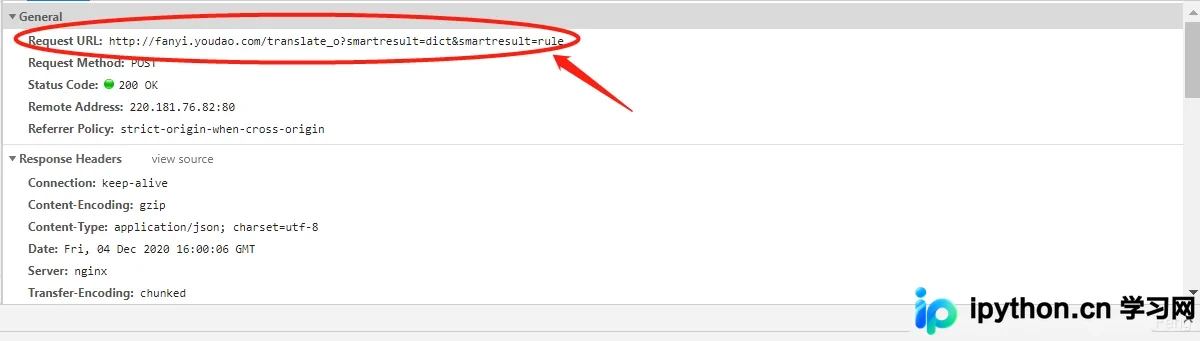
箭头所指的位置即为真正的数据提交地址,请记录该URL,后续编写代码时将直接使用。
记住该地址,这是编写爬虫代码的关键入口。
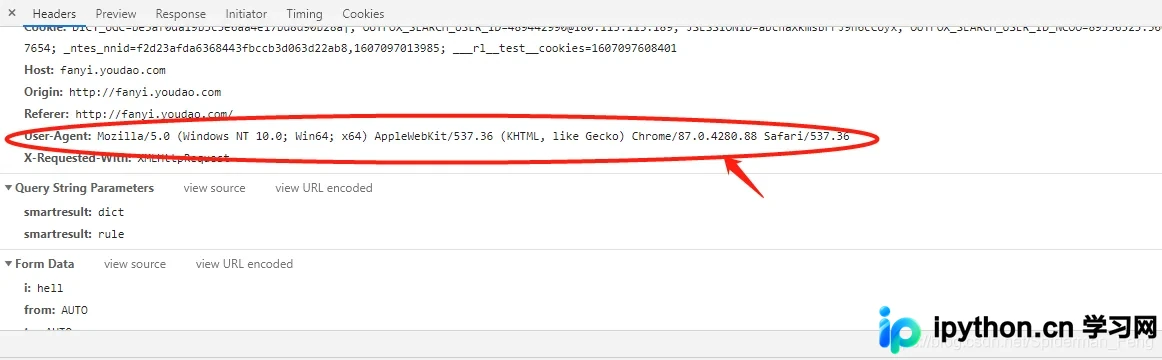
此外,还需记录提交请求时携带的基本信息(如User-Agent等)。这些信息在后续伪装客户端身份时使用,因为服务器会检查请求头,若直接暴露Python版本(如python3.8.4),可能导致请求被服务器拒绝。
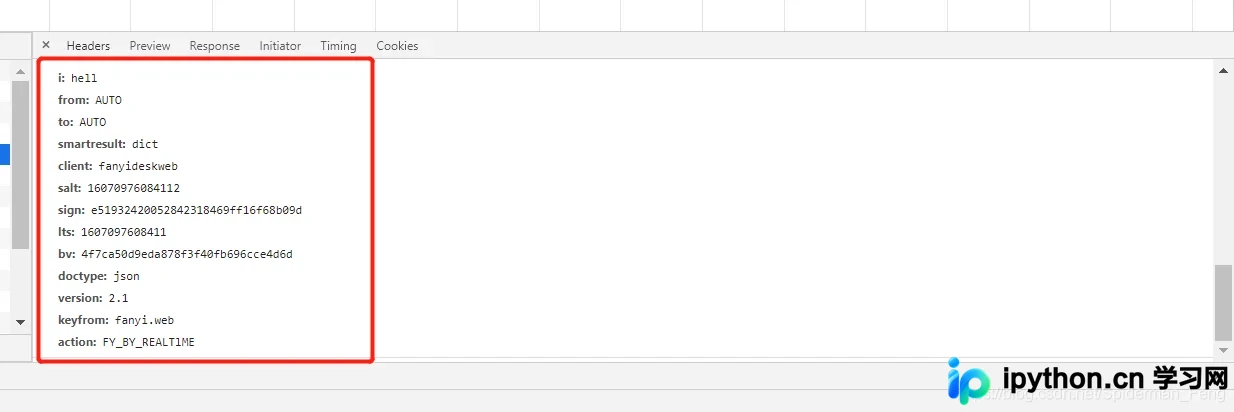
这些信息在后续代码编写中同样需要用到。
准备工作完成后,接下来开始编写核心代码。
开始编写爬虫代码
以下是实现的Python代码,具体逻辑将在下文解析。
#导入urllib库
import urllib.request
import urllib.parse
import json

while True: #无限循环
 content = input("请输入您要翻译的内容(输入 !!! 退出程序): ")
 #设置退出条件
 if content == '!!!':
  break

 url = 'http://fanyi.youdao.com/translate?smartresult=dict&smartresult=rule' #选择要爬取的网页,上面找过了
 #加上一个帽子,减少被发现的概率(下面head列表的内容就是上面找的)
 head = {}
 head['User - Agent'] = '请替换'

 #伪装计算机提交翻译申请(下面的内容也在在上面有过,最好根据自己的进行修改)
 data = {}
 data['type'] = 'AUTO'
 data['i'] = content
 data['doctype'] = 'json'
 data['version'] = '2.1'
 data['keyfrom:'] = 'fanyi.web'
 data['ue'] = 'UTF-8'
 data['typoResult'] = 'true'
 data = urllib.parse.urlencode(data).encode('utf-8')

 response = urllib.request.urlopen(url, data)
 #解码
 html = response.read().decode('utf-8')

 paper = json.loads(html)

 #打印翻译结果
 print("翻译结果: %s" % (paper['translateResult'][0][0]['tgt']))
运行结果

至此,关于使用Python爬取有道词典的教程介绍完毕。如需了解更多Python与有道词典相关的内容,可搜索本站历史文章或继续阅读后续系列。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









