

Python回归树模型:从原理到代码实现与剪枝优化

本文深入解析Python中回归树模型的实现原理,基于CART算法讲解特征分裂与方差计算逻辑。通过完整代码示例,演示如何利用scikit-learn加载波士顿房价数据进行模型训练,并详细阐述预剪枝与后剪枝策略对防止过拟合的作用,帮助读者掌握从理论到工程落地的完整流程。
回归树模型核心原理
回归树模型旨在利用树形结构解决回归预测问题,其基础架构源自经典的决策树。尽管核心结构相似,但根据叶子节点的预测方式不同,可划分为两类:一是叶子节点直接输出一个具体的预测值,这类模型被称为回归树;二是叶子节点对应一个线性模型,最终结果由该线性模型计算得出,称为模型树。
本文重点聚焦于回归树的实现与原理分析。
回归树模型核心机制
CART算法的关键在于每次特征分裂时强制对数据集进行二分处理,无论特征是离散型还是连续型,处理方式保持一致。此外,CART使用基尼指数(Gini Index)而非信息增益或增益比来选择分裂特征。在回归场景下,由于损失函数采用均方差(MSE)而非交叉熵,熵的概念难以直接衡量连续值的准确度,因此基尼指数在此处不适用,分裂标准主要依据均方误差的减少量。
在分类树中,叶子节点代表所属类别,其预测值为落入该节点的训练样本类别的众数。而在回归树中,叶子节点输出的是连续数值,具体为落入该节点的训练样本目标值的均值。此时,评估误差的标准是这些样本的均方差。
在特征划分阈值的选择上,分类树通常优化为仅考虑那些能引起预测类别变化的阈值点。然而,在回归问题中,由于预测值是浮点数,这种针对类别变化的优化策略不再适用。总体而言,回归树的实现逻辑相比分类树更为简洁直接。
Python代码实战与数据预处理
实战环节
首先进行数据加载,本次实验选用scikit-learn库中经典的波士顿房价预测数据集。虽然Kaggle平台上存在类似比赛(如house-prices-advanced-regression-techniques),但其特征维度更高且包含缺失值,需进行大量特征工程。本文使用的数据集质量较高,已预先完成筛选与处理,便于直接应用。
获取数据方面,利用sklearn内置API即可轻松获取,操作简便:
import numpy as np
import pandas as pd
from sklearn.datasets import load_boston
boston = load_boston()

X, y = boston.data, boston.target
查看前几条数据以确认数据形态:
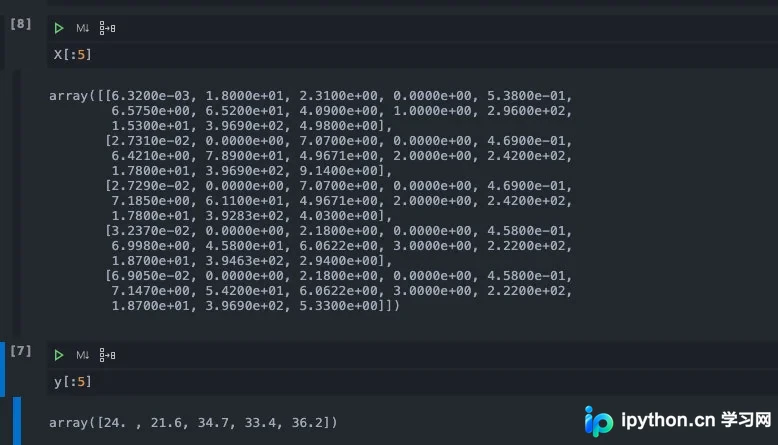
该数据集质量优良,sklearn已代为完成预处理工作,可直接使用。为便于数据传递,需将特征矩阵X与目标向量y合并。由于y为一维数组,无法直接与二维的X拼接,需先对y进行reshape操作重塑形状,再执行合并。
y = y.reshape(-1, 1)
X = np.hstack((X, y))
使用hstack函数可将两个numpy数组横向拼接,对应地vstack用于纵向拼接。合并后,y作为最后一列追加至X之后。数据准备就绪,接下来开始模型构建。
在实现决策树主体逻辑前,先定义两个辅助函数:第一个用于计算一批样本的方差和,第二个用于获取样本均值,即子节点的预测值。
def node_mean(X):
 return np.mean(X[:, -1])


def node_variance(X):
 return np.var(X[:, -1]) * X.shape[0]
随后实现根据阈值拆分数据的函数,此部分逻辑可复用之前的代码:
from collections import defaultdict
def split_dataset(X, idx, thred):
 split_data = defaultdict(list)
 for x in X:
  split_data[x[idx] < thred].append(x)
 return list(split_data.values()), list(split_data.keys())
接下来定义两个关键函数:get_thresholds用于获取分裂阈值,split_variance用于根据阈值拆分数据并返回拆分后的方差和。理论上,回归模型中特征的每个取值均可作为切分点,但需对特征值去重以处理重复值情况。
def get_thresholds(X, i):
 return set(X[:, i].tolist())

# 每次迭代方差优化的底线
MINIMUM_IMPROVE = 2.0
# 每个叶子节点最少样本数
MINIMUM_SAMPLES = 10

def split_variance(dataset, idx, threshold):
 left, right = [], []
 n = dataset.shape[0]
 for data in dataset:
  if data[idx] < threshold:
   left.append(data)
  else:
   right.append(data)
 left, right = np.array(left), np.array(right)
 # 预剪枝
 # 如果拆分结果有一边过少,则返回None,防止过拟合
 if len(left) < MINIMUM_SAMPLES or len(right) < MINIMUM_SAMPLES:
  return None
 # 拆分之后的方差和等于左子树的方差和加上右子树的方差和
 # 因为是方差和而不是均方差,所以可以累加
 return node_variance(left) + node_variance(right)
代码中引入了MINIMUM_SAMPLES参数用于预剪枝。若不限制决策树的生长,叶子节点数量可能与训练样本数一致,导致严重过拟合。因此,通过设定每个节点的最小样本数来限制树的深度,该参数可根据实际需求调整。
随后实现特征与阈值筛选函数,该函数遍历所有可能的特征及其阈值,计算拆分后的方差,从而找出最佳分裂点。
def choose_feature_to_split(dataset):
 n = len(dataset[0])-1
 m = len(dataset)
 # 记录最佳方差,特征和阈值
 var_ = node_variance(dataset)
 bestVar = float('inf')
 feature = -1
 thred = None
 for i in range(n):
  threds = get_thresholds(dataset, i)
  for t in threds:
   # 遍历所有的阈值,计算每个阈值的variance
   v = split_variance(dataset, i, t)
   # 如果v等于None,说明拆分过拟合了,跳过
   if v is None:
    continue
   if v < bestVar:
    bestVar, feature, thred = v, i, t
 # 如果最好的拆分效果达不到要求,那么就不拆分,控制子树的数量
 if var_ - bestVar < MINIMUM_IMPROVE:
  return None, None
 return feature, thred
该函数同样包含预剪枝参数MINIMUM_IMPROVE,用于衡量生成子树带来的收益。若某次分裂带来的方差减少量低于该阈值,则认为收益不足,放弃分裂,这也是控制模型复杂度的预剪枝手段。
完成上述辅助函数后,开始构建决策树。由于当前数据集中未包含特征名称,因此省略了与特征名称相关的逻辑处理。
def create_decision_tree(dataset):
 dataset = np.array(dataset)

 # 如果当前数量小于10,那么就不再继续划分了
 if dataset.shape[0] < MINIMUM_SAMPLES:
  return node_mean(dataset)

 # 记录最佳拆分的特征和阈值
 fidx, th = choose_feature_to_split(dataset)
 if fidx is None:
  return th

 node = {}
 node['feature'] = fidx
 node['threshold'] = th

 # 递归建树
 split_data, vals = split_dataset(dataset, fidx, th)
 for data, val in zip(split_data, vals):
  node[val] = create_decision_tree(data)
 return node
进行完整测试前,需将原始数据划分为训练集和测试集。鉴于场景相对简单,此处未设置验证集。
数据划分无需手动实现,直接调用sklearn提供的工具函数即可:
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=23)
该函数主要涉及两个参数:test_size,可为整数(表示测试集样本数)或0-1.0之间的浮点数(表示测试集占比);random_state为随机种子,用于保证结果的可重复性。
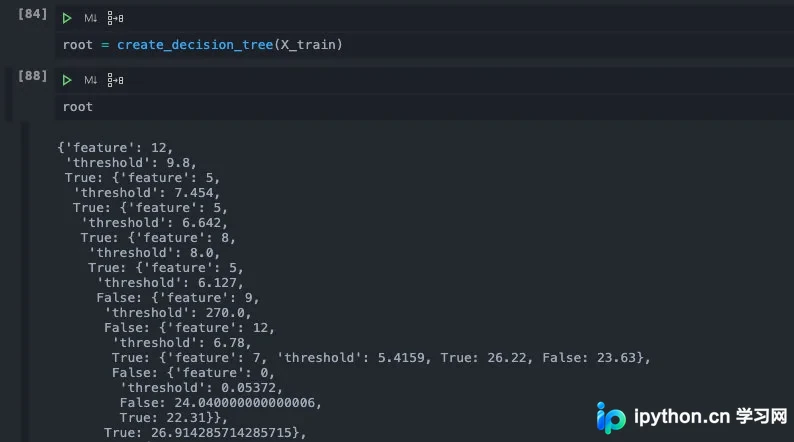
输出生成的树结构,由于数据量较大,树结构显得庞大。建树逻辑完成后,剩余部分为预测逻辑。
预测部分的代码与分类树类似,整体逻辑一致,仅去除了feature_names相关的处理。
def classify(node, data):
 key = node['feature']
 pred = None
 thred = node['threshold']

 if isinstance(node[data[key] < thred], dict):
  pred = classify(node[data[key] < thred], data)
 else:
  pred = node[data[key] < thred]

 # 放置pred为空,挑选一个叶子节点作为替补
 if pred is None:
  for key in node:
   if not isinstance(node[key], dict):
    pred = node[key]
    break
 return pred
由于现有函数仅支持单条数据预测,为实现批量预测,需额外实现一个predict函数。
def predict(node, X):
 y_pred = []
 for x in X:
  y = classify(node, x)
  y_pred.append(y)
 return np.array(y_pred)
后剪枝策略与效果验证
后剪枝策略
后剪枝(post-prune)有时也被译为事后剪枝,此处沿用英文术语。
回归树的后剪枝思想较为朴素:首先构建一棵尽可能复杂的树,然后利用测试集对其进行修剪。具体逻辑是比较子树存在分叉与合并为单一叶子节点时的误差,若合并后误差更小,则执行剪枝操作。
剪枝过程与建树过程类似,采用自上而下的递归方式执行。
逻辑清晰,直接参考代码实现:
def is_dict(node):
 return isinstance(node, dict)


def prune(node, testData):
 testData = np.array(testData)
 if testData.shape[0] == 0:
  return node

 # 拆分数据
 split_data, _ = split_dataset(testData, node['feature'], node['threshold'])
 # 对左右子树递归修剪
 if is_dict(node[0]):
  node[0] = prune(node[0], split_data[0])
 if is_dict(node[1]) and len(split_data) > 1:
  node[1] = prune(node[1], split_data[1])

 # 如果左右都是叶子节点,那么判断当前子树是否需要修剪
 if len(split_data) > 1 and not is_dict(node[0]) and not is_dict(node[1]):
  # 计算修剪前的方差和
  baseError = np.sum(np.power(np.array(split_data[0])[:, -1] - node[0], 2)) + np.sum(np.power(np.array(split_data[1])[:, -1] - node[1], 2))
  # 计算修剪后的方差和
  meanVal = (node[0] + node[1]) / 2
  mergeError = np.sum(np.power(meanVal - testData[:, -1], 2))
  if mergeError < baseError:
   return meanVal
  else:
   return node
 return node
最后,验证剪枝后的模型效果:
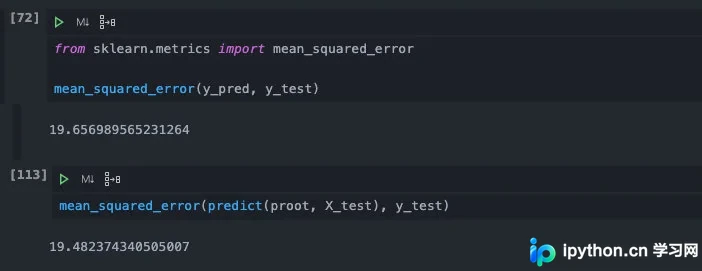
从结果图可见,剪枝前测试集的均方差为19.65,剪枝后降至19.48。数值上的提升证明了方法的有效性。尽管由于训练数据较少及预剪枝的存在,后剪枝效果受限,但在实际机器学习工程中,只要方法在可承受代价下能带来明确提升,即具有价值,不应因提升微小而否定其意义。
计算均方差时使用了sklearn库中的mean_square_error函数,该函数专门用于计算两个Numpy数组之间的均方差。
模型总结与意义
总结
回归树模型的相关内容至此结束。我们不仅手动实现了模型,还在真实数据集上进行了实验验证。亲手实现代码的过程将带来深刻的理解与收获。
尽管实际应用中很少单独使用树模型进行回归任务,但回归树模型本身具有极高的学术与工程价值。它是许多高性能模型的基础,如著名的GBDT。在深度学习普及之前,随机森林、GBDT、Adaboost等高效模型均基于树模型构建。可以说,树模型曾占据机器学习的半壁江山,其重要性不言而喻。
本文到此结束,若觉得内容有用,欢迎关注以获取更多技术文章。
以上为Python实现回归树模型的详细内容,更多相关技术资讯请关注本站其他文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









