

Python实战:K-Means与PCA在图像压缩中的应用对比

本文深入探讨在Python中利用sklearn库实现K-Means聚类和PCA主成分分析进行图像压缩。通过对比两种算法在解释方差、图像大小及视觉质量上的表现,详细解析了如何确定最佳聚类数k和主成分数n_select,并提供了从原始图像到压缩结果的完整评估流程。
Python K-Means与PCA图像压缩实战
在Python中使用K-Means聚类和PCA主成分分析进行图像压缩
大家好,本文将尝试使用sklearn库,对比K-Means聚类算法与主成分分析(PCA)在图像压缩方面的实现效果及结果。我们将通过压缩后图像占用的空间减少比例,以及其与原始图像的差异程度来评估压缩效果。图像压缩的核心目标是在尽可能保持图像视觉相似性的前提下,最小化图像占用的存储空间,这一目标通过图像差异百分比来量化。实现该过程需要引入以下Python库:
# image processing
from PIL import Image
from io import BytesIO
import webcolors

# data analysis
import math
import numpy as np
import pandas as pd

# visualization
import matplotlib.pyplot as plt
from importlib import reload
from mpl_toolkits import mplot3d
import seaborn as sns

# modeling
from sklearn.cluster import KMeans
from sklearn.decomposition import PCA
from sklearn.preprocessing import MinMaxScaler
图像数据探索与预处理
探索图像数据
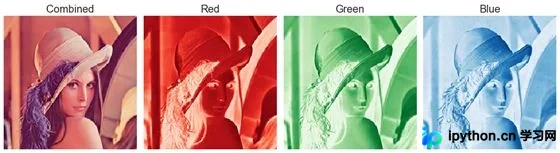
每个颜色通道的图像表现 图像中的每个像素点由三个介于0到255之间的8位无符号整数表示,或者缩放为三个0到1之间的无符号浮点数。这三个数值分别对应红色、绿色和蓝色的强度,即通常所说的RGB编码。本文选用了一张尺寸为220 x 220像素的lena.jpg图像,这是图像处理领域广泛使用的标准测试图像。
ori_img = Image.open("images/lena.png")
ori_img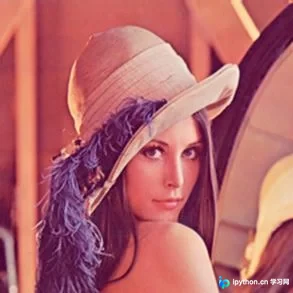
原始图像展示
X = np.array(ori_img.getdata())
ori_pixels = X.reshape(*ori_img.size, -1)
ori_pixels.shape
图像的存储结构是一个形状为(220、220、3)的三维矩阵。前两个维度分别代表图像的宽度和高度,最后一个维度对应RGB编码。接下来,我们将确定图像的其他关键属性,包括以千字节(KB)为单位的文件大小以及原始图像中 distinct 颜色的数量。
def imageByteSize(img):
  img_file = BytesIO()
  image = Image.fromarray(np.uint8(img))
  image.save(img_file, 'png')
  return img_file.tell()/1024
ori_img_size = imageByteSize(ori_img)
ori_img_n_colors = len(set(ori_img.getdata()))
lena.jpg的原始文件大小为86 KB,包含37270种独特的颜色。因此,可以推断lena.jpg中两个像素拥有完全相同RGB值的概率极低。
接下来,我们计算图像差异作为压缩结果的基准指标。
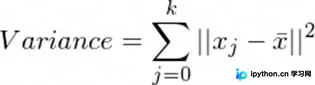
ori_img_total_variance = sum(np.linalg.norm(X - np.mean(X, axis = 0), axis = 1)**2)计算得到的方差值为302426700.6427498。然而,单独查看方差值难以直观解释其意义,该数值将在后续的K-Means聚类分析中作为参考使用。
K-Means聚类算法原理与实现
K-Means聚类方法
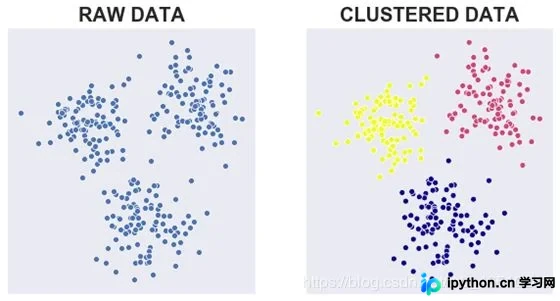
具有三个聚类中心的二维K-Means聚类图像示例
算法原理
K-Means聚类是一种常用的无监督学习算法,旨在将数据集划分为k个聚类中心,其中k值需由用户预先指定。该算法的目标是将现有数据点分类到若干个集群中,使得:
- 同一集群内的数据点尽可能相似
- 不同集群之间的数据点尽可能不同
每个集群由一个聚类中心代表,该中心是集群内所有数据点的平均值。具体算法步骤如下:
- 用户指定集群数量k
- 从数据集中随机选择k个不同的点作为初始聚类中心
- 将每个数据点分配给距离最近的聚类中心,通常使用欧几里得距离进行计算
- 通过计算属于该集群的所有数据点的平均值,得到新的聚类中心
- 重复步骤3和4,直到聚类中心位置不再变化(即收敛)
请注意,由于初始化是随机的,结果可能并非总是理想状态。
核心思路
原始图像包含数千种颜色。我们将利用K-Means聚类算法来减少颜色数量,从而只需存储有限数量的RGB值,进而减小图像尺寸以提高存储效率。我们可以将像素值视为一个数据帧,其中包含(宽度×高度)个观测值和3个对应RGB值的特征。对于lena.jpg,我们将拥有220×220(即48400)个观测值和3个特征。
因此,我们可以将每个像素可视化在三维图中。下图展示了前220个像素,代表原始图像的第一行像素。
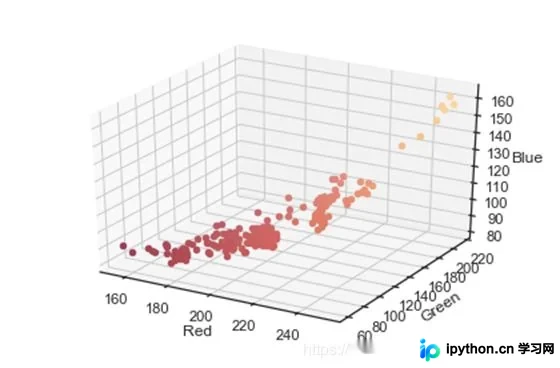
像素值的三维可视化图
简单示例演示
在对颜色数k进行各种值的迭代之前,让我们先使用k = 2来理解我们的目标。到本节结束时,我们希望图像仅由2种颜色组成。首先,我们创建一个KMeans对象,并对原始像素X进行拟合。
kmeans = KMeans(n_clusters = 2,
        n_jobs = -1,
        random_state = 123).fit(X)
kmeans_df = pd.DataFrame(kmeans.cluster_centers_, columns = ['Red', 'Green', 'Blue'])
随后,我们将RGB值转换为其对应的英文颜色名称:
def closest_colour(requested_colour):
  min_colours = {}
  for key, name in webcolors.CSS3_HEX_TO_NAMES.items():
    r_c, g_c, b_c = webcolors.hex_to_rgb(key)
    rd = (r_c - requested_colour[0]) ** 2
    gd = (g_c - requested_colour[1]) ** 2
    bd = (b_c - requested_colour[2]) ** 2
    min_colours[(rd + gd + bd)] = name
  return min_colours[min(min_colours.keys())]
def get_colour_name(requested_colour):
  try:
    closest_name = actual_name = webcolors.rgb_to_name(requested_colour)
  except ValueError:
    closest_name = closest_colour(requested_colour)
  return closest_name
kmeans_df["Color Name"] = list(map(get_colour_name, np.uint8(kmeans.cluster_centers_)))
kmeans_df
当我们指定n_clusters参数为2时,得到两个聚类中心。接下来,我们可以通过聚类中心来表示该群集中的每个像素值。因此,在压缩后的图像中,仅存在两个像素值。
def replaceWithCentroid(kmeans):
  new_pixels = []
  for label in kmeans.labels_:
    pixel_as_centroid = list(kmeans.cluster_centers_[label])
    new_pixels.append(pixel_as_centroid)
  new_pixels = np.array(new_pixels).reshape(*ori_img.size, -1)
  return new_pixels
new_pixels = replaceWithCentroid(kmeans)
聚类步骤已完成,让我们查看压缩图像的结果。
def plotImage(img_array, size):
  reload(plt)
  plt.imshow(np.array(img_array/255).reshape(*size))
  plt.axis('off')
  return plt

plotImage(new_pixels, new_pixels.shape).show()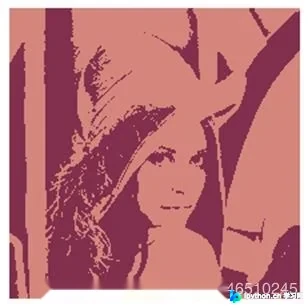
仅包含两种颜色的压缩图片
K-Means仅使用两种颜色便成功保留了lena.jpg的形状。从视觉上,我们可以比较原始图像与压缩图像的相似性。但是,如何通过程序量化这一结果?我们将引入一组评估压缩图像的指标:
群内平方和(WCSS):测量群集中所有点到其聚类中心的欧几里得距离平方的总和。
群间平方和(BCSS):测量所有聚类中心之间欧几里得距离平方的总和。
解释方差:衡量压缩图像效果,即压缩图像解释原始图像的百分比。如果将每个像素视为单独的集群,则WCSS等于0,此时Explained Variance = 100%。
图像大小:以千字节为单位,用于评估缩小/压缩性能。
def calculateBCSS(X, kmeans):
  _, label_counts = np.unique(kmeans.labels_, return_counts = True)
  diff_cluster_sq = np.linalg.norm(kmeans.cluster_centers_ - np.mean(X, axis = 0), axis = 1)**2
  return sum(label_counts * diff_cluster_sq)
WCSS = kmeans.inertia_
BCSS = calculateBCSS(X, kmeans)
exp_var = 100*BCSS/(WCSS + BCSS)
print("WCSS: {}".format(WCSS))
print("BCSS: {}".format(BCSS))
print("Explained Variance: {:.3f}%".format(exp_var))
print("Image Size: {:.3f} KB".format(imageByteSize(new_pixels)))
WCSS: 109260691.314189 BCSS: 193071692.34763986 Explained Variance: 63.861% Image Size: 4.384 KB
图像大小从86 KB大幅下降到4.384 KB,但需要注意的是,压缩图像对原始图像的解释能力仅为63.861%。我们期望获得更高的解释方差百分比。接下来,我们将重复上述过程并改变𝑘值以实现这一目标。
重复试验过程
在本节中,我们将在𝑘= 2到𝑘= 20之间重复以下步骤:
- 执行k-means以获取每个像素的聚类中心和聚类标签
- 将每个像素替换为其对应的聚类中心。
- 保存指标值以进行进一步优化:WCSS,BCSS,解释方差和图像大小
- 展示随着颜色数量增加后的压缩图像
range_k_clusters = (2, 21)
kmeans_result = []
for k in range(*range_k_clusters):
  # CLUSTERING
  kmeans = KMeans(n_clusters = k,
          n_jobs = -1,
          random_state = 123).fit(X)

  # REPLACE PIXELS WITH ITS CENTROID
  new_pixels = replaceWithCentroid(kmeans)

  # EVALUATE
  WCSS = kmeans.inertia_
  BCSS = calculateBCSS(X, kmeans)
  exp_var = 100*BCSS/(WCSS + BCSS)

  metric = {
    "No. of Colors": k,
    "Centroids": list(map(get_colour_name, np.uint8(kmeans.cluster_centers_))),
    "Pixels": new_pixels,
    "WCSS": WCSS,
    "BCSS": BCSS,
    "Explained Variance": exp_var,
    "Image Size (KB)": imageByteSize(new_pixels)
  }

  kmeans_result.append(metric)
kmeans_result = pd.DataFrame(kmeans_result).set_index("No. of Colors")
kmeans_result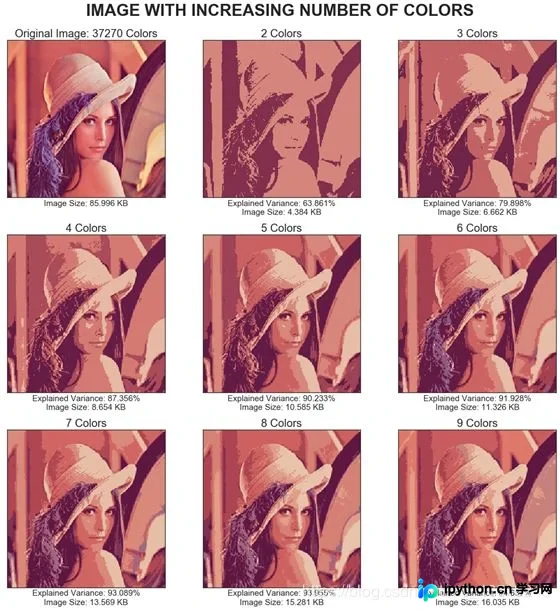
K-Means最佳聚类数k的确定
聚类指标分析:确定最佳的颜色种类数
在本节中,我们将尝试搜索最佳的颜色数(即聚类中心数)k,以便在保持较高的解释方差百分比的同时,将内存占用减小到尽可能低的水平。
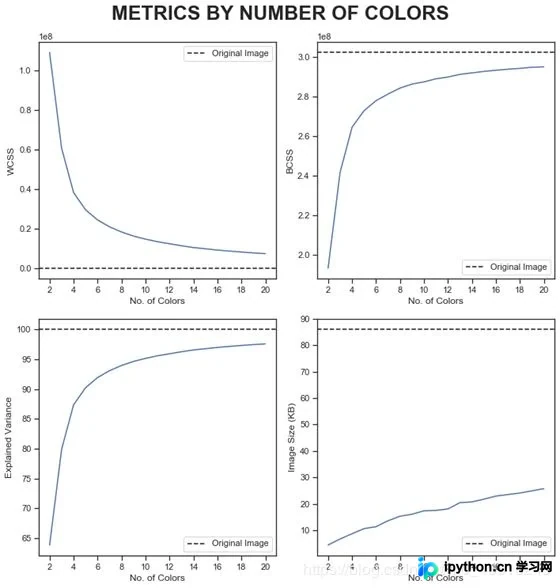
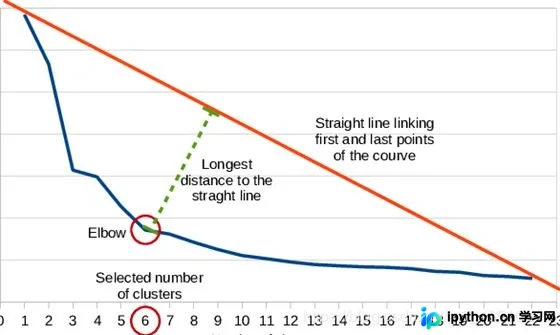
如何确定最佳颜色数k?以下是具体的算法步骤:
- 用直线连接曲线的第一个点和最后一个点
- 计算每个点到该直线的垂直距离
- 将距离最长的点视为拐点(Elbow Point)
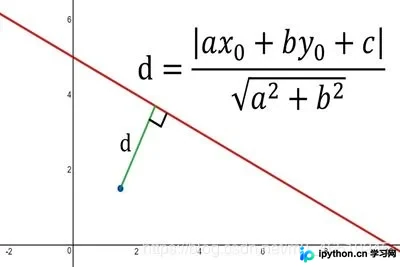
下一个问题,如何在步骤2中计算垂直距离?很简单,我们可以使用从点(x0,y0)到直线ax + by + c = 0的距离公式,如下所示:
def locateOptimalElbow(x, y):
  # START AND FINAL POINTS
  p1 = (x[0], y[0])
  p2 = (x[-1], y[-1])

  # EQUATION OF LINE: y = mx + c
  m = (p2[1] - p1[1]) / (p2[0] - p1[0])
  c = (p2[1] - (m * p2[0]))

  # DISTANCE FROM EACH POINTS TO LINE mx - y + c = 0
  a, b = m, -1
  dist = np.array([abs(a*x0+b*y0+c)/math.sqrt(a**2+b**2) for x0, y0 in zip(x,y)])
  return np.argmax(dist) + x[0]
但是,如果图形不是单调增加或减少的曲线函数,该怎么办?我们可以使用有限差分法,通过二阶导数来定位梯度变化最剧烈的地方。
什么是有限差分法?这是一种数值方法,用于近似离散值的导数。共有三种类型:
前向差分(Forward Difference):
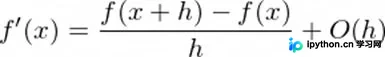
后向差分(Backward Difference):
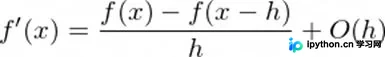
中心差分(Center Difference):
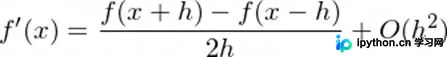
其中:
f'(x)是函数f(x)的一阶导数 h是步长,在此情况下,h = 1(颜色数的步长) O(h)是一阶误差项 O(h²)是二阶误差项
由于中心差分具有较高的误差阶数,预期它会比其他两种差分方法产生更好的结果。我们仅对第一个点使用前向差分,对最后一个点使用后向差分。
def calculateDerivative(data):
  derivative = []
  for i in range(len(data)):
    if i == 0:
      # FORWARD DIFFERENCE
      d = data[i+1] - data[i]
    elif i == len(data) - 1:
      # BACKWARD DIFFERENCE
      d = data[i] - data[i-1]
    else:
      # CENTER DIFFERENCE
      d = (data[i+1] - data[i-1])/2
    derivative.append(d)
  return np.array(derivative)
def locateDrasticChange(x, y):
  # CALCULATE GRADIENT BY FIRST DERIVATIVE
  first_derivative = calculateDerivative(np.array(y))

  # CALCULATE CHANGE OF GRADIENT BY SECOND DERIVATIVE
  second_derivative = calculateDerivative(first_derivative)
return np.argmax(np.abs(second_derivative)) + x[0]
让我们搜索每个指标下的最佳k值:
optimal_k = []
for col in kmeans_result.columns[2:]:
  optimal_k_dict = {}
  optimal_k_dict["Metric"] = col
  if col == "Image Size (KB)":
    optimal_k_dict["Method"] = "Derivative"
    optimal_k_dict["Optimal k"] = locateDrasticChange(kmeans_result.index, kmeans_result[col].values)
  else:
    optimal_k_dict["Method"] = "Elbow"
    optimal_k_dict["Optimal k"] = locateOptimalElbow(kmeans_result.index, kmeans_result[col].values)
  optimal_k.append(optimal_k_dict)
optimal_k = pd.DataFrame(optimal_k)
optimal_k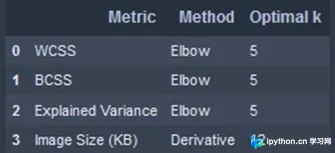
我们选择所有最优k值中最大的一个作为代表,即k = 12。
与原始图像进行比较
最后,让我们比较使用k = 12的压缩图像与原始图像的区别。
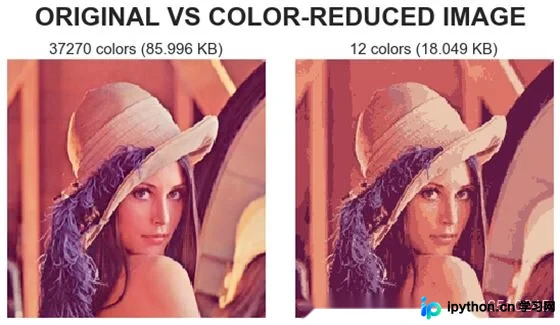
relative_size = ori_vs_kmeans.loc["Color-Reduced", "Image Size (KB)"]/ori_vs_kmeans.loc["Original", "Image Size (KB)"]
print("Reduction: {:.3f}% from original image size".format((1-relative_size)*100))
print("Explained Variance: {:.3f}%".format(ori_vs_kmeans.loc["Color-Reduced", "Explained Variance"]))
缩小比例:原始图像的79.012% 解释方差:95.916%
通过使用K-Means,我们将图像大小减少了79.012%,而解释方差达到95.916%,效果相当不错!接下来,我们执行PCA,看看它是否能优于K-Means。
PCA主成分分析降维技术
主成分分析(PCA)
基本概念
PCA是一种用于降维的无监督学习技术。它从协方差矩阵计算出特征向量,随后将其称为主轴,并按称为解释方差百分比的特征值进行降序排列。然后将数据集居中并投影到形成主要成分(或分数)的主轴上。为了减少数据维度,我们仅保留一定数量的主成分n来解释原始数据集的方差,而忽略其余部分。
假设我们有一个X_ori数据集,其中包含m个观察值和n个特征。减去每行的平均值,我们得到居中的数据X。然后,PCA将为每个特征计算k个特征向量,从而产生形状为n×k的矩阵V。 PCA投影或分数将以Z = XV给出,其中Z的尺寸为m×k。
在降维时,我们在X_ori中选择n_select小于n。以下是我们使用所选PC重建矩阵X的方法:
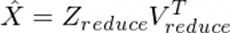
其中:
Z_reduce的尺寸为m×n_select V_reduce的维数为n×n_select T是矩阵转置运算
最后,我们添加均值以得到原始图像的最终PCA重构,如下所示:
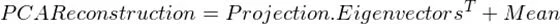
核心思路
我们将通过选择要使用的主分量n_select利用PCA来减小图像尺寸,以便它仅存储重要像素以保留原始图像的特征,从而使其在存储中更加高效。
我们的原始图像包含三个颜色通道:红色、绿色和蓝色。对于每个颜色通道,我们将像素视为具有(高度)个观察值和(宽度)个特征的二维矩阵。在lena.jpg中,我们有三个二维矩阵,包含220个观测值和220个特征。
RGB通道的主要组件
在每个颜色通道上执行PCA,从而得到PCA投影(或分数)和主成分(轴),它们都将是形状为220×220的矩阵形式。
res = []
cum_var = []
X_t = np.transpose(X)
for channel in range(3):
  # SEPARATE EACH RGB CHANNEL
  pixel = X_t[channel].reshape(*ori_pixels.shape[:2])

  # PCA
  pca = PCA(random_state = 123)
  pixel_pca = pca.fit_transform(pixel)

  pca_dict = {
    "Projection": pixel_pca,
    "Components": pca.components_,
    "Mean": pca.mean_
  }
  res.append(pca_dict)

  # EVALUATION
  cum_var.append(np.cumsum(pca.explained_variance_ratio_))
我们可以可视化每个颜色通道的主要成分,如下所示:
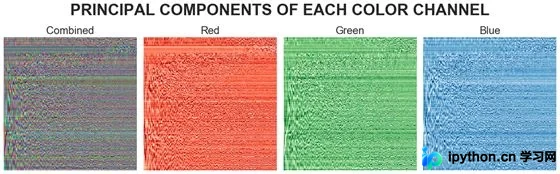
PC的可视化信息不足且随机性很大。我们应该引入一个称为解释方差的指标来评估PC性能。该指标取值范围是0到100%,表示原始图像和压缩图像之间的相似度。
cum_var_df = pd.DataFrame(np.array(cum_var).T * 100,
             index = range(1, pca.n_components_+1),
             columns = ["Explained Variance by Red",
                   "Explained Variance by Green",
                   "Explained Variance by Blue"])
cum_var_df["Explained Variance"] = cum_var_df.mean(axis = 1)
cum_var_df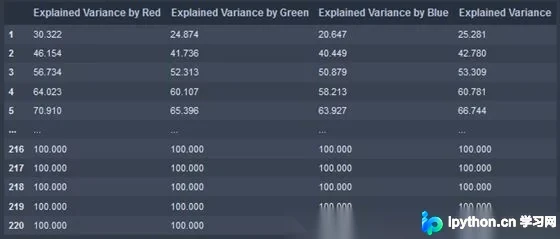
重复试验过程
在本节中,我们将重复以下步骤,从n_select到n_select = 220:
- 区分PCA投影的前n_select列和组件的前n_select行
- 使用PCA建立公式和原始图像
- 对红色、绿色和蓝色每个颜色通道重复步骤1-2。
- 将三种颜色通道的PCA重构组合为一个三维矩阵
- 保存指标值(解释方差,图像大小和颜色数量)以进行进一步优化
- 展示随着主成分数量增加后的压缩(重构)图像
pca_results = []
for n in range(1, pca.n_components_+1):
  # SELECT N-COMPONENTS FROM PC
  temp_res = []
  for channel in range(3):
    pca_channel = res[channel]
    pca_pixel = pca_channel["Projection"][:, :n]
    pca_comp = pca_channel["Components"][:n, :]
    pca_mean = pca_channel["Mean"]
    compressed_pixel = np.dot(pca_pixel, pca_comp) + pca_mean
    temp_res.append(compressed_pixel.T)
  compressed_image = np.transpose(temp_res)

  pca_dict = {
    "n": n,
    "Pixels": compressed_image,
    "Explained Variance": cum_var_df["Explained Variance"][n],
    "Image Size (KB)": imageByteSize(compressed_image),
    "No. of Colors": len(np.unique(np.uint8(compressed_image).reshape(-1, 3), axis = 0))
  }

  pca_results.append(pca_dict)
pca_results = pd.DataFrame(pca_results).set_index("n")
pca_results.head()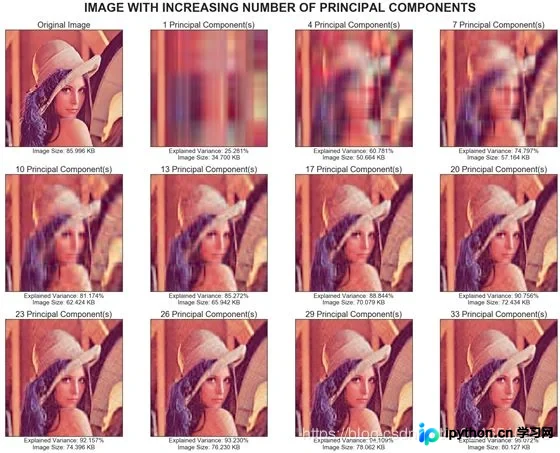
PCA最佳主成分数n_select的确定
PCA指标分析:确定主成分的最佳数量
在本节中,我们将尝试搜索最佳数量的PC,以在达到预期的解释方差的同时,使内存占用尽可能最小。
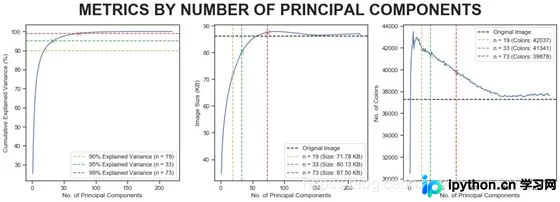
我们想通过分析解释方差来获得最佳主成分数,思考过程如下: 左图:我们需要19、33和73个主成分才能分别解释原始图像方差的90%、95%和99%。 中图:但是存在权衡取舍,解释方差越大,图像尺寸就越大。黑色虚线表示原始图像尺寸,我们要在此线下方选择n。因此,选择19或33个主成分。 右图:如果将n从19增加到33,再到73,则图像中存在的颜色数量将减少。
从图中可以得出结论,应当选择33个主成分,因为它提供了较小的图像大小和相当高的解释方差,并且比使用19个主要成分更接近原始图像。
与原始图像进行比较
最后,让我们对压缩图像和原始图像进行比较。
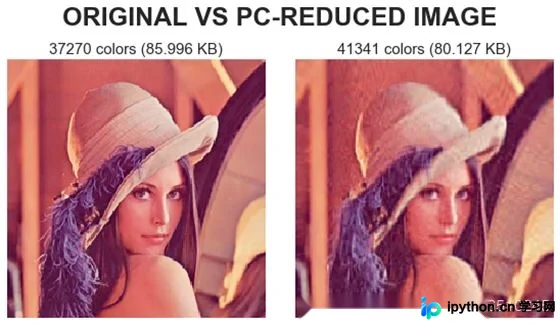
relative_size = ori_vs_pca.loc["PC-Reduced", "Image Size (KB)"]/ori_vs_kmeans.loc["Original", "Image Size (KB)"]
print("Reduction: {:.3f}% from original image size".format((1-relative_size)*100))
print("Explained Variance: {:.3f}%".format(ori_vs_pca.loc["PC-Reduced", "Explained Variance"]))
缩小比例:原始图像大小的6.825% 解释方差:95.072%
通过使用PCA,我们仅将图像大小减小了6.825%,并且压缩后的图像成功捕获了原始图像的95.072%的特征。接下来,我们比较K-Means和PCA的结果。
K-Means与PCA结果对比分析
K-Means与PCA的比较
我们考虑几个指标,以比较使用K-Means和PCA压缩图像的效果:
图片大小(以千字节为单位)、解释方差、图像中存在的颜色数
reduction_kmeans = (1-final_compare.loc["Color-Reduced", "Image Size (KB)"] / ori_img_size) * 100
reduction_pca = (1-final_compare.loc["PC-Reduced", "Image Size (KB)"] / ori_img_size) * 100
print("Image Size Reduction using K-Means: {:.3f}%".format(reduction_kmeans))
print("Image Size Reduction using PCA: {:.3f}%".format(reduction_pca))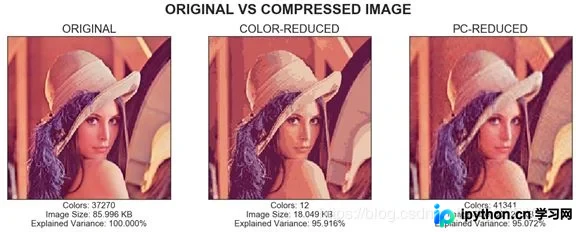
使用K-Means缩小图像大小:79.012% 使用PCA缩小图像大小:6.825%
总结与建议
结论
我们使用无监督学习算法成功实现了图像压缩,例如K-Means聚类和用于降维的主成分分析(PCA)。
在K-Means中,通常通过可视化来主观地选择最佳聚类中心数k。在这里,我们提出两种选择方法,即:
- 使用最长垂直距离的方法
- 使用有限差分法和二阶导数
在PCA中,确定使用的PC数量首先要考虑解释方差,然后还要考虑图像大小减小的比例和减少颜色的数量,以分析它们与原始图像的相似性。
使用K-Means,图像大小减小到79.012%,仅12种颜色就能解释原始图像的95.916%差异。使用PCA,图像大小减小仅为6.825%,并根据我们的目标解释了95,072%的差异。在经过PCA缩小的图像中,与原始图像相比,存在更多的颜色数量,表明存在噪音。从主观上可以看出,PCA压缩的图像更加粗糙。
与PCA相比,更建议使用K-Means来缩小图像尺寸,但如果我们要保持原始图像的整体色彩,请使用PCA。
另一个建议是尝试连续执行两种方法来进行图像缩小,即先用K-Means再用PCA,或是先用PCA再用K-Means。
作者:Tomy Tjandra
deephub翻译组:孟翔杰
到此这篇关于在Python中使用K-Means聚类和PCA主成分分析进行图像压缩的文章就介绍到这了,更多相关Python 图像压缩内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









