

Python中PDF与CDF分布图的生成与可视化方法

本文介绍在Python中如何生成概率密度函数(PDF)和累积分布函数(CDF)的可视化图表。通过Matplotlib、NumPy和Seaborn库,演示了直接绘图、数据提取及分布拟合的方法,并提供了将归一化PDF与CDF结合展示的完整代码示例,帮助开发者快速掌握数据分布分析技巧。
数据分布分析概述
获取数据后,首要任务之一是分析数据的分布特征。数据分布通常通过概率密度函数(PDF)和累积分布函数(CDF)两种形式来呈现。
Python生成PDF分布图的方法
接下来介绍利用Python生成PDF分布图的具体方法。
利用Matplotlib库中的hist()函数接口,可以直接绘制出数据的PDF分布直方图。
调用NumPy库中的histogram()函数,可以获取PDF分布的具体数值数据。这种方式便于后续的数据处理,例如基于这些数据进一步生成CDF。
使用Seaborn库的distplot()函数,其优势在于支持对PDF分布进行拟合,从而帮助用户判断数据符合何种分布类型。
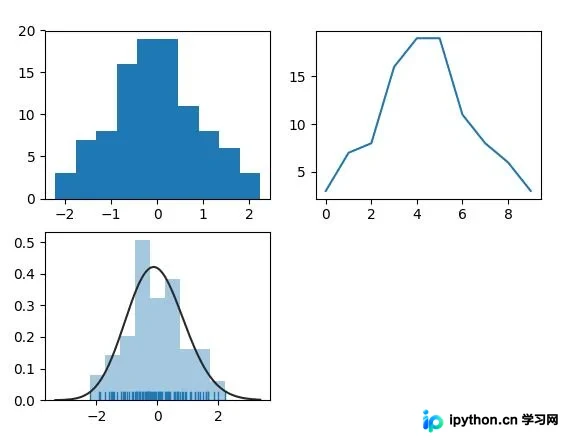
上图展示了通过上述三种算法生成的PDF对比图,对应的源代码如下。
from scipy import stats
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

arr = np.random.normal(size=100)

# plot histogram
plt.subplot(221)
plt.hist(arr)

# obtain histogram data
plt.subplot(222)
hist, bin_edges = np.histogram(arr)
plt.plot(hist)

# fit histogram curve
plt.subplot(223)
sns.distplot(arr, kde=False, fit=stats.gamma, rug=True)
plt.show()
Python生成CDF分布图的方法
随后介绍Python中生成CDF分布图的实现方式。
首先使用NumPy的histogram()函数生成PDF分布数据,再通过累加计算得到CDF数据。
利用Seaborn库中的cumfreq()函数,可以直接绘制出CDF曲线。
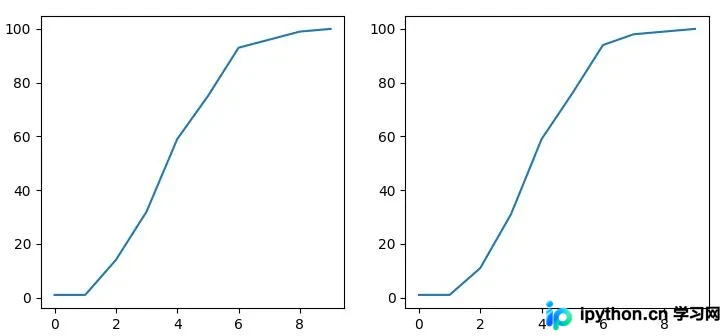
上图展示了通过两种算法生成的CDF对比图,具体源代码见下。
from scipy import stats
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

arr = np.random.normal(size=100)

plt.subplot(121)
hist, bin_edges = np.histogram(arr)
cdf = np.cumsum(hist)
plt.plot(cdf)

plt.subplot(122)
cdf = stats.cumfreq(arr)
plt.plot(cdf[0])

plt.show()
PDF与CDF归一化组合展示
在实际应用中,往往需要将PDF和CDF置于同一图表中,以更直观地展示数据分布全貌。实现这一需求的关键步骤是对PDF和CDF分别进行归一化处理。
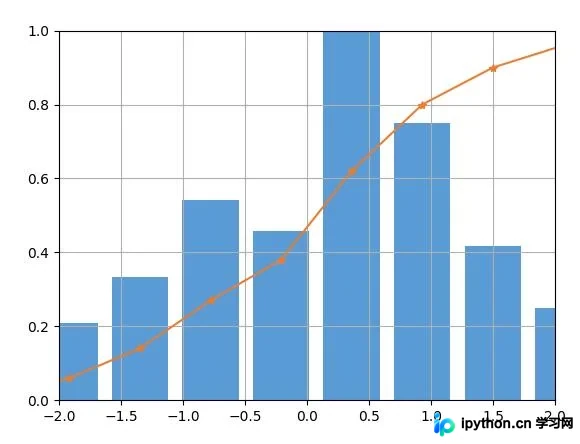
上图展示了经过归一化处理后的PDF与CDF组合图,相关源代码如下。
from scipy import stats
import matplotlib.pyplot as plt
import numpy as np
import seaborn as sns

arr = np.random.normal(size=100)

hist, bin_edges = np.histogram(arr)
width = (bin_edges[1] - bin_edges[0]) * 0.8
plt.bar(bin_edges[1:], hist/max(hist), width=width, color='#5B9BD5')

cdf = np.cumsum(hist/sum(hist))
plt.plot(bin_edges[1:], cdf, '-*', color='#ED7D31')

plt.xlim([-2, 2])
plt.ylim([0, 1])
plt.grid()

plt.show()
以上就是Python处理PDF与CDF分布图的完整实例分享,希望能为读者提供有价值的参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









