

Python绘制中国大陆人口热力图:修正版教程

本文介绍如何使用Python的Basemap库绘制中国大陆人口密度热力图。针对原教程运行问题,提供了从环境配置、省界数据下载、人口数据处理到地图渲染的完整修正代码。重点解决了地名匹配、颜色映射及省份名称标准化等细节,确保图表准确显示各省人口分布情况。
此前有教程介绍了如何绘制中国人口密度图,但在实际运行中可能存在若干问题。本文对这些步骤进行了必要的修改和完善,以确保代码能够顺利执行并生成正确的结果。
本教程基于Anaconda集成开发环境,建议在Anaconda Prompt命令行工具中预先安装Basemap相关依赖包,以确保后续绘图功能正常运行。
conda install Basemap
创建新的Python脚本文件,并在代码开头导入绘图及数据处理所需的各类库,包括Matplotlib、Basemap、Numpy和Pandas等。
import matplotlib.pyplot as plt
from mpl_toolkits.basemap import Basemap
from matplotlib.patches import Polygon
from matplotlib.colors import rgb2hex
import numpy as np
import pandas as pd
Basemap库默认不包含中国详细的省界数据,因此需要前往指定网站下载中国省界的Shapefile格式数据,并选择Shapefile进行下载保存。
利用下载好的省界数据生成中国大陆的行政边界图像,为后续叠加人口数据做准备。
plt.figure(figsize=(16,8))
m = Basemap(
 llcrnrlon=77,
 llcrnrlat=14,
 urcrnrlon=140,
 urcrnrlat=51,
 projection='lcc',
 lat_1=33,
 lat_2=45,
 lon_0=100
)
m.drawcountries(linewidth=1.5)
m.drawcoastlines()

m.readshapefile('gadm36_CHN_shp/gadm36_CHN_1', 'states', drawbounds=True)
访问国家统计局官方网站,下载最新的人口统计数据,筛选出“地区”和“总人口”两列信息,将文件保存为CSV格式,并命名为pop.csv以便程序读取。
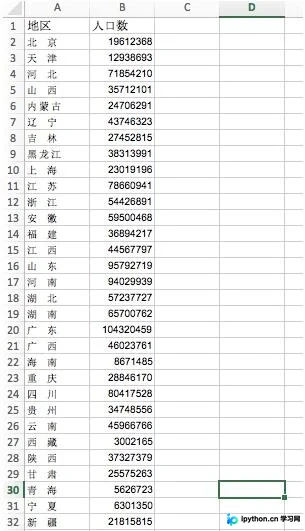
使用Pandas读取pop.csv文件,将数据转换为DataFrame格式。处理过程中需去除地区名称中的空格,并将处理后的地区名称设置为DataFrame的索引,以便后续匹配。
df = pd.read_csv('pop.csv')
new_index_list = []
for i in df["地区"]:
 i = i.replace(" ","")
 new_index_list.append(i)
new_index = {"region": new_index_list}
new_index = pd.DataFrame(new_index)
df = pd.concat([df,new_index], axis=1)
df = df.drop(["地区"], axis=1)
df.set_index("region", inplace=True)
建立Basemap中的地理区域标识与CSV文件中人口数据之间的对应关系字典。由于Basemap输出的地名格式与CSV文件中的名称存在差异,需要进行相应的清洗和转换处理以实现准确匹配。
provinces = m.states_info
statenames=[]
colors = {}
cmap = plt.cm.YlOrRd
vmax = 100000000
vmin = 3000000

for each_province in provinces:
 province_name = each_province['NL_NAME_1']
 p = province_name.split('|')
 if len(p) > 1:
  s = p[1]
 else:
  s = p[0]
 s = s[:2]
 if s == '黑龍':
  s = '黑龙江'
 if s == '内蒙':
  s = '内蒙古'
 statenames.append(s)
 pop = df['人口数'][s]
 colors[s] = cmap(np.sqrt((pop - vmin) / (vmax - vmin)))[:3]
完成数据映射和颜色配置后,调用绘图函数生成最终的人口热力图,并显示结果。
ax = plt.gca()
for nshape, seg in enumerate(m.states):
 color = rgb2hex(colors[statenames[nshape]])
 poly = Polygon(seg, facecolor=color, edgecolor=color)
 ax.add_patch(poly)

plt.show()
以下是经过修正后的完整Python代码,整合了上述所有步骤。
# -*- coding: utf-8 -*-

import matplotlib.pyplot as plt
from mpl_toolkits.basemap import Basemap
from matplotlib.patches import Polygon
from matplotlib.colors import rgb2hex
import numpy as np
import pandas as pd

plt.figure(figsize=(16,8))
m = Basemap(
 llcrnrlon=77,
 llcrnrlat=14,
 urcrnrlon=140,
 urcrnrlat=51,
 projection='lcc',
 lat_1=33,
 lat_2=45,
 lon_0=100
)
m.drawcountries(linewidth=1.5)
m.drawcoastlines()

m.readshapefile('gadm36_CHN_shp/gadm36_CHN_1', 'states', drawbounds=True)

df = pd.read_csv('pop.csv')
new_index_list = []
for i in df["地区"]:
 i = i.replace(" ","")
 new_index_list.append(i)
new_index = {"region": new_index_list}
new_index = pd.DataFrame(new_index)
df = pd.concat([df,new_index], axis=1)
df = df.drop(["地区"], axis=1)
df.set_index("region", inplace=True)

provinces = m.states_info
statenames=[]
colors = {}
cmap = plt.cm.YlOrRd
vmax = 100000000
vmin = 3000000

for each_province in provinces:
 province_name = each_province['NL_NAME_1']
 p = province_name.split('|')
 if len(p) > 1:
  s = p[1]
 else:
  s = p[0]
 s = s[:2]
 if s == '黑龍':
  s = '黑龙江'
 if s == '内蒙':
  s = '内蒙古'
 statenames.append(s)
 pop = df['人口数'][s]
 colors[s] = cmap(np.sqrt((pop - vmin) / (vmax - vmin)))[:3]

ax = plt.gca()
for nshape, seg in enumerate(m.states):
 color = rgb2hex(colors[statenames[nshape]])
 poly = Polygon(seg, facecolor=color, edgecolor=color)
 ax.add_patch(poly)

plt.show()
以上就是本文的全部内容,希望对读者在Python数据可视化方面的学习有所帮助,欢迎继续支持本站获取更多技术资源。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









