

Python sklearn实现PCA降维:以鸢尾花数据可视化为例

本文详细介绍如何使用Python的sklearn库进行主成分分析(PCA)降维。通过鸢尾花数据集实例,演示将4维数据降至2维并在平面可视化的完整过程,涵盖从数据加载、模型训练到结果展示的具体代码与参数说明,帮助读者掌握高维数据探索与预处理技巧。
PCA简介与基本原理
PCA简介
主成分分析(Principal Component Analysis,PCA)是一种广泛使用的降维技术,主要应用于高维数据集的探索性分析与可视化,同时也常用于数据压缩及预处理环节。在数学层面,矩阵的主成分对应于其协方差矩阵的特征向量。这些特征向量依据对应的特征值大小进行排序,其中特征值最大的方向定义为第一主成分,次大的为第二主成分,依此类推。
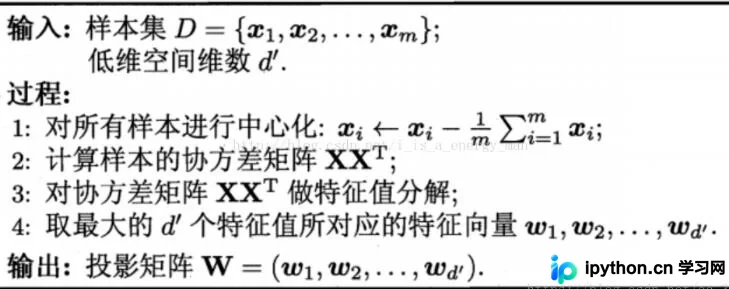
基本步骤:
Python sklearn实现PCA降维
具体实现
利用Python中的sklearn库对鸢尾花数据进行降维处理。原始数据包含4个维度,通过PCA降维后转换为2个维度,从而能够在二维平面直观展示样本点的分布情况。样本数据的结构如下图所示:
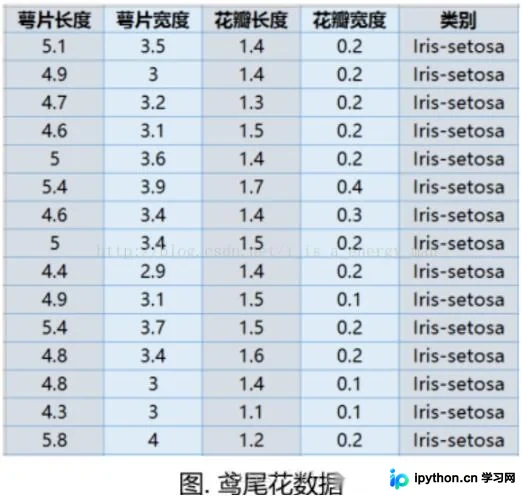
该数据集总共包含150个样本,涵盖三种不同的鸢尾花类别,分别用标签0、1和2进行标记。
代码
import matplotlib.pyplot as plt     #加载matplotlib用于数据的可视化
from sklearn.decomposition import PCA   #加载PCA算法包
from sklearn.datasets import load_iris


data=load_iris()
y=data.target
x=data.data
pca=PCA(n_components=2)  #加载PCA算法,设置降维后主成分数目为2
reduced_x=pca.fit_transform(x)#对样本进行降维

red_x,red_y=[],[]
blue_x,blue_y=[],[]
green_x,green_y=[],[]


for i in range(len(reduced_x)):
 if y[i] ==0:
  red_x.append(reduced_x[i][0])
  red_y.append(reduced_x[i][1])

 elif y[i]==1:
  blue_x.append(reduced_x[i][0])
  blue_y.append(reduced_x[i][1])

 else:
  green_x.append(reduced_x[i][0])
  green_y.append(reduced_x[i][1])

#可视化
plt.scatter(red_x,red_y,c='r',marker='x')
plt.scatter(blue_x,blue_y,c='b',marker='D')
plt.scatter(green_x,green_y,c='g',marker='.')
plt.show()
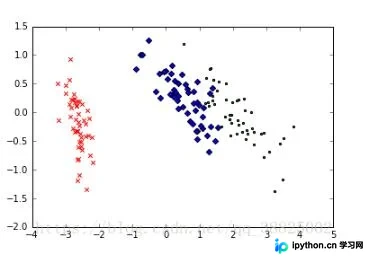
结果图
知识拓展:python sklearn PCA 实例代码-主成分分析
python sklearn decomposition PCA 主成分分析
主成分分析(PCA)
1、主成分分析(Principal Component Analysis,PCA)是最常用的一种降维方法,
通常用于高维数据集的探索与可视化,还可以用作数据压缩和预处理
2、PCA可以把具有相关性的高维变量合成为线性无关的低维变量,称为主成分。
主成分能够尽可能保留原始数据的信息
3、概念
方差:用来度量一组数据的分散程度
协方差:用来度量两个变量之间的线性相关性程度,若两个变量的协议差为0,二者线性无关
协方差矩阵:矩阵的特征向量是描述数据集结构的非零向量,?? ⃗=?? ⃗
特征向量和特征值:? ⃗ 特征向量,?是特征值
4、提取:
矩阵的主成分是其协方差矩阵对应的特征向量,按照对应的特征值大小进行排序,最大的特征值就是第一主成分,其次是第二主成分
5、原理:
1、对所有样本进行中心化:xi-(x1+x2…xm)/m 2、计算样本的协方差矩阵X(X.T) 3、对协方差矩阵X(X.T)做特征值分解 4、取最大的d个特征值所对应的特征向量w1,w2…wd
输出投影矩阵W=(w1,w2,…,wd)
6、参数说明
sklearn.decomposition.PCA(n_components=None,copy=True,whithen=False,svd_solver=‘auto',tol=0.0,
iterated_power=‘auto',random_state=None)
n_components:指定主成分的个数,即降维后数据的维度
svd_slover:设置特征值分解的方法:‘full',‘arpack',‘randomized'
高维数据可视化实例与参数详解
PCA实现高维度数据可视化 实例
目标:
已知鸢尾花数据是4维的,共三类样本,使用PCA实现对鸢尾花数据进行降维,实现在二维平面上的可视化
实例程序编写
import matplotlib.pyplot as plt
import sklearn.decomposition as dp
from sklearn.datasets.base import load_iris

x,y=load_iris(return_X_y=True) #加载数据,x表示数据集中的属性数据,y表示数据标签
pca=dp.PCA(n_components=2) #加载pca算法,设置降维后主成分数目为2
reduced_x=pca.fit_transform(x) #对原始数据进行降维,保存在reduced_x中
red_x,red_y=[],[]
blue_x,blue_y=[],[]
green_x,green_y=[],[]
for i in range(len(reduced_x)): #按鸢尾花的类别将降维后的数据点保存在不同的表表中
 if y[i]==0:
  red_x.append(reduced_x[i][0])
  red_y.append(reduced_x[i][1])
 elif y[i]==1:
  blue_x.append(reduced_x[i][0])
  blue_y.append(reduced_x[i][1])
 else:
  green_x.append(reduced_x[i][0])
  green_y.append(reduced_x[i][1])
plt.scatter(red_x,red_y,c='r',marker='x')
plt.scatter(blue_x,blue_y,c='b',marker='D')
plt.scatter(green_x,green_y,c='g',marker='.')
plt.show()
以上这篇Python sklearn库实现PCA教程(以鸢尾花分类为例)就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









