

Python实现PCA主成分分析降维详解

本文详解利用Python进行主成分分析(PCA)降维的方法。通过sklearn库实现从数据读取、矩阵转换到降维输出的完整流程,并解析PCA缓解维度灾难、压缩数据及可视化高维结构的原理。代码展示如何提取前两个主成分并保存结果,适用于探索高维数据分布与预处理场景。
PCA降维概述
概述
本文重点介绍一种常用的降维技术:主成分分析(Principal Component Analysis,简称PCA)。降维技术主要旨在解决以下三类核心问题。
首先,降维能够有效缓解维度灾难带来的挑战;
其次,在压缩数据规模的同时,尽可能最小化信息的损失;
最后,人类难以直观理解数百个维度的数据结构,而通过两三个维度的可视化方式,可以更轻松地理解数据特征。
PCA原理与主成分解析
PCA简介
在进行特征提取与处理时,高维特征向量往往容易引发维度灾难。随着数据集维度的增加,算法学习所需的样本数量呈指数级增长。在某些应用场景中,处理这样的大数据不仅不利,还需要更多的内存资源和计算能力。此外,随着维度增加,数据的稀疏性日益严重。在高维向量空间中探索相同的数据集,比在低维稀疏数据集中探索要困难得多。
主成分分析,也被称为卡尔胡宁-勒夫变换(Karhunen-Loeve Transform),是一种用于探索高维数据结构的技术。PCA通常应用于高维数据集的探索与可视化,也可用于数据压缩和预处理。PCA能够将可能存在相关性的高维变量合成线性无关的低维变量,这些低维变量称为主成分(principal components)。新的低维数据集旨在尽可能保留原始数据中的变量信息。
PCA通过将数据投射到一个低维子空间来实现降维。例如,将二维数据集降维即为将点投射成一条直线,此时数据集中的每个样本仅需用一个值表示,无需两个值。三维数据集可降为二维,即将变量映射为一个平面。一般情况下,n维数据集可通过映射降为k维子空间,其中k≤n。
假设你是一名养花工具宣传册的摄影师,正在拍摄一个水壶。水壶本身是三维物体,但照片是二维的。为了更全面地向客户展示水壶,你需要从不同角度拍摄多张照片。下图展示了从四个方向拍摄的照片:
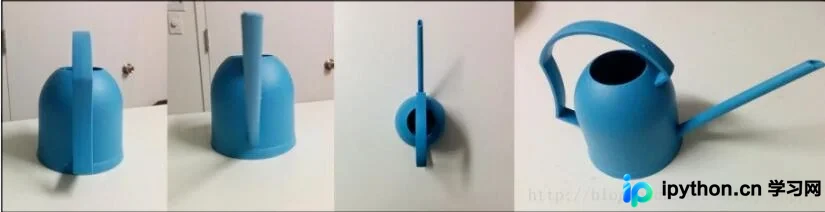
第一张照片展示了水壶的背面,但看不到正面。第二张拍摄的是正面,可以看到壶嘴,这张图提供了第一张图缺失的信息,但壶把不可见。从第三张俯视图中无法判断水壶的高度。第四张是你真正需要的视角,水壶的高度、顶部、壶嘴和壶把都清晰可见。
PCA的设计理念与此类似,它可以将高维数据集映射到低维空间,同时尽可能保留更多的变量信息。PCA通过旋转数据集使其与主成分对齐,将最多的变量保留到第一主成分中。假设我们有如下所示的数据集:
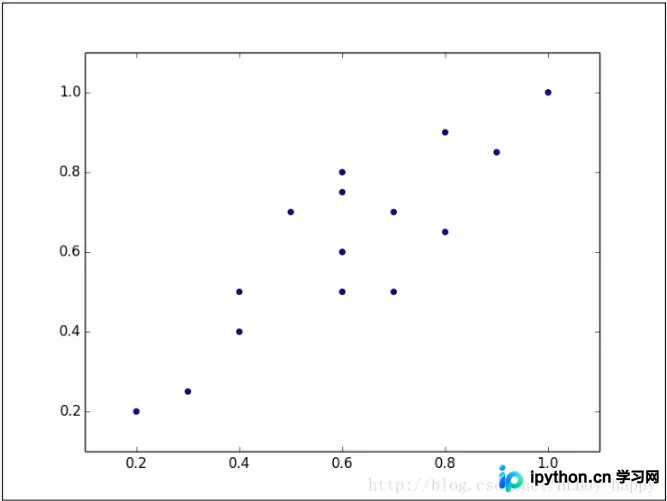
该数据集看起来像一个从原点延伸至右上角的细长扁平椭圆。要降低整个数据集的维度,我们必须将点映射成一条直线。下图中展示了两条可能的映射直线,样本映射到哪条直线时变化最大?
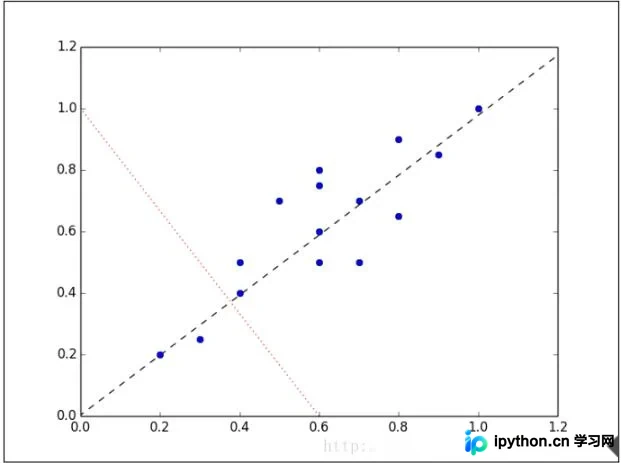
显然,样本映射到黑色虚线时的变化比映射到红色点线的变化大得多。实际上,这条黑色虚线即为第一主成分。第二主成分必须与第一主成分正交,即在统计学上独立,出现在与第一主成分垂直的方向,如下图所示:
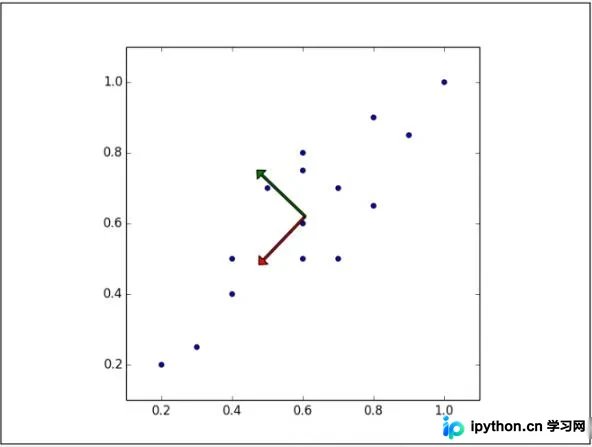
后续的每个主成分也会尽量多地保留剩余的变量,唯一的要求是每一个主成分必须与前一个主成分正交。
现在假设数据集是三维的,散点图看起来像是沿着一个轴旋转的圆盘。
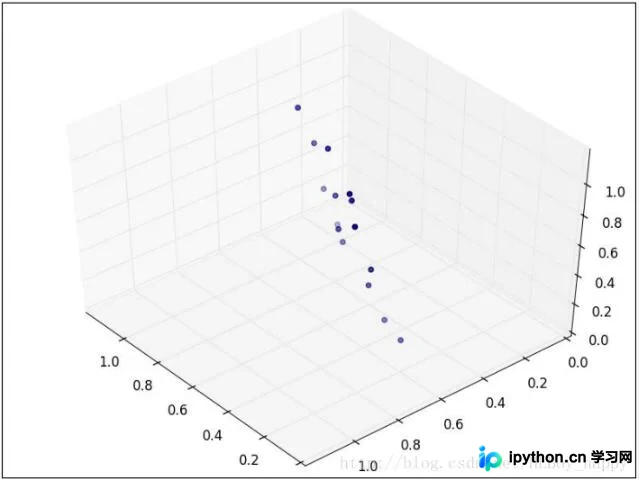
这些点可以通过旋转和变换使圆盘完全变成二维。此时这些点看起来像一个椭圆,第三维上几乎没有变量,可以被忽略。
当数据集在不同维度上的方差分布不均匀时,PCA最为有效。(如果是一个球壳形数据集,PCA不能有效发挥作用,因为各个方向上的方差都相等;没有丢失大量信息,任何一个维度都不能忽略)。
Python代码实现
Python实现PCA降维代码
# coding=utf-8
from sklearn.decomposition import PCA
from pandas.core.frame import DataFrame
import pandas as pd
import numpy as np
l=[]
with open('test.csv','r') as fd:

  line= fd.readline()
  while line:
    if line =="":
      continue

    line = line.strip()
    word = line.split(",")
    l.append(word)
    line= fd.readline()

data_l=DataFrame(l)
print (data_l)
dataMat = np.array(data_l)


pca_sk = PCA(n_components=2)
newMat = pca_sk.fit_transform(dataMat)


data1 = DataFrame(newMat)
data1.to_csv('test_PCA.csv',index=False,header=False)
以上这篇Python实现PCA降维的示例详解就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









