

python字符串切片进阶:步长参数与逆向截取技巧

掌握字符串切片的步长参数
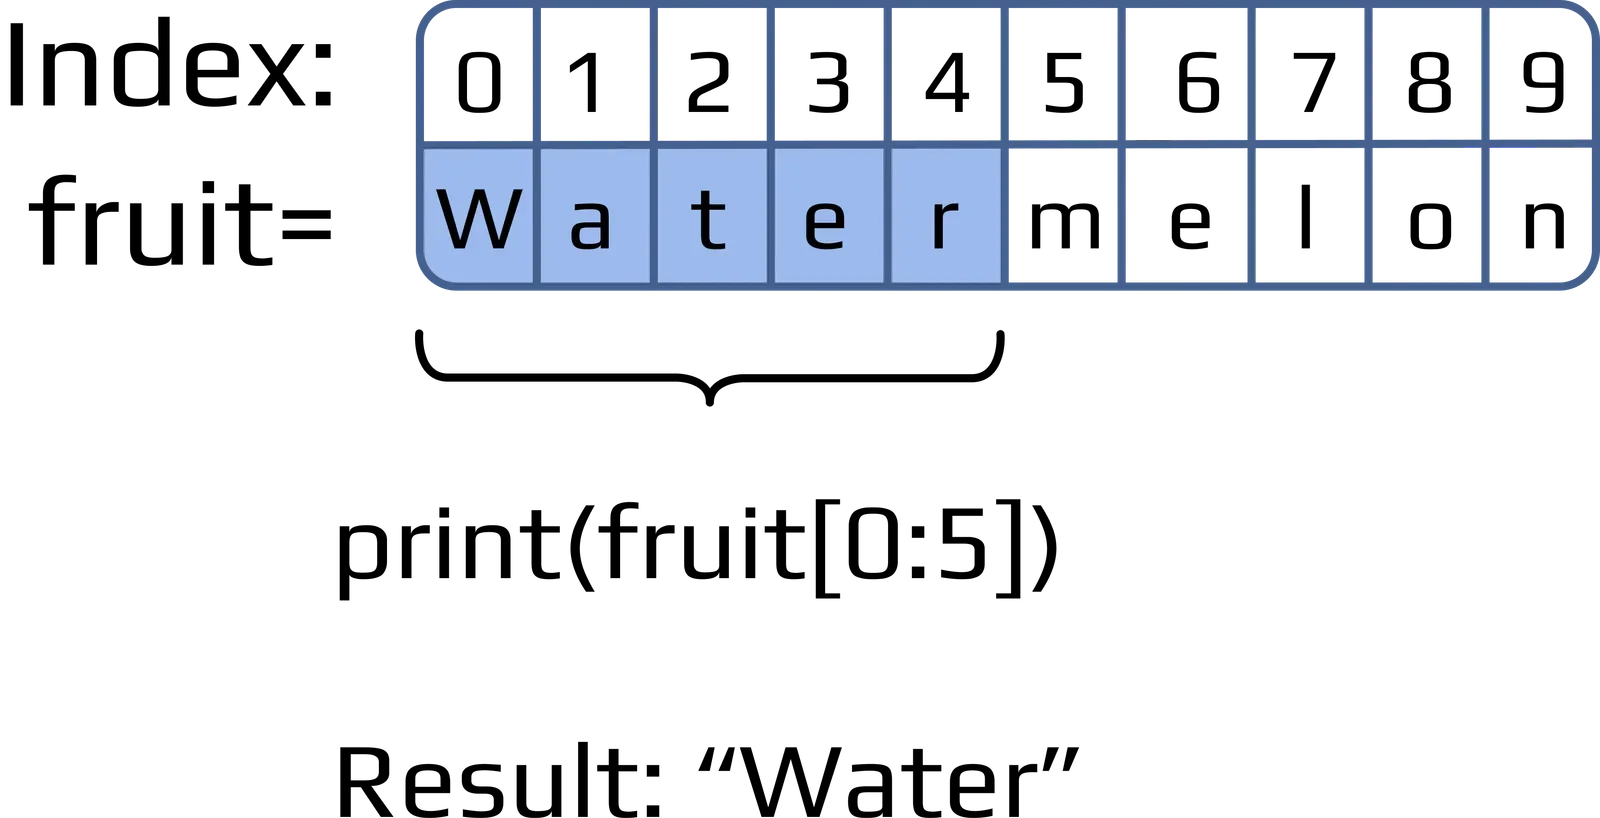
Python字符串切片的基础语法为[start:stop:step],其中start表示起始索引(包含),stop表示结束索引(不包含),step为步长,决定每次移动的跨度。当step为正整数时,切片方向从左向右进行。若省略start和stop,默认从索引0开始至字符串末尾结束。例如,对字符串s = "PythonProgramming"执行s[::2],步长为2意味着每隔一个字符取一次,结果为"PtoPormig";若设置s[::3],步长为3则每隔两个字符取一次,得到"Phrorg"。在实际编码中,正步长非常适合提取固定间隔的特征字符或进行数据采样。需要注意的是,step必须为非零整数,且当step大于字符串长度时,仅返回起始位置的单个字符。通过合理配置正步长,开发者可以高效完成字符串的降维与模式提取,而无需编写冗长的循环逻辑。
使用负步长实现逆向截取与字符串反转
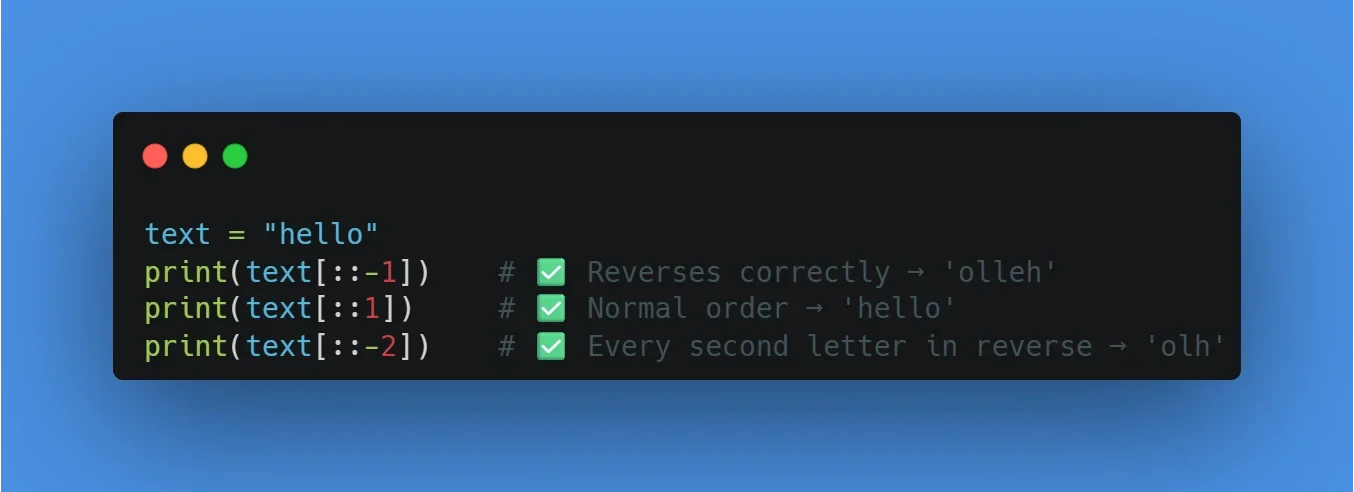
当步长参数step设置为负数时,Python的切片引擎会改变遍历方向,从右向左进行索引移动。此时,start与stop的默认值也会发生翻转:若省略start,默认指向字符串最后一个字符;若省略stop,默认指向字符串开头之前。例如,对字符串text = "DataScience"执行text[::-1],由于步长为-1且起止位置均省略,系统会从末尾逐个向前取值,直接输出"ecneicSataD",这是Python中最简洁高效的字符串反转写法。若需截取特定区间的逆序片段,可使用text[8:3:-1],表示从索引8(字符'c')开始向左移动,直到索引3(不包含)停止,结果为"cneic"。负步长的核心在于方向与索引边界的严格对应,一旦start位于stop左侧且步长为负,切片将直接返回空字符串。掌握这一机制后,开发者可轻松实现日志时间戳倒排、序列逆序校验等复杂文本处理任务。
验证边界与方向:避免切片结果为空
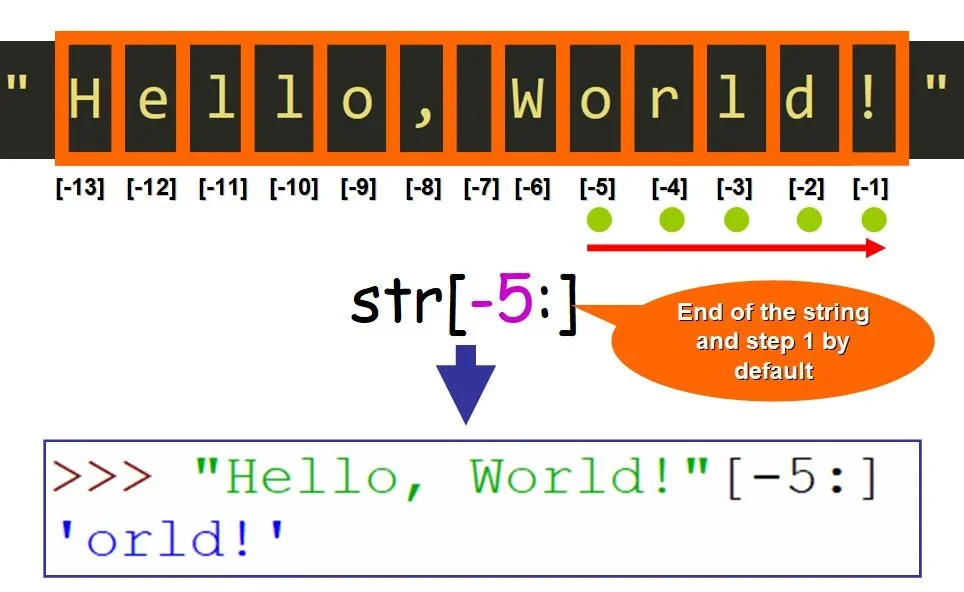
在实际开发中,切片结果为空或抛出异常往往源于方向与边界的不匹配。首先,步长方向必须与起止索引的逻辑顺序一致:正步长要求start < stop,负步长要求start > stop,否则将返回空字符串。例如"abcde"[4:1:1]因方向冲突返回"",而"abcde"[4:1:-1]则正确输出"edc"。其次,负索引在切片中完全合法,"hello"[-2:-5:-1]会从倒数第二个字符向左截取至倒数第五个字符前,结果为"lle"。对于越界索引,Python具备自动截断机制,如"test"[0:100:2]不会报错,而是安全返回"tt"。然而,step参数绝对不可为0,执行"data"[::0]会立即触发ValueError: slice step cannot be zero异常。建议在编写关键切片逻辑时,通过print()输出中间变量或使用断言验证长度,确保索引方向与业务预期严格对齐,从而规避隐蔽的逻辑漏洞。
结合实际场景选择合适的进阶切片写法
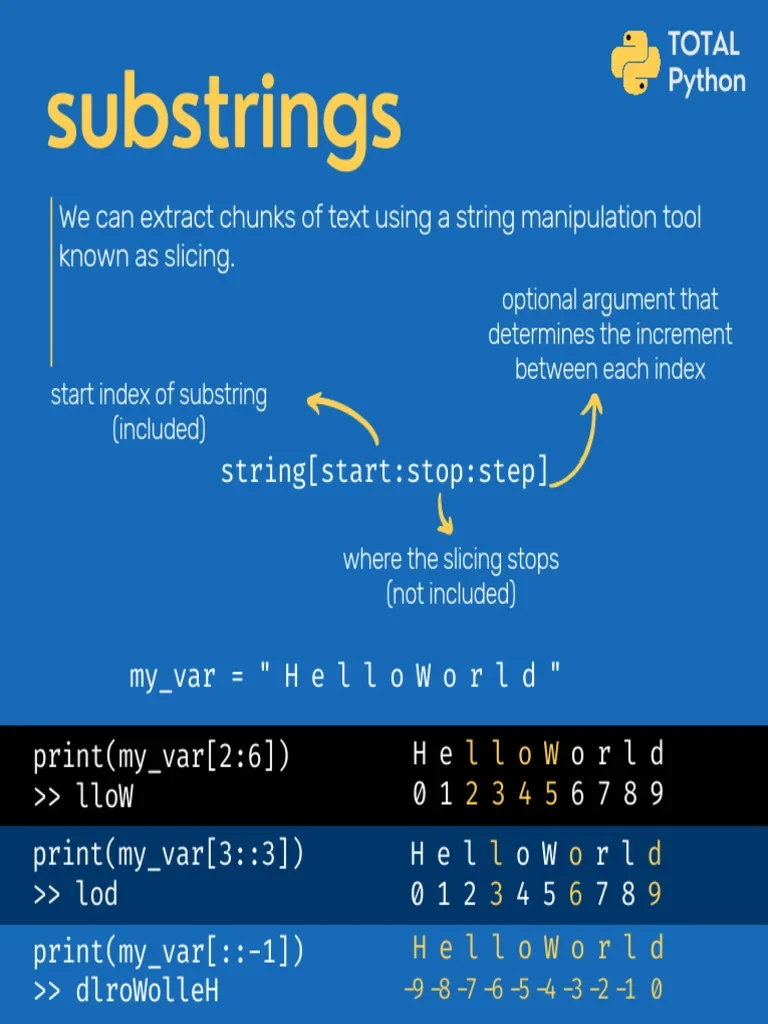
进阶切片技巧在真实业务场景中具有极高的实用价值。以处理传感器日志字符串log = "2023-10-05_14:30:22_TEMP_OK"为例,若需提取日期部分并反转显示,可组合使用log[:10][::-1],先截取前10位得到"2023-10-05",再逆序输出"50-01-3202"。若需每隔3个字符采样一次以压缩传输数据,使用log[::3]即可快速生成摘要。当需要验证末尾状态码是否匹配时,负步长切片尤为高效:log[-6:-1:2]从倒数第6位开始向左隔位取值,可精准提取关键字段。在实际选型时,若仅需整体倒序,优先使用[::-1];若需按固定间隔提取特征,选用正步长[::n];若涉及区间逆序截取,则必须显式指定start与stop并配合负步长。通过组合这些切片模式,开发者能以极少的代码量完成复杂的字符串清洗、格式转换与数据校验工作,显著提升脚本执行效率与可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









