

Python实现音频播放与录音及波形可视化教程

本文详解Python中音频文件的基础处理方式,涵盖三种音频播放方法(os.system、PyAudio、Jupyter Notebook)及wave、scipy、librosa库的读取差异。通过代码示例演示如何提取采样率与音频数据,绘制时间-振幅波形图,并利用PyAudio实现连续录音功能,为后续语音识别任务奠定基础。
音频预处理
本节主要介绍音频的基本处理方式,旨在为后续的语音识别任务打下基础。
三种播放音频的方式
在Python中,播放音频文件主要有以下几种实现途径:
os.system()方法
通过调用os.system(file)可以启动系统默认应用来打开指定文件,该文件可以是图片或音频格式。
该方法的局限性在于必须启动具体的应用程序,且无法在后台静默播放音频。
PyAudio库
安装命令为pip install pyaudio。
官方提供了便捷的音频播放与录音API,只需将代码中的文件名替换为实际的音频文件路径即可实现播放。
"""PyAudio Example: Play a WAVE file."""

import pyaudio
import wave


CHUNK = 1024
FILENAME = '你的音频文件'

def play(filename = FILENAME):
 wf = wave.open(filename, 'rb')

 p = pyaudio.PyAudio()

 stream = p.open(format=p.get_format_from_width(wf.getsampwidth()),
   channels=wf.getnchannels(),
   rate=wf.getframerate(),
   output=True)

 data = wf.readframes(CHUNK)

 while data != b'':
 stream.write(data)
 data = wf.readframes(CHUNK)

 stream.stop_stream()
 stream.close()

 p.terminate()
Jupyter Notebook环境
在Jupyter Notebook环境中,可以通过以下函数直接播放音频:
import IPython.display as ipd
ipd.Audio(文件名)
几种读取音频的方式
Python提供了多种读取音频文件的库,包括内置的wave库、科学计算库scipy以及便捷易用的语音处理库librosa。下文将分别介绍如何使用这些库读取音频文件:
安装步骤如下:
- wave为Python内置库,直接导入即可使用。
- scipy库需通过命令pip install scipy安装。
- librosa库需通过命令pip install librosa安装。
具体使用示例如下:
wave.open函数:
参数path指定文件名,mode指定打开模式。
以'rb'模式打开文件将返回Wave_read对象,而以'wb'模式打开则返回Wave_write对象。
scipy.io.wavfile函数:
参数path指定文件名。
该函数返回rate(采样率,即每秒采样点数)和data(音频数据)。
librosa.load函数:
参数path指定文件名。
该函数返回y(音频数据)和sr(采样率)。
# read wav file from path
from scipy.io import wavfile
import librosa
import pyaudio

# wave
file = wave.open(path,'rb')
# wavfile
rate, data = wavfile.read(path)
# librosa
y, sr = librosa.load(path)
以下演示使用wavfile读取音频文件并绘制波形的示例:
首先需要计算音频的持续时间。wave数组的shape表示总采样点个数,将其除以采样频率可得总持续时间(秒),乘以1000则得到毫秒级的总时长。接着利用np.linspace生成时间序列,最后使用matplotlib绘制图像。
from scipy.io import wavfile
import matplotlib.pyplot as plt
import numpy as np
%matplotlib inline

# 一秒采样数
sr, wave = wavfile.read('D://QQPCMgr/Desktop/python3/skip.wav')
sample_number = wave.shape[0]
total_time = int(sample_number / sr * 1000)
time_series = np.linspace(0,total_time,sample_number)
fig, ax = plt.subplots(1, 1)
ax.plot(time_series, wave)
ax.set_title('Time*Amplitude')
ax.set_xlabel('Time/ms')
ax.set_ylabel('Amplitude/dB')
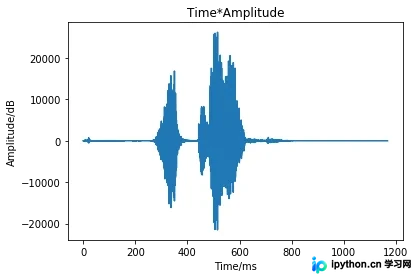
此外,借助PyAudio的API还可以实现连续录音功能:
Python实现录音功能
其中,multi_record函数在每次录音结束后会询问“是否进行下一次录音?”,按下回车键即可开始下一次录音。
import wave
import pyaudio
import matplotlib.pyplot as plt
import time

CHUNK = 1024
FORMAT = pyaudio.paInt16
CHANNELS = 2
RATE = 44100
RECORD_SECONDS = 5


def record(filename='output.wav'):
 """官方录音教程
 """

 p = pyaudio.PyAudio()

 stream = p.open(format=FORMAT,
   channels=CHANNELS,
   rate=RATE,
   input=True,
   frames_per_buffer=CHUNK)

 print("* recording")

 frames = []

 for i in range(0, int(RATE / CHUNK * RECORD_SECONDS)):
 data = stream.read(CHUNK)
 frames.append(data)

 print("* done recording")

 stream.stop_stream()
 stream.close()
 p.terminate()

 wf = wave.open(filename, 'wb')
 wf.setnchannels(CHANNELS)
 wf.setsampwidth(p.get_sample_size(FORMAT))
 wf.setframerate(RATE)
 wf.writeframes(b''.join(frames))
 wf.close()


def multi_record(num=3):
 """implement 多次录音"""
 for i in range(1,num+1):
 print('第{}次录音准备'.format(i))
 filename = 'record_{}.wav'.format(i)
 record(filename)
 time.sleep(second)
 _ = input('进行下一次录音?')


def main():
 multi_record()

if __name__ == '__main__':
 main()
总结
以上就是本文的全部内容,希望这些内容对您的学习或工作具有参考价值。如有任何疑问,欢迎留言交流,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









