

Python 3.6 字典优化:有序性与内存效率提升原理

Python 3.6 对字典进行了重大重构,使其在保持插入顺序的同时显著降低内存占用。本文深入解析了从 Python 3.5 到 3.6 字典底层数据结构的演变,对比了旧版二维数组与新版的 indices-entries 双数组机制,并解释了哈希冲突处理、内存占用从原来的 30%~95% 缩减的原因及遍历效率提升的具体实现。
Python 3.6 字典有序性与效率提升概述
在 Python 3.5(含)之前的版本中,字典并不保证键值对的插入顺序。即使先插入键值对 A,后插入键值对 B,在打印字典的 Keys 列表时,B 也可能出现在 A 之前。
然而,从 Python 3.6 开始,字典实现了有序存储。此时,先插入键值对 A,后插入键值对 B,打印 Keys 列表时,B 将严格位于 A 之后,顺序与插入顺序一致。
此外,从 Python 3.6 起,以下三种遍历操作的效率均高于 Python 3.5 之前的版本:
for key in 字典

for value in 字典.values()

for key, value in 字典.items()
在内存占用方面,从 Python 3.6 开始,字典占用的空间大小取决于键值对的数量,仅为旧版字典的 30%~95%。
Python 3.5 之前字典的底层原理
Python 3.6 究竟对字典进行了何种优化?为了解答这一问题,我们需要先回顾 Python 3.5(含)之前字典的底层实现原理。
当初始化一个空字典时,CPython 底层会初始化一个二维数组,该数组包含 8 行 3 列,如下图所示:
my_dict = {}

'''
此时的内存示意图
[[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---]]
'''
接下来,向字典中添加一个数据:
my_dict['name'] = 'kingname'

'''
此时的内存示意图
[[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[1278649844881305901, 指向name的指针, 指向kingname的指针],
[---, ---, ---],
[---, ---, ---]]
'''
这里解释一下,添加一个键值对后内存结构发生变化的原因:
首先调用 Python 的 hash 函数,计算字符串 'name' 在当前运行环境下的 hash 值:
>>> hash('name')
1278649844881305901
特别注意,这里强调了『当前运行时』。因为 Python 内置的 hash 函数与传统意义上的 Hash 函数不同,其计算结果仅保证在同一个运行周期内不变。若关闭 Python 并重新启动,该值可能会发生变化,如下图所示:
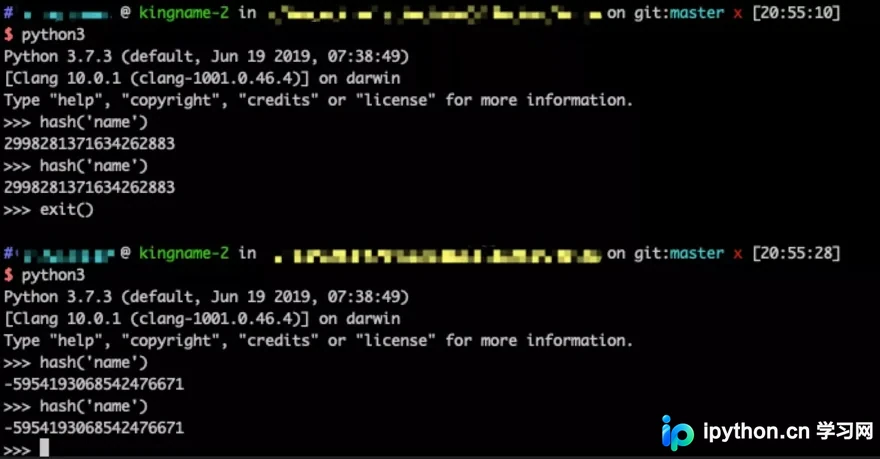
假设在某个运行周期内,hash('name') 的值为 1278649844881305901。现在将该数对 8 取余:
>>> 1278649844881305901 % 8
5
余数为 5,因此将该数据放入初始化的二维数组中下标为 5 的那一行。由于 name 和 kingname 均为字符串,底层 C 语言会使用两个字符串变量存储这两个值,并获取它们对应的指针(即内存地址)。因此,二维数组下标为 5 的这一行,第一个值为 name 的 hash 值,第二个值为 name 字符串所在内存的地址(指针),第三个值为 kingname 字符串所在内存的地址。
现在,我们再插入两个键值对:
my_dict['age'] = 26
my_dict['salary'] = 999999

'''
此时的内存示意图
[[-4234469173262486640, 指向salary的指针, 指向999999的指针],
[1545085610920597121, 执行age的指针, 指向26的指针],
[---, ---, ---],
[---, ---, ---],
[---, ---, ---],
[1278649844881305901, 指向name的指针, 指向kingname的指针],
[---, ---, ---],
[---, ---, ---]]
'''
那么字典如何读取数据呢?假设我们要读取 age 对应的值。
此时,Python 首先计算在当前运行环境下 age 对应的 Hash 值:
>>> hash('age')
1545085610920597121
余数为 1,因此二维数组中下标为 1 的那一行即为所需的键值对。直接返回该行第三个指针对应的内存中的值,即为 age 对应的值 26。
当循环遍历字典的 Key 时,Python 底层会遍历整个二维数组。如果当前行有数据,则返回 Key 指针对应的内存中的值;如果当前行没有数据,则跳过。因此,无论有效数据多少,总会遍历整个二维数组的每一行。
每一行有三列,每列占用 8 byte 的内存空间,因此每一行占用 24 byte 的内存空间。
由于 Hash 值取余数后的结果可大可小,字典的 Key 并非按照插入顺序存放。
注意,这里省略了两个与本文关系不大的细节:
- 开放寻址:当两个不同的 Key 经过 Hash 计算并对 8 取余后,余数可能相同。此时,Python 为避免覆盖已有值,会使用开放寻址技术重新寻找一个新位置来存放新的键值对。
- 当字典的键值对数量超过当前数组长度的 2/3 时,数组会进行扩容,例如从 8 行变为 16 行,再从 16 行变为 32 行。长度变化后,原有的余数位置也会发生变化,此时需要移动原有位置的数据,导致插入效率降低。
Python 3.6 字典底层数据结构优化
在 Python 3.6 之后,字典的底层数据结构发生了变化。现在,当你初始化一个空字典后,其底层结构如下:
my_dict = {}

'''
此时的内存示意图
indices = [None, None, None, None, None, None, None, None]

entries = []
'''
初始化字典后,Python 单独生成了一个长度为 8 的一维数组,同时生成一个空的二维数组。
现在,向字典中添加一个键值对:
my_dict['name'] = 'kingname'

'''
此时的内存示意图
indices = [None, 0, None, None, None, None, None, None]

entries = [[-5954193068542476671, 指向name的指针, 执行kingname的指针]]
'''
为什么内存会变成这个样子呢?我们逐步分析:
在当前运行周期中,字符串 name 的 hash 值为 -5954193068542476671,该值对 8 取余的结果为 1:
>>> hash('name')
-5954193068542476671
>>> hash('name') % 8
1
因此,我们将 indices 一维数组中下标为 1 的位置修改为 0。
这里的 0 代表什么?0 是二维数组 entries 的索引。目前 entries 中只有一行,即我们刚刚添加的键值对的三个数据:name 的 hash 值、指向 name 的指针和指向 kingname 的指针。因此,indices 中填写的数字 0,表示刚刚插入的键值对数据在二维数组中的行索引。
好,现在我们再插入两条数据:
my_dict['address'] = 'xxx'
my_dict['salary'] = 999999

'''
此时的内存示意图
indices = [1, 0, None, None, None, None, 2, None]

entries = [[-5954193068542476671, 指向name的指针, 执行kingname的指针],
     [9043074951938101872, 指向address的指针,指向xxx的指针],
     [7324055671294268046, 指向salary的指针, 指向999999的指针]
     ]
'''
现在如果我要读取数据怎么办?假设我要读取 salary 的值,首先计算 salary 的 hash 值,以及该值对 8 的余数:
>>> hash('salary')
7324055671294268046
>>> hash('salary') % 8
6
那么我就去读取 indices 下标为 6 的值,该值为 2。
然后再去读取 entries 中下标为 2 的那一行数据,即 salary 对应的数据。
新的方式在插入新数据时,始终只向 entries 的尾部添加数据,从而保证插入顺序。在遍历字典的 Keys 和 Values 时,直接遍历 entries 即可,其中每一行都是有效数据,无需跳过空行,减少了遍历次数。
旧方式下,当二维数组有 8 行时,即使有效数据只有 3 行,其占用的内存空间仍为 8 * 24 = 192 byte。而使用新方式,若只有三行有效数据,则 entries 仅占 3 行,占用空间为 3 * 24 = 72 byte。indices 作为一维数组仅占用 8 byte,总计占用 80 byte。内存占用仅为原来的 41%。
参考:[ Python-Dev] More compact dictionaries with faster iteration
总结
以上就是这篇文章的全部内容,希望本文的内容对大家的学习或工作具有一定的参考学习价值,谢谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









