


在接口开发、配置读取和数据中转场景里,JSON 看似简单,真正麻烦的是字段结构并不总是固定:有的接口会按类型切换 data 内容,有的第三方返回还会持续变动。要把这类数据处理好,关键不只是“能解析出来”,而是根据结构稳定性、性能成本和可维护性,选对解析方式。
这篇文章就沿着实际开发最常见的几种路径来拆解:先看基础动态解析,再看 json.RawMessage 和反射适合解决什么问题,最后落到 Go 1.18 之后很值得在接口层使用的泛型方案。读完之后,你可以更清楚地判断:什么时候该上结构体,什么时候该延迟解析,什么时候该用泛型把重复代码收住。
为什么需要动态解析 JSON
在 Go 里,最常见的做法是先定义结构体,再把 JSON 反序列化进去。只要字段和类型相对稳定,这种方式通常就是首选:代码清晰、类型安全、性能也更好。
但现实项目里,总会遇到一些结构不固定的输入,比如:
- 第三方 API 返回的数据结构可能随时调整;
- 同一个服务需要处理多个来源的异构数据;
- 需要构建通用数据转换工具、消息中转层或 API 网关;
- 接口外层格式一致,但内部
data字段会随着业务类型变化。
这时,提前把所有字段都写死在结构体里,往往既不现实,也不够灵活。动态解析的意义就在这里:先把不确定的数据接住,再按需要逐步提取、判断和转成明确类型。
基础动态解析方法怎么选
动态 JSON 的核心问题不是“能不能解”,而是“解出来之后怎么用”。不同方法的主要差别,体现在灵活性、类型安全和后续访问成本上。
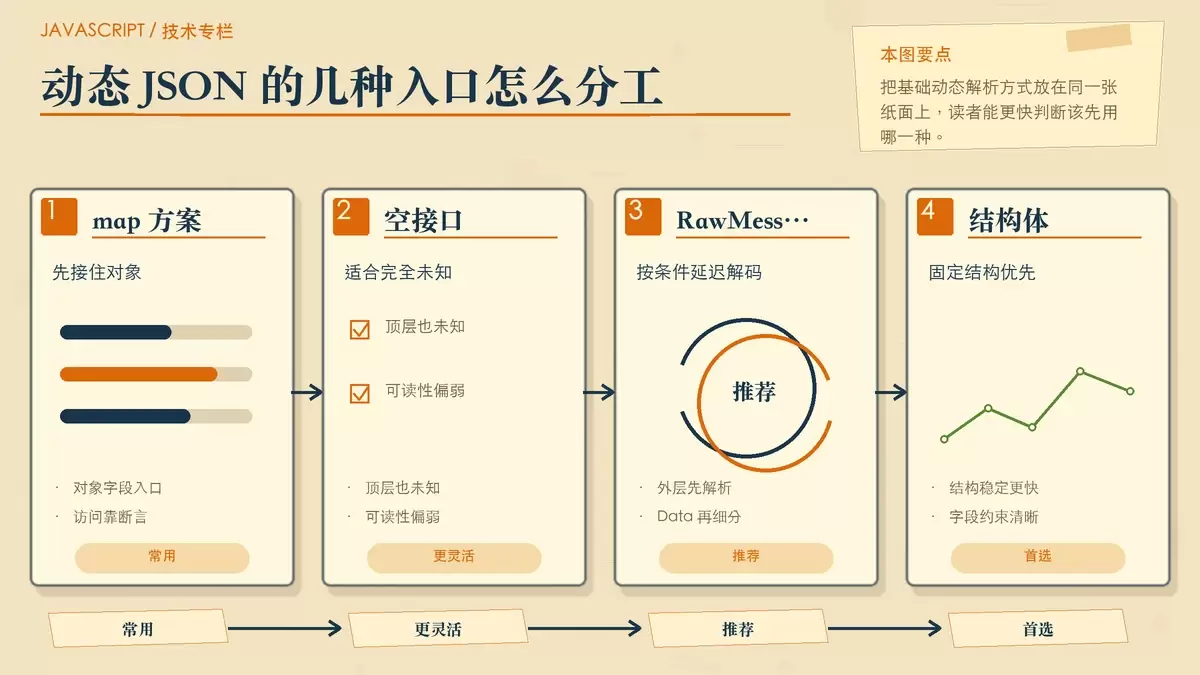
使用 map[string]interface{}:最常见的兜底方案
如果 JSON 对象整体上就是一个键值结构,而你又无法提前定义完整字段,map[string]interface{} 是最基础也最常见的办法。
func main() {
    jsonData := `{
        "name": "John",
        "age": 30,
        "address": {
            "city": "New York",
            "zip": "10001"
        }
    }`

    var result map[string]interface{}
    err := json.Unmarshal([]byte(jsonData), &result)
    if err != nil {
        fmt.Println("Error decoding JSON:", err)
        return
    }

    fmt.Println("Name:", result["name"])
    if address, ok := result["address"].(map[string]interface{}); ok {
        fmt.Println("City:", address["city"])
    }
}
它的优点很直接:不需要预定义结构体,任何对象字段都能先装进去。对于做中间层透传、字段探测、临时调试时,这种方式非常方便。
问题也很明显。你在访问每一层字段时,几乎都要写类型断言;一旦 JSON 嵌套层级变深,代码很快就会变长,而且容易因为断言失败产生隐藏问题。换句话说,它适合“先接住数据”,不适合长期承担复杂业务逻辑。
使用 interface{}:结构完全未知时再考虑
如果连顶层结构都不确定,只知道拿到的是一段合法 JSON,那么也可以直接反序列化到 interface{}。
func main() {
    jsonData := `{
        "id": 12345,
        "data": {
            "key1": "value1",
            "key2": [1, 2, 3],
            "key3": {
                "subkey": "subvalue"
            }
        }
    }`

    var result interface{}
    err := json.Unmarshal([]byte(jsonData), &result)
    if err != nil {
        fmt.Println("Error decoding JSON:", err)
        return
    }

    // 使用类型断言访问数据
    if data, ok := result.(map[string]interface{}); ok {
        fmt.Println("ID:", data["id"])
        if nestedData, ok := data["data"].(map[string]interface{}); ok {
            fmt.Println("Key1:", nestedData["key1"])
            if key2, ok := nestedData["key2"].([]interface{}); ok {
                fmt.Println("Key2:", key2)
            }
        }
    }
}
这种写法的灵活度比 map[string]interface{} 更高,但代价是可读性进一步下降。因为你不仅要判断字段值是什么类型,还要先判断当前节点本身到底是对象、数组,还是其他值。
所以在实践里,这种方式更适合做通用解析入口,或者处理“来源完全不可控”的数据。只要你的 JSON 至少能确定顶层是对象,通常还是直接用 map[string]interface{} 更省事。
使用 json.RawMessage:把解析时机往后放
很多接口并不是整个结构都动态,真正变化的往往只有其中一部分。比如外层的 type、code、message 是固定的,只有 data 会根据业务类型不同而切换内容。这时,json.RawMessage 往往比直接上 map 更合适。
func main() {
    jsonData := `{
        "type": "person",
        "data": {
            "name": "Alice",
            "age": 25
        }
    }`

    type Message struct {
        Type string          `json:"type"`
        Data json.RawMessage `json:"data"`
    }

    var msg Message
    err := json.Unmarshal([]byte(jsonData), &msg)
    if err != nil {
        fmt.Println("Error decoding JSON:", err)
        return
    }

    fmt.Println("Type:", msg.Type)

    // 根据类型进一步解析Data
    if msg.Type == "person" {
        var person struct {
            Name string `json:"name"`
            Age  int    `json:"age"`
        }
        err := json.Unmarshal(msg.Data, &person)
        if err != nil {
            fmt.Println("Error decoding data:", err)
            return
        }
        fmt.Println("Name:", person.Name)
        fmt.Println("Age:", person.Age)
    }
}
json.RawMessage 的核心价值在于“延迟解析”。先把原始字节保留下来,等确认类型、路由条件或业务分支后,再决定要把它解到哪个结构体里。
这种方式有两个明显好处:
- 不必为了少量动态字段,把整个响应都改成弱类型;
- 能避免对暂时用不到的部分做无意义解析,尤其适合较大的 JSON 数据。
如果你的接口外层结构稳定、内层按类型分支,json.RawMessage 往往是从“纯动态”过渡到“半结构化”的第一步。
反射适合解决什么问题
当你需要更深层地遍历未知 JSON 结构,或者想写一个可以递归处理不同字段类型的通用工具时,reflect 包提供了运行时检查类型的能力。
func processJSON(data map[string]interface{}) {
    for key, value := range data {
        v := reflect.ValueOf(value)
        switch v.Kind() {
        case reflect.String:
            fmt.Printf("%s: %s (string)n", key, v.String())
        case reflect.Float64:
            fmt.Printf("%s: %f (number)n", key, v.Float())
        case reflect.Bool:
            fmt.Printf("%s: %t (bool)n", key, v.Bool())
        case reflect.Map:
            fmt.Printf("%s: (map)n", key)
            if nestedMap, ok := value.(map[string]interface{}); ok {
                processJSON(nestedMap)
            }
        case reflect.Slice:
            fmt.Printf("%s: (slice)n", key)
            for i := 0; i < v.Len(); i++ {
                fmt.Printf("  [%d]: %vn", i, v.Index(i).Interface())
            }
        default:
            fmt.Printf("%s: %v (unknown type)n", key, v.Interface())
        }
    }
}

func main() {
    jsonData := `{
        "name": "Frank",
        "age": 50,
        "extra": {
            "hobby": "golf",
            "scores": [95, 88, 92]
        }
    }`

    var result map[string]interface{}
    err := json.Unmarshal([]byte(jsonData), &result)
    if err != nil {
        fmt.Println("Error decoding JSON:", err)
        return
    }

    processJSON(result)
}
这类代码适合放在数据探测、字段遍历、通用转换器、调试工具里。它的优势不是让业务代码更简洁,而是让“未知结构的处理逻辑”变得可编排。
但反射不是没有代价。它会引入额外性能开销,也会让代码的理解门槛上升。对于普通接口解析,如果结构其实已经相对明确,直接定义结构体或者用 json.RawMessage 通常更稳。反射更像是一种进阶能力,适合真正需要通用性的时候再拿出来用。
泛型如何把接口解析写得更稳
Go 1.18 引入泛型之后,接口开发里有一类很常见的问题终于有了更自然的写法:多个接口的外层响应结构相同,但 data 字段内容不同。
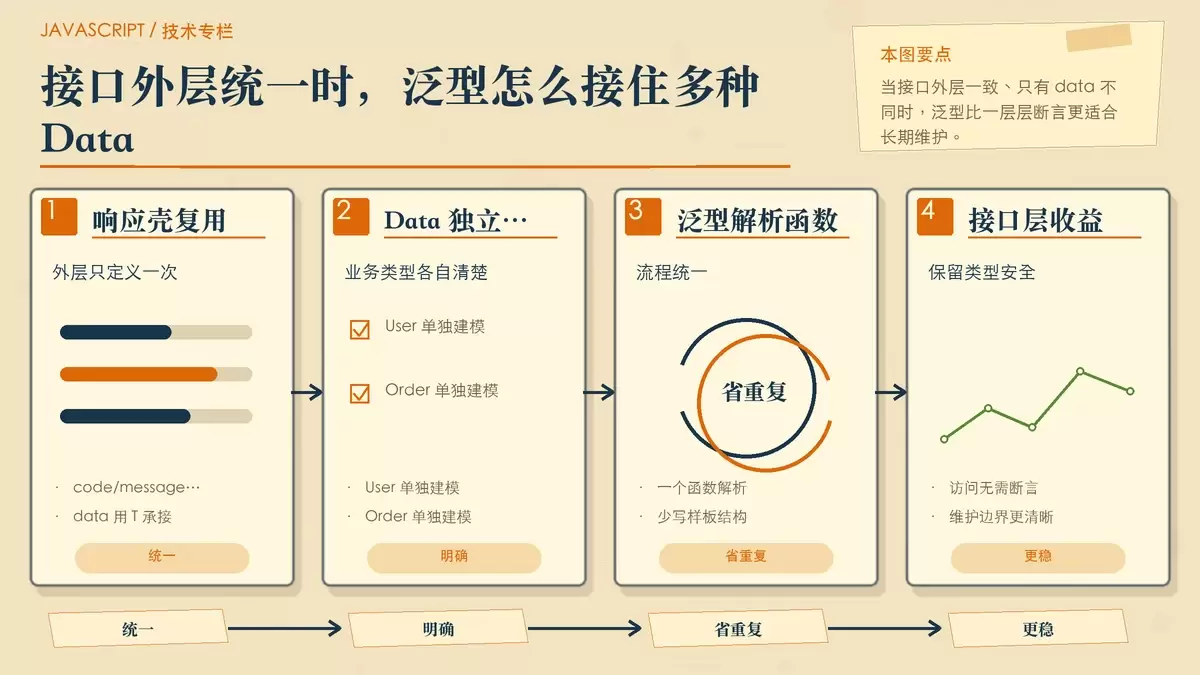
例如,很多服务会统一返回这样的结构:
code:状态码message:提示信息data:真正业务数据
如果没有泛型,常见做法通常是:
- 为每种响应单独写一套结构体;
- 把
data写成interface{}或map[string]interface{},再二次断言。
前者重复代码多,后者又失去类型安全。泛型正好能把这两个问题一起处理掉。
// 定义通用响应接口
type ApiResponse[T any] struct {
    Code    int    `json:"code"`
    Message string `json:"message"`
    Data    T      `json:"data"`
}

// 用户数据模型
type User struct {
    ID       int    `json:"id"`
    Name     string `json:"name"`
    Email    string `json:"email"`
}

// 订单数据模型
type Order struct {
    OrderID    int     `json:"order_id"`
    Amount     float64 `json:"amount"`
    Status     string  `json:"status"`
}

// 泛型函数处理API响应
func ParseResponse[T any](jsonData []byte) (*ApiResponse[T], error) {
    var response ApiResponse[T]
    err := json.Unmarshal(jsonData, &response)
    if err != nil {
        return nil, err
    }
    return &response, nil
}

func main() {
    // 模拟用户接口返回
    userJson := `{
        "code": 200,
        "message": "success",
        "data": {
            "id": 123,
            "name": "John Doe",
            "email": "john@example.com"
        }
    }`

    // 模拟订单接口返回
    orderJson := `{
        "code": 200,
        "message": "success",
        "data": {
            "order_id": 456,
            "amount": 99.99,
            "status": "completed"
        }
    }`

    // 解析用户响应
    userResponse, err := ParseResponse[User]([]byte(userJson))
    if err != nil {
        fmt.Println("Error parsing user response:", err)
        return
    }
    fmt.Printf("User: %+vn", userResponse.Data)

    // 解析订单响应
    orderResponse, err := ParseResponse[Order]([]byte(orderJson))
    if err != nil {
        fmt.Println("Error parsing order response:", err)
        return
    }
    fmt.Printf("Order: %+vn", orderResponse.Data)
}
这个方案的关键点在于:把稳定的外层结构抽象成 ApiResponse[T any],把变化的部分交给类型参数 T。这样一来,调用方在解析时就能明确指定 User、Order 或其他业务类型。
它带来的收益主要有三点:
- 保留类型安全,字段访问不再依赖断言;
- 统一了解析流程,避免为相同外壳重复写样板代码;
- 让接口层模型更清晰,后续维护时更容易定位字段归属。
当然,泛型也不是替代一切动态解析的银弹。只有当“外层结构统一、内部类型可枚举”时,它才最有价值。如果连 data 的形态都完全不可预测,那还是要回到 RawMessage、map 或反射这一类方案。
性能取舍与实践建议
处理动态 JSON 时,真正应该权衡的通常是三件事:结构是否稳定、运行时成本是否敏感、代码要不要长期维护。结合前面的几种方法,可以归纳出几条比较实用的经验。
固定结构优先用结构体
只要字段基本稳定,就尽量直接定义结构体。相比 map[string]interface{},结构体解析更快、内存开销更低,业务代码也更容易读。
大型数据考虑流式处理
如果面对的是体积较大的 JSON 数据,不一定要一次性全部加载到内存里。可以考虑使用 json.Decoder 做流式处理,这在日志、批量数据导入或长响应体读取里会更实用。
复杂动态场景可以评估第三方库
当你需要频繁读取深层字段、做结构映射或增强动态访问能力时,可以评估像 gjson、mapstructure 这样的第三方库。它们通常会提供更高效或者更顺手的 API,但也意味着额外依赖,需要结合团队习惯和维护成本来判断。
反射要控制频率,必要时缓存结果
如果项目里确实要用反射处理动态 JSON,尽量避免在高频路径里重复做同样的类型分析。对于可复用的反射结果,可以考虑做缓存,减少重复计算带来的成本。
多态接口优先考虑泛型复用
如果多个接口只是 data 不同,而外层响应结构保持一致,那么泛型基本就是更合适的选择。它在灵活性和可维护性之间做了一个比较好的平衡,尤其适合中后台服务、SDK 封装和统一 API 响应解析。
怎么做技术选型更合适
Go 里的动态 JSON 处理,没有单一标准答案,关键在于数据到底“动态到什么程度”。
如果结构固定,优先使用结构体;如果只有局部字段变化,优先考虑 json.RawMessage;如果需要通用遍历未知结构,可以使用 map[string]interface{}、interface{} 或反射;如果接口外层统一、只是 data 类型不同,那么 Go 1.18 之后的泛型方案通常会更优雅。
从接口开发的角度看,泛型最大的价值不在“支持动态”,而在于它让“有边界的动态”重新回到类型安全的轨道上。真正实用的最佳实践,往往不是一味追求最灵活,而是先判断哪些部分稳定、哪些部分变化,再把动态能力只放在确实需要的地方。









