


看起来只是一个简单的结构体嵌入问题,真正麻烦的地方在于:encoding/json 遇到同名字段时,并不会按很多人直觉中的“都赋值”或“直接报错”来处理。要避免这种线上排查起来很费劲的静默丢数据,关键是先分清它到底属于外层遮蔽,还是同级冲突,再决定该调整结构还是自己接管反序列化。
一道很容易答错的 Go 题:为什么没有报错却没解析进去?
先看题目本身:
type B struct { Name string `json:"name"` }
type C struct { Name string `json:"name"` }
type A struct { B; C }

// 问:解析 `{"name":"Tom"}` 到结构体 A 会发生什么?
很多人的第一反应通常有两种:要么觉得这会直接出错,要么认为 A.B.Name 和 A.C.Name 都会拿到 "Tom"。
但实际结果都不是。代码可以正常运行,json.Unmarshal 也不会返回错误,可最后 Name 既没有写进 B,也没有写进 C,两个字段都还是空字符串 ""。
这类行为危险的地方就在这里:程序表面一切正常,但数据已经被悄悄丢掉了。面试里它是考点,在线上聚合接口、透传第三方响应时,它就可能变成很难察觉的 bug。
两类最常见的同名字段冲突
Go 的匿名嵌入会把字段“打平”到外层使用,这在建模时很方便。但一旦和 encoding/json 结合,同名字段会出现两种完全不同的结果。
外层自己也有同名字段:外层优先
第一种情况相对符合直觉:外层结构体自己就声明了同名字段。
type B struct { ID string `json:"id"` }
type C struct { ID string `json:"id"` }

type A struct {
    B
    C
    ID string `json:"id"` // 外层 A 自己也有 ID
}
如果解析下面这段 JSON:
var a A
_ = json.Unmarshal([]byte(`{"id":"A-1001"}`), &a)
// 结果:a.ID 是 "A-1001",而 a.B.ID 和 a.C.ID 都是 ""
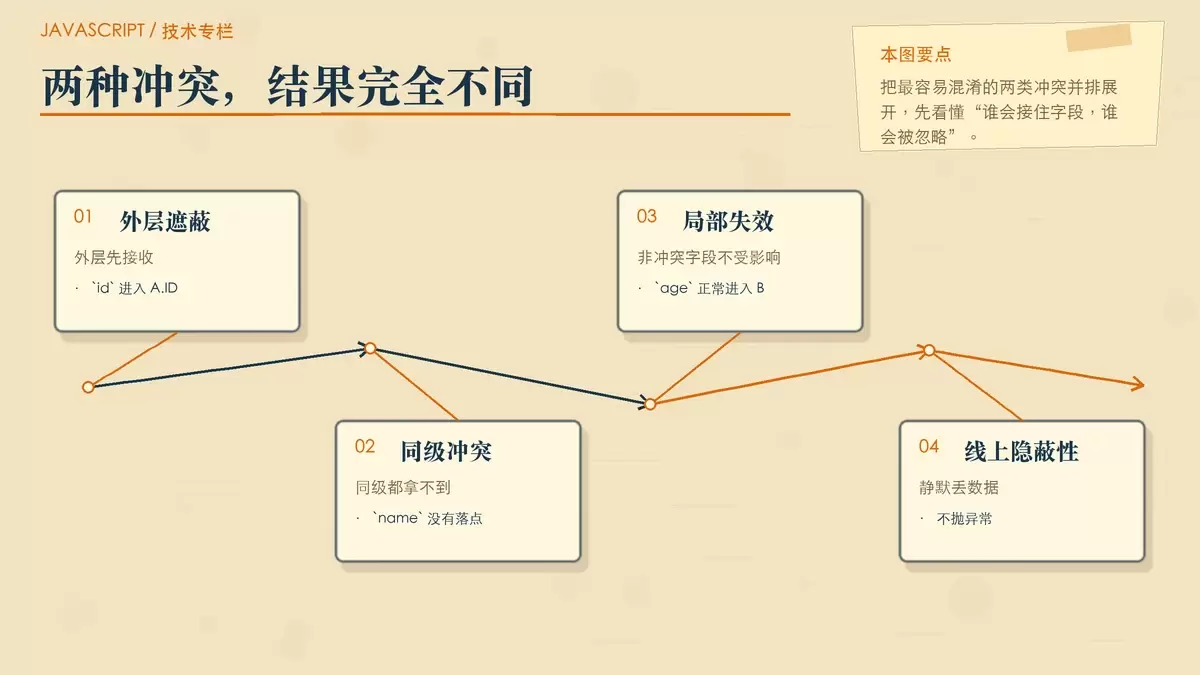
这里的行为是明确的:值会进入 A.ID,不会再分发给内层字段。也就是说,只要外层存在同名映射,内层同名字段就会被遮蔽。
这可以理解为一条很稳定的规则:外层字段优先级更高。对于阅读代码的人来说,这种结果通常是能预期到的。
只有内层同名:同级冲突时谁都拿不到
真正容易误判的是第二种,也就是开头那道题代表的场景:外层没有字段,只有两个被匿名嵌入的内层结构体都声明了同一个 JSON Tag。
type B struct {
    Name string `json:"name"`
    Age  int    `json:"age"`
}
type C struct {
    Name   string `json:"name"`
    Gender string `json:"gender"`
}
type A struct { B; C }
传入的数据如果是:
var a A
_ = json.Unmarshal(jsonData, &a)
// 结果:a.Age 顺利拿到 30,a.Gender 拿到 "male"
// 但 a.B.Name 和 a.C.Name 都是 ""!
这里最值得注意的是,其他不冲突的字段依然可以正常解析,比如 age 会进入 B.Age,gender 会进入 C.Gender。只有冲突的 name 被直接忽略。
从语言层面看,这种歧义其实早有信号。你如果直接写 a.Name,Go 编译器就会因为不知道该指向 B.Name 还是 C.Name 而报错。到了 JSON 反序列化阶段,标准库采取的策略也很干脆:既然同级字段都能匹配,而且没有更高优先级的一方,那就谁都不给。
标准库为什么会静默忽略这个字段?
要理解这个现象,关键要看 encoding/json 在构建字段映射关系时的处理方式。根据标准库源码中 src/encoding/json/encode.go 里的 typeFields 函数,解析器会按嵌套层级逐层扫描结构体字段,本质上采用的是广度优先遍历的思路。
在这个过程中,同名字段并不是简单地“后者覆盖前者”,而是要套用一套支配规则。对日常开发最有用的可以概括成两条。
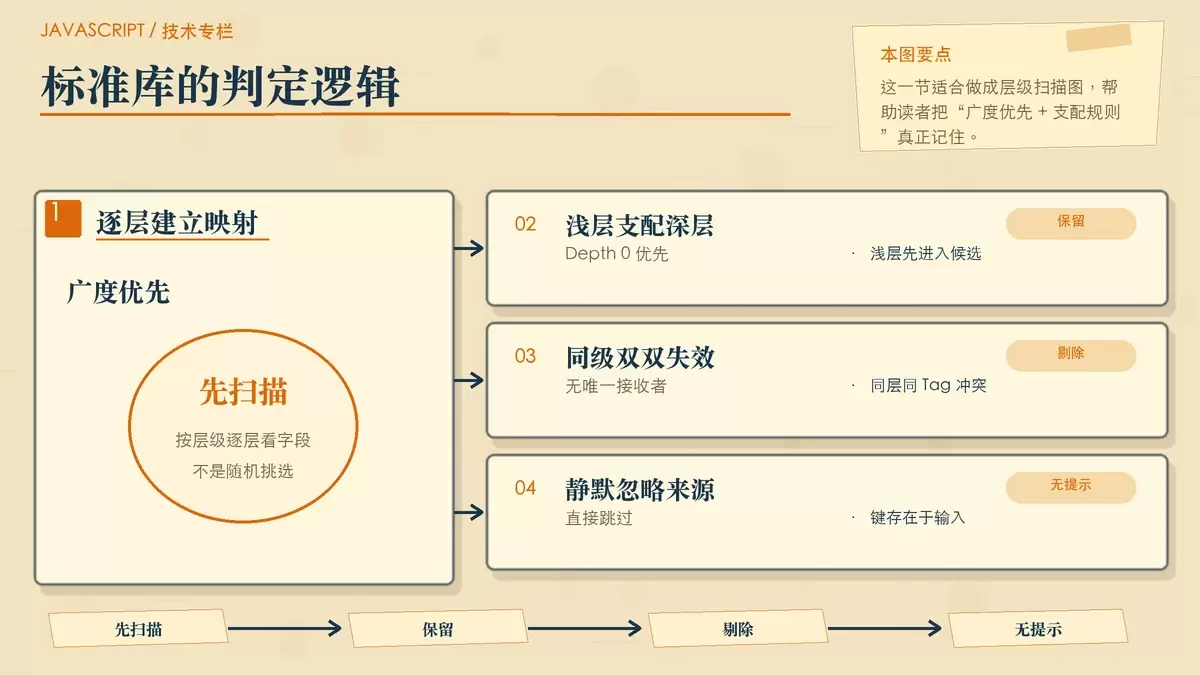
规则一:同层级、同名字、无支配者,直接剔除
如果同一个 JSON Tag 同时出现在相同深度,例如 B.Name 和 C.Name 都处在 Depth 1,解析器不会随便挑一个作为接收目标。
它的做法是把这两个候选都视为“无法判定谁更优先”,然后在最终字段映射表里把它们一起排除。结果就是,JSON 里的 "name" 虽然存在,但映射表中根本没有合法落点,于是这个键会被静默跳过。
规则二:更浅层字段可以支配更深层字段
如果同名字段出现在不同深度,浅层字段优先级更高。像下面这种情况:
A.ID 在 Depth 0,而 B.ID、C.ID 在 Depth 1。
由于外层更浅,扫描时也更早进入有效候选,最终 A.ID 会支配内层同名字段,内层映射不会再生效。这也就解释了为什么前一个例子里 {"id":"A-1001"} 只会写入 A.ID。
所以这类问题的核心判断可以收束为一句话:浅层优先;同层冲突则忽略。
遇到冲突时,三种更稳妥的处理办法
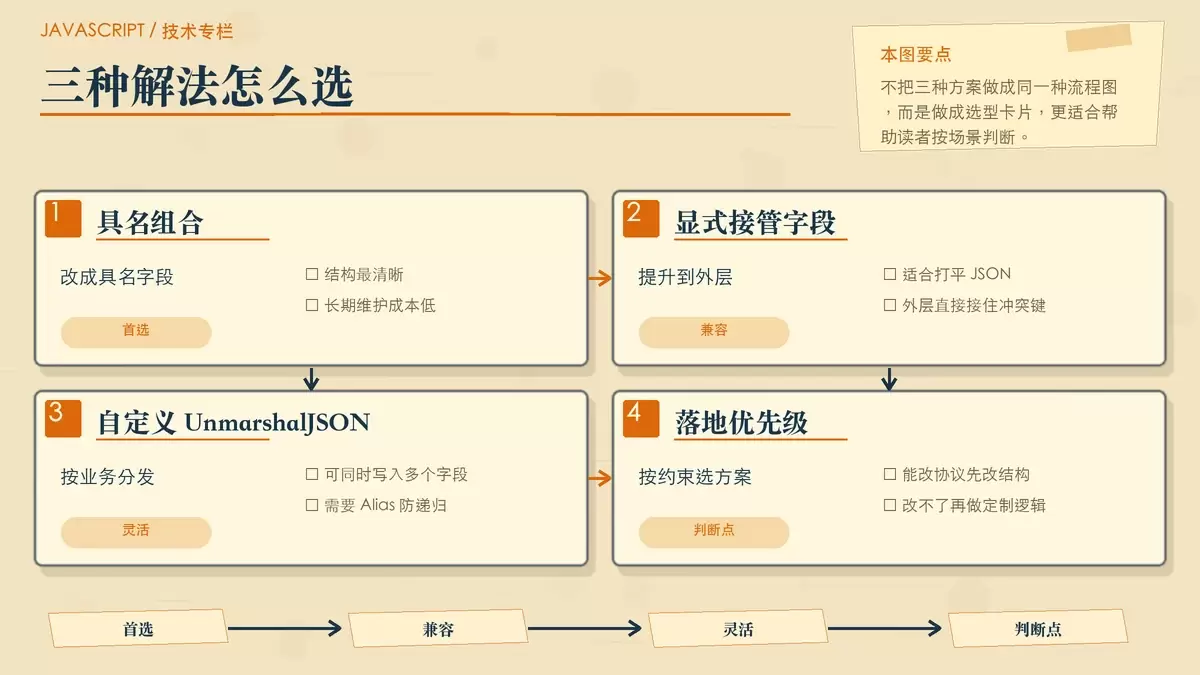
知道规则之后,真正重要的是怎么落地。实际开发里,如果你已经确认 JSON 输入可能触发这类冲突,通常有三种处理方式。
1. 放弃匿名嵌入,改成具名组合
这是最稳的一种,也是最推荐的方案。直接给内层结构体一个明确字段名,让 JSON 结构和 Go 结构都不再依赖“打平后的隐式规则”。
type A struct {
    BInfo B `json:"b_info"`
    CInfo C `json:"c_info"`
}
这种写法的好处很直接:字段归属清晰,后续维护时不需要再靠读者脑补匿名嵌入的优先级,也不会因为未来给 B 或 C 多加一个字段就引入新的冲突。
如果你能控制接口格式,优先考虑这种方案,长期成本最低。
2. 在外层显式声明字段,接管映射
如果输入 JSON 本身就是打平结构,短期内又不方便改协议,可以在外层显式增加一个字段,把冲突键先接住。
type A struct {
    B
    C
    Name string `json:"name"` // 显式接管 name 映射
}这样一来,Name 被提升到最外层,优先级高于 B.Name 和 C.Name,原先 Depth 1 的同级冲突就不成立了。反序列化后直接读取 a.Name 即可。
这种方式适合“外层确实应该拥有这个字段”的场景。如果只是为了兼容而临时接管,也要确认语义上不会让结构体职责变得混乱。
3. 自定义 UnmarshalJSON,按业务规则分发
还有一种情况是,业务上确实希望同一个输入值最终写入多个字段,例如 name 既要给 B.Name,也要给 C.Name。这种需求标准库不会帮你完成,就需要自己实现 json.Unmarshaler。
一个常见写法如下:
func (a *A) UnmarshalJSON(data []byte) error {
    type Alias A // 避免死循环
    aux := struct {
        *Alias
        Name string `json:"name"`
    }{ Alias: (*Alias)(a) }

    if err := json.Unmarshal(data, &aux); err != nil {
        return err
    }
    a.B.Name = aux.Name
    a.C.Name = aux.Name
    return nil
}
这里的关键点不是“多写一层结构体”,而是用 type Alias A 避开递归调用自身 UnmarshalJSON 导致的死循环。先把冲突字段从外层临时接住,再按你的业务规则分发给内部字段。
这种方式最灵活,尤其适合对接第三方 API、历史包袱较重、短期内无法调整数据结构的系统。但代价也很明显:代码复杂度更高,后续维护者必须知道你在这里覆盖了标准库默认行为。
实战里怎么选,结论可以记成一句话
Go 的匿名嵌入本身没有问题,问题出在很多人会把“字段打平”误解为“JSON 也一定会自动帮我选中正确字段”。encoding/json 的实际策略并不是模糊匹配,而是按层级和支配关系严格决策。
只要记住下面这条判断,遇到类似问题时基本就不会再猜错:
外层有同名字段时,优先用外层;只有同级内层冲突时,标准库会直接忽略这个键。
工程实践里,优先级也很明确:能改结构就用具名组合;需要兼容打平 JSON 时,用外层字段显式接管;必须做定制分发时,再实现 UnmarshalJSON。这样既能避开静默丢数据,也更方便团队在后续维护中快速定位问题。









