


在 Go 开发里,字符串遍历看似基础,真正踩坑时却常常出现在中文、日文这类多字节字符上:同一个字符串,`range` 输出正常,`len` 配合索引却像“坏掉了一样”。要看懂这个现象,关键不是记住“遍历时用 `range`”,而是先分清 Go 的字符串到底存的是什么、`len()` 算的又是什么。
下面就从一个最常见的示例出发,拆开说明字节、字符、UTF-8 和 `rune` 之间的关系,再给出实际开发里更稳妥的处理方式。读完之后,你可以快速判断一段代码是在按字节工作,还是在按字符工作,也更容易避开中文字符串处理时的常见误区。
为什么同一个字符串会出现两种输出结果
先看一段典型代码:
package main

import "fmt"

func main() {
    str := "hello世界"

    // 使用普通for循环遍历
    fmt.Println("使用普通for循环遍历:")
    for i := 0; i < len(str); i++ {
        fmt.Printf("%c", str[i])
    }

    fmt.Println("n使用range遍历:")
    // 使用range遍历
    for _, char := range str {
        fmt.Printf("%c", char)
    }
}
运行结果如下:
使用普通for循环遍历:
helloä¸ç
使用range遍历:
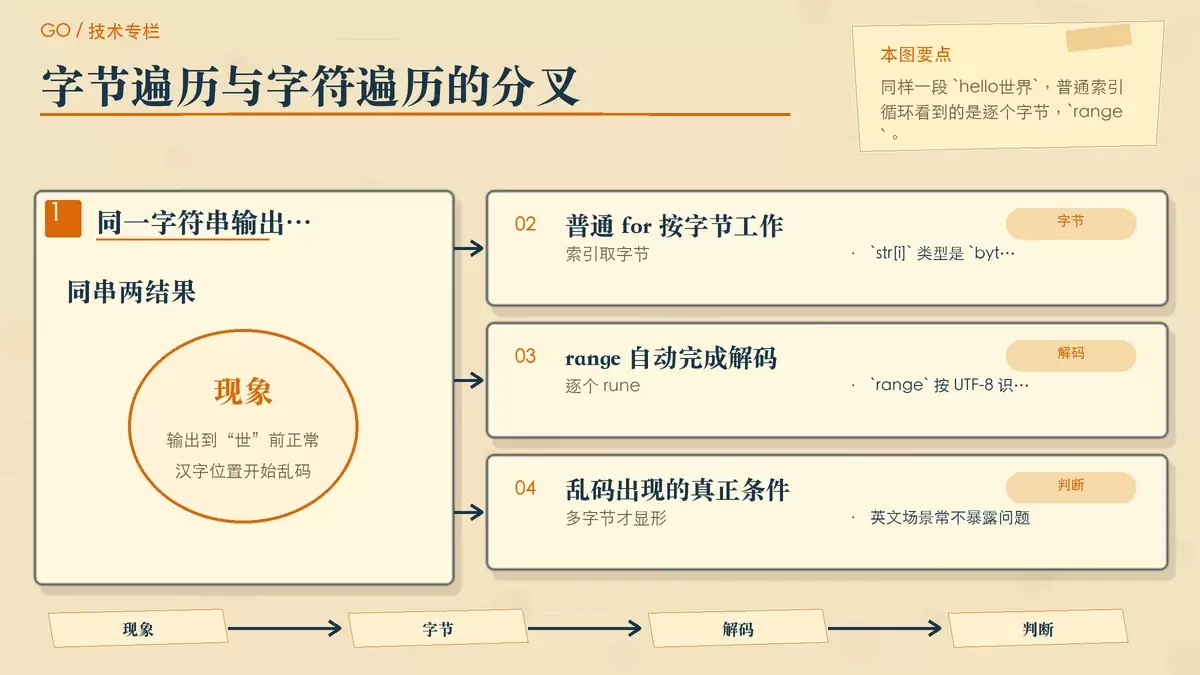
hello世界表面上看,两段代码都是“逐个打印字符串内容”;但实际上,它们拿到的数据根本不是同一种东西。前者取的是单个字节,后者取的是解码后的 Unicode 字符,所以一旦字符串里混入汉字,差异就会立刻暴露出来。
Go 字符串的本质:只读字节序列
要理解这个问题,先要抓住 Go 对 `string` 的定义:字符串本质上是只读的字节序列,可以把它理解成一个不能直接修改的 `[]byte` 视图。
当我们写下字符串字面量时,Go 会按 UTF-8 编码把内容保存下来。UTF-8 是一种变长编码,因此不同字符占用的字节数并不一样:
- ASCII 字符,例如英文字母和数字,通常占用 1 个字节
- 大部分常用汉字,通常占用 3 个字节
- 其他字符可能占用 2 到 4 个字节
以 `"世界"` 为例,它在 UTF-8 下分别对应:
- `"世"`:`0xE4 0xB8 0x96`
- `"界"`:`0xE7 0x95 0x8C`
也就是说,虽然我们肉眼看到的是 2 个汉字,但底层实际存的是 6 个字节。后面所有“为什么会乱码”的问题,基本都由这个事实引出。
`len()` 和 `range` 到底各自在处理什么
`len()` 统计的是字节数,不是字符数
对字符串调用 `len(str)` 时,返回值表示这段字符串占了多少字节。
比如 `"hello世界"`:
- `"hello"` 有 5 个英文字母,共 5 字节
- `"世界"` 有 2 个汉字,共 6 字节
- 总长度是 `5 + 6 = 11` 字节
因此,`len("hello世界")` 的结果是 `11`,而不是我们直觉里的 7 个“字符”。
基于索引的 `for` 循环是按字节取值
for i := 0; i < len(str); i++ {
    fmt.Printf("%c", str[i])
}
这里的 `str[i]` 取出的不是“第 i 个字符”,而是第 `i` 个字节,类型是 `byte`,也就是 `uint8`。
这对纯英文字符串通常没问题,因为一个英文字符正好就是一个字节。但到了汉字这里,一个字符由多个字节组成,循环会把这些字节拆开分别打印。单独拿出 `0xE4`、`0xB8`、`0x96` 这样的值去按 `%c` 输出,自然不可能还原成完整的 `世`,于是就出现了乱码。
`range` 遍历时会自动按 UTF-8 解码
for _, char := range str {
    fmt.Printf("%c", char)
}
`range` 遍历字符串时,Go 会按 UTF-8 规则自动解码,每一轮拿到的是一个完整字符,类型是 `rune`,也就是 `int32`。
这意味着它不是简单地“取下一个字节”,而是会先判断当前字节属于单字节字符,还是某个多字节字符的起始字节,再把相关字节组合起来,解出一个完整的 Unicode 码点。所以面对 `hello世界` 这样的内容时,`range` 才能正确输出汉字。
真正需要分清的是 `byte` 和 `rune`
很多 Go 初学者把这个问题理解成“`range` 比 `for` 更高级”,其实不够准确。更关键的是区分 `byte` 和 `rune` 这两类值。
`byte` 适合表示原始字节
- `byte` 是 `uint8` 的别名
- 它表示的是一个字节
- 适合处理二进制数据、ASCII 文本、编码内容本身
`rune` 适合表示字符语义
- `rune` 是 `int32` 的别名
- 它代表一个 Unicode 码点
- 适合处理中文、日文以及其他多字节字符
看下面这个示例会更直观:
// 示例:查看字符类型
var a byte = 'A'
var b rune = '你'
fmt.Printf("a的类型:%T,b的类型:%Tn", a, b)
// 输出:a的类型:uint8,b的类型:int32
也可以这样理解:当你的目标是“操作存储后的内容”,你通常在处理 `byte`;当你的目标是“操作用户看到的字符”,你通常应该转向 `rune` 或直接使用 `range`。
实际开发中该怎么正确处理字符串
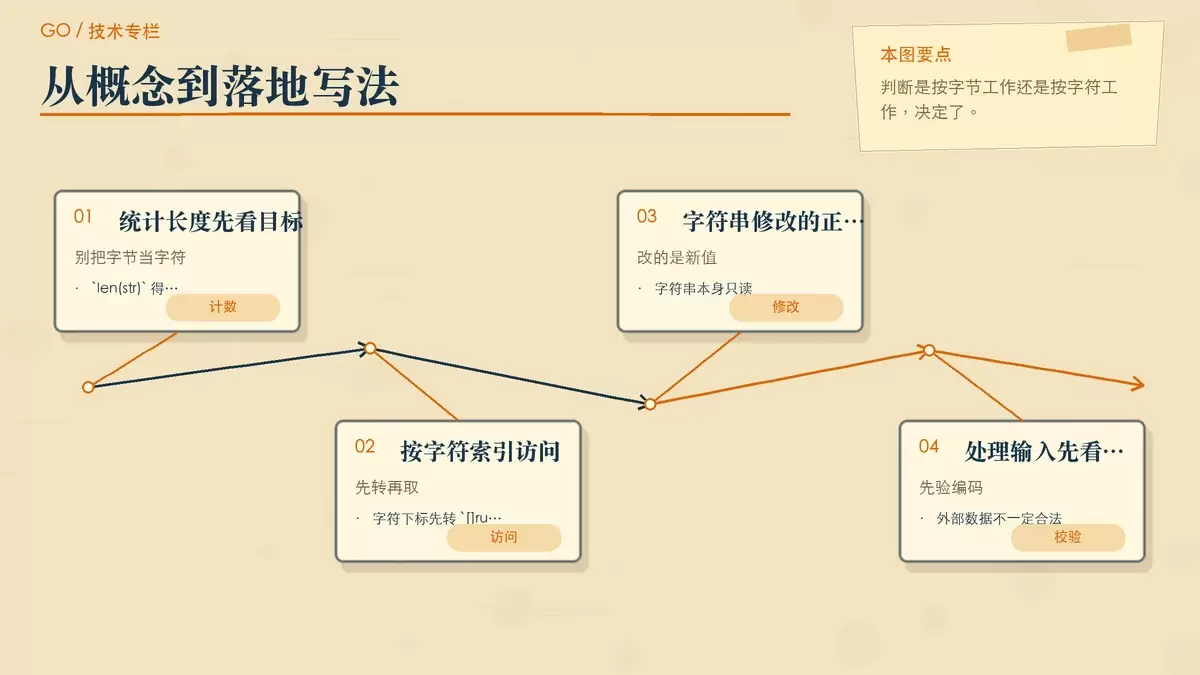
1. 统计字符数时,不要直接用 `len()`
如果你的业务语义是“字符串里有多少个字符”,那么 `len()` 往往不准确,它给出的只是字节数。
str := "hello世界"
// 错误方式:返回字节数
byteLen := len(str) // 结果为11

// 正确方式:返回字符数
charLen := utf8.RuneCountInString(str) // 结果为7
// 或者
charLen := len([]rune(str)) // 结果为7
这两种写法都能得到字符数。前者语义更直接,后者在你后续还要做字符级访问时也很常见。
2. 需要按字符索引时,先转成 `[]rune`
Go 字符串本身不支持真正意义上的“按字符下标访问”。如果你确实要取“第 3 个字符”“最后一个汉字”,可以先转成 `rune` 切片:
str := "hello世界"
runes := []rune(str)

// 现在可以按字符索引访问
fmt.Printf("第一个字符:%cn", runes[0]) // h
fmt.Printf("最后一个字符:%cn", runes[6]) // 界
需要注意的是,`[]rune(str)` 会重新分配内存。对于短字符串,这个成本通常可以接受;但如果你在热点路径里频繁处理大文本,就要考虑额外的性能和内存开销。
3. 修改字符串时,本质上是在创建新值
Go 的字符串是只读的,不能像切片那样直接改某个位置。遇到替换字符的场景,常见做法也是先转成 `[]rune`,修改后再转回字符串:
str := "白猫"
runes := []rune(str)
runes[0] = '黑'
newStr := string(runes) // "黑猫"
这类写法对于中文字符串尤其重要,因为如果直接按字节修改,很容易把 UTF-8 编码拆坏,得到无效字符串。
4. 处理外部输入时,先确认编码有效
并不是所有来源的数据都一定是合法 UTF-8。尤其是文件、网络请求、数据库历史数据混合在一起时,字符串内容可能已经损坏,或者根本不是 UTF-8。
这时可以用标准库做一次校验:
utf8.ValidString()当程序逻辑依赖字符级遍历、截断、计数时,这一步能帮你提前发现问题,避免后续处理结果异常。
为什么 Go 默认选择 UTF-8
理解了上面的差异,再回头看 Go 为什么把字符串建立在 UTF-8 之上,这个选择其实很务实。
- 兼容 ASCII:英文和数字场景下几乎没有额外负担
- 空间效率较好:大量源代码、协议文本、配置文件本来就以 ASCII 为主
- 跨平台支持广:现代操作系统、编辑器、数据库和编程语言对 UTF-8 的支持都很成熟
- 具备自同步性:解码器可以从字节流中识别字符边界,适合流式处理
也正因为 UTF-8 是变长编码,Go 才会同时保留“按字节处理”的高效率能力,以及“按字符处理”的正确语义。开发者需要做的,就是根据场景选对工具。
结论:遇到中文字符串时,先判断你要的是字节还是字符
`range` 能正确打印汉字,而 `len` 配合索引遍历会出现乱码,根本原因可以归纳为三点:
- Go 的 `string` 存的是 UTF-8 编码后的字节序列
- `len()` 返回的是字节数,不是字符数
- 普通 `for` 循环按字节取值,`range` 会按 UTF-8 解码后返回字符
所以,处理网络协议、文件格式、二进制内容时,按字节操作完全合理;但只要你的业务语义是“字符”“文本展示”“中文截断”“多语言输入”,就应该优先使用 `range`、`rune` 或 UTF-8 相关工具函数。把这条边界分清,Go 字符串处理里的很多坑其实都能提前避开。









