

Python机器视觉自动识别验证码实战:从预处理到近邻分类

本文详解如何使用Python结合机器视觉技术自动识别简单验证码。通过抓取图像、灰度二值化预处理、特征值提取,并构建基于近邻分类(NNC)的轻量级模型,仅需少量样本即可实现高准确率识别。
前言与背景
前言
CAPTCHA的全称为Completely Automated Public Turing Test to Tell Computers and Humans Apart,即全自动区分人机的图灵测试,这也是验证码诞生的核心目的。然而,随着大数据运算与机器视觉技术的飞速发展,图像识别已变得相对容易,过去用于区分人机行为的验证码安全性正逐渐降低。
接下来,我们将从零开始,深入探讨图像处理与算法构建,展示使用机器视觉识别过时验证码的简易流程(如下所示)。

环境配置与数据获取
载入需要的程序包 & 设置全局变量
import requests
import time
from io import BytesIO
from PIL import Image
import os
import numpy as np

# 获取验证码的网址
CAPT_URL = "http://xxxxxxxxxxxx.cn/servlet/ImageServlet"

# 验证码的保存路径
CAPT_PATH = "capt/"
if not os.path.exists(CAPT_PATH):
  os.mkdir(CAPT_PATH)

# 将验证码转为灰度图时用到的"lookup table"
THRESHOLD = 165
LUT = [0]*THRESHOLD + [1]*(256 - THRESHOLD)
从网站获取验证码
capt_fetch()方法实现简单,直接从网站获取验证码并将其转换为Image对象,以便后续训练和测试环节调用。
def capt_fetch():
  """
  从网站获取验证码,将验证码转为Image对象

  :require requests: import requests
  :require time: import time
  :require BytesIO: from io import BytesIO
  :require Image: from PIL import Image

  :param:
  :return capt: 一个Image对象
  """
  # 从网站获取验证码
  capt_raw = requests.get(CAPT_URL)

  # 将二进制的验证码图片写入IO流
  f = BytesIO(capt_raw.content)

  # 将验证码转换为Image对象
  capt = Image.open(f)

  return capt
保存验证码到本地
- 强大的机器学习模型依赖于充足的训练集。因此,在训练模型前,必须预先构建一个带有标签(预分类)的验证码图片集合。
- capt_download()方法用于建立训练图像集,它调用capt_fetch()获取Image对象并展示给用户,等待用户输入验证码字符后,将图片以用户输入的字符命名并存储。
- 为避免文件名重复(例如获取到两张字符相同的验证码),capt_download()方法在文件名中加入了系统时间戳。
def capt_download():
  """
  将Image类型的验证码对象保存到本地

  :require Image: from PIL import Image
  :require os: import os

  :require capt_fetch(): 从nbsc网站获取验证码
  :require CAPT_PATH: 验证码保存路径

  :param:
  :return:
  """
  capt = capt_fetch()
  capt.show()

  text = raw_input("请输入验证码中的字符:")
  suffix = str(int(time.time() * 1e3))

  capt.save(CAPT_PATH + text + "_" + suffix + ".jpg")
图像预处理流程
图像预处理
- capt_process()方法首先将验证码转换为灰度图,随后根据全局变量中定义的LUT(查找表)将灰度图转换为黑白二值图,并按验证码中四个字符的位置进行切割。
- 从彩色图到灰度图再到黑白图,虽然看似损失了部分信息,但目的是使字符特征更加显著。
- 最终得到的黑白图像可能包含少量噪点,这主要源于前景色与背景色区分度不足。虽然可以使用滤波器过滤,但少量噪点会被训练模型视为误差处理,不影响分类结果。关于去噪方法,后续会有专门文章介绍。
def capt_process(capt):
  """
  图像预处理:将验证码图片转为二值型图片,按字符切割

  :require Image: from PIL import Image
  :require LUT: A lookup table, 包含256个值

  :param capt: 验证码Image对象
  :return capt_per_char_list: 一个数组包含四个元素,每个元素是一张包含单个字符的二值型图片
  """
  capt_gray = capt.convert("L")
  capt_bw = capt_gray.point(LUT, "1")

  capt_per_char_list = []
  for i in range(4):
    x = 5 + i * 15
    y = 2
    capt_per_char = capt_bw.crop((x, y, x + 15, y + 18))
    capt_per_char_list.append(capt_per_char)

  return capt_per_char_list
图像预处理的效果如下:
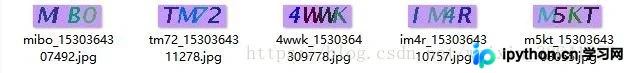
原始图像
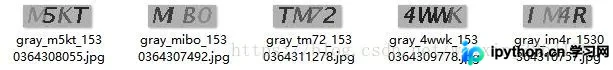
灰度图
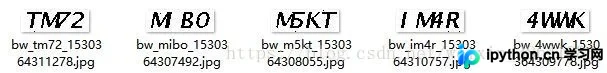
黑白图
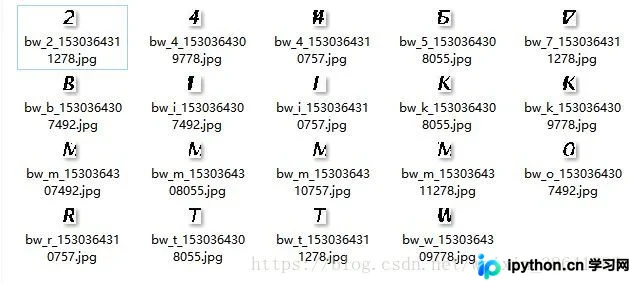
按字符切分后的黑白图像
由于字符宽度存在差异,切分后部分字符可能多出部分笔画,部分则缺失。例如“7”多出一笔形似三角形,“M”少一竖形似“N”。但只要字符间具备区分度,仍能实现准确分类。
特征值提取与训练集构建
提取图像中的特征值
- 此时获得的图像均为由单个字符组成的黑白图片(0代表黑色像素,1代表白色像素)。若将图片转为数组,将得到一个与图片长宽一致的0/1矩阵,每个数字代表一个像素点。
- 接下来需确定如何提取区分不同字符的特征值。可以直接将每个像素点作为特征,或汇总黑色像素总数(每图仅一个特征),亦可按区域汇总(如将图片四等分后汇总子图像素,若特征不足可继续细分直至像素级)。
- 为简化代码,此处直接对图像像素进行行列汇总,共提取1张图片总像素 + 15列像素 + 18行像素,合计34个特征值。按区域汇总的方法将在后续文章中单独介绍。
def capt_inference(capt_per_char):
  """
  提取图像特征

  :require numpy: import numpy as np

  :param capt_per_char: 由单个字符组成的二值型图片
  :return char_features:一个数组,包含 capt_per_char中字符的特征
  """
  char_array = np.array(capt_per_char)

  total_pixels = np.sum(char_array)
  cols_pixels = np.sum(char_array, 0)
  rows_pixels = np.sum(char_array, 1)

  char_features = np.append(cols_pixels, rows_pixels)
  char_features = np.append(total_pixels, char_features)

  return char_features.tolist()
生成训练集
此处将预分类的每张验证码读入内存,提取其特征值,并从文件名中提取对应文字作为标签。将特征值与标签分别汇总为列表,注意train_labels中的每个元素与train_table中的每一行相对应。
def train():
  """
  将预分类的验证码图片集转化为字符特征训练集

  :require Image: from PIL import Image
  :require os: import os

  :require capt_process(): 图像预处理
  :require capt_inference(): 提取图像特征

  :param:
  :return train_table: 验证码字符特征训练集
  :return train_labels: 验证码字符预分类结果
  """
  files = os.listdir(CAPT_PATH)

  train_table = []
  train_labels = []

  for f in files:
    train_labels += list(f.split("_")[0])

    capt = Image.open(CAPT_PATH + f)
    capt_per_char_list = capt_process(capt)
    for capt_per_char in capt_per_char_list:
      char_features = capt_inference(capt_per_char)
      train_table.append(char_features)

  return train_table, train_labels
分类模型定义与实现
定义分类模型
- 只要提取的特征值具备足够区分度,理论上可使用任何机器学习模型建立特征值与标签的关联。
- 尝试使用knn、svm、Decision Tree、ANN等主流机器学习模型对训练数据进行分类,尽管各模型表现不同,但识别准确率均可轻松达到90%以上。
- 为避免依赖复杂的第三方模型,此处自行编写了一个分类模型。该模型实现的nnc算法属于knn的一种,通过比对未知分类的特征值测试集与已知分类的特征值训练集的距离,判定测试集分类应与距离最近的训练集标签相同。
- 当然,也可稍加改造直接实现knn算法,寻找与未知分类特征向量最接近的3组、5组或k组训练集特征向量,并通过投票机制预测未知分类所属类别。
def nnc(train_table, test_vec, train_labels):
  """
  Nearest Neighbour Classification(近邻分类法),
  根据已知特征矩阵的分类情况,预测未分类的特征向量所属类别

  :require numpy: import numpy as np

  :param train_table: 预分类的特征矩阵
  :param test_vec: 特征向量, 长度必须与矩阵的列数相等
  :param labels: 特征矩阵的类别向量
  :return : 预测特征向量所属的类别
  """

  dist_mat = np.square(np.subtract(train_table, test_vec))
  dist_vec = np.sum(dist_mat, axis = 1)
  pos = np.argmin(dist_vec)

  return train_labels[pos]
模型测试与结果验证
测试模型分类效果
最后,需验证理论有效性。通过调用test()方法,先从网站获取验证码图像,进行预处理和特征提取,随后调用nnc()方法对提取的四组特征值进行近邻分类,分别得到验证码中的四个字符。最后输出验证码图像及识别字符,便于比对结果。
def test():
  """
  测试模型分类效果

  :require Image: from PIL import Image

  :require capt_fetch(): 从nbsc网站获取验证码
  :require capt_process(): 图像预处理
  :require capt_inference(): 提取图像特征
  :train_table, train_labels: train_table, train_labels = train()

  :param:
  :return capt: 验证码图片
  :return test_labels: 验证码识别结果
  """

  test_labels = []

  capt = capt_fetch()
  capt_per_char_list = capt_process(capt)
  for capt_per_char in capt_per_char_list:
    char_features = capt_inference(capt_per_char)
    label = nnc(train_table, char_features, train_labels)
    test_labels.append(label)

  test_labels = "".join(test_labels)

  return capt, test_labels
训练数据,识别验证码
- 方法已具备,接下来进入实践环节。
- 首先,需建立机器学习库,即预分类的验证码图片集。此处仅获取120张验证码作为训练集,相比tensorflow动辄成千上万次的迭代,所需样本量极少。这得益于nnc算法无需庞大训练集支持,从而节省了人工识别验证码的精力。
- 随后,调用train()方法生成训练集和标签数组。这两个数组会被test()方法使用,但由于存储于全局变量中,无需特意传递给test()方法。
# 下载120张图片到本地
for i in range(120):
  capt_download()

# 模型的训练与测试
train_table, train_labels = train()
test_capt, test_labels = test()
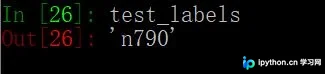
最后调用test()方法验证理论是否成立,识别效果如下:
获取到的验证码

识别结果
总结与展望
结语
至此,通过机器视觉识别验证码的任务完成。正确率方面,大约每10张验证码、40个字符中会预测失误一个字符,已接近人类识别准确率。当然,可通过建立更庞大的学习库、使用knn或更复杂模型、采用卷积核处理图片等方式,进一步提升识别准确率。
此外,此处方法仅适用于识别较简单的验证码。对于更复杂的验证码(如下图),上述方法无效,但这并不意味着此类验证码无法通过机器视觉识别。
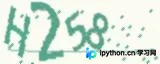
可见,随着机器视觉发展,通过传统验证码区分人机已越来越难。为保障网络安全,可使用更复杂的验证码或新型验证方式,如拖动滑块、短信验证、扫码登录等。
以上所述是小编给大家介绍的python自动识别验证码详解整合,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









