

Python实现广度优先搜索:获取无权图两点间最短路径

本文详解如何使用Python实现广度优先搜索(BFS)以寻找无权图中起点到终点的最短路径。文章从BFS的时间复杂度与适用场景入手,通过层序遍历思路解析算法逻辑,并重点剖析了基于队列头指针记录步长的常见错误,最终给出使用计数器修正步长的正确实现方案,帮助开发者避免环路导致的步长计算偏差。
前言
此前一直未能完全掌握该算法的实现细节,本周日花费了整个下午终于理清了思路。为方便日后复习查阅,特此整理发布。核心需求是:给定一张图、起点和终点,输出这两点之间的最短路径。
广度优先搜索
适用范围:该算法适用于无权重的图。与深度优先搜索(DFS)相比,DFS占用内存较少但运行速度较慢,而BFS占用内存较多但搜索速度较快。
复杂度:时间复杂度为O(V+E),其中V代表顶点数,E代表边数。
思路
广度优先搜索的核心在于按层序进行遍历,即先将当前层的所有节点搜索完毕,再进入下一层搜索。参考下图所示结构:
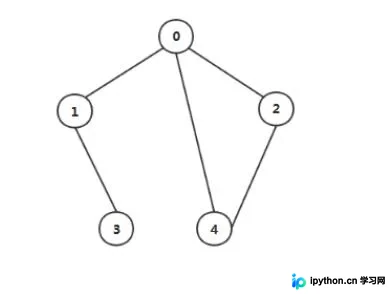
若从节点0开始搜索,初始时将节点0加入队列;接着处理下一层,节点0可达的节点有1、2、4,将它们依次加入队列;随后处理节点1,其可达且未被访问的节点为3。因此,节点的访问顺序为0、1、2、4、3,此处以下划线标识每一层搜索所得到的节点。
在每次迭代中,通过cur = que[head]取出头指针指向的节点,并搜索其可达的邻居节点。可以使用一个队列que来保存已访问的节点,队列包含头指针head和尾指针tail。若起点start与节点i存在边且节点i未被访问,则将节点i加入队列,尾指针tail后移;当tail等于顶点总数时,算法结束。
在每次while循环中,head加一,即向右移动,例如初始head位置为0,下一层时head指向的元素变为1,即搜索与节点1相连且未被访问的节点。
使用数组book标识节点i是否已被访问;使用字典保存从起点到各点的最短路径。具体代码如下:
import numpy as np

ini_matrix = [
     [0, 1, 1, 0, 1],
     [1, 0, 0, 1, 0],
     [1, 0, 0, 0, 1],
     [0, 1, 0, 0, 0],
     [1, 0, 1, 0, 0]
     ]


def bfs(matrix_para, start_point_para, end_point_para):
  """
  广度优先搜索
  :param matrix_para 图
  :param start_point_para 起点
  :param end_point_para 终点
  :return: 返回关联度
  """
  matrix = matrix_para
  start_point = start_point_para
  end_point = end_point_para

  vertex_num = len(matrix) # 顶点个数

  que = np.zeros(vertex_num, dtype=np.int) # 队列, 用于存储遍历过的顶点
  book = np.zeros(vertex_num, dtype=np.int) # 标记顶点i是否已经被访问,1表被访问,0表未被访问

  point_step_dict = dict() # key:点,value:起点到该点的步长

  # 队列初始化
  head = 0
  tail = 0

  # 从起点出发,将起点加入队列
  que[tail] = start_point # 等号右边为顶点号(起点)
  tail += 1
  book[start_point] = 1 # book[i] i为顶点号

  while head<tail:
    cur = que[head]
    for i in range(vertex_num):
      # 判断从顶点cur到顶点i是否有边,并判断顶点i是否已经被访问过
      if matrix[cur][i] == 1 and book[i] == 0:
        que[tail] = i # 将顶点i放入队列中
        tail += 1 # tail指针往后移
        book[i] = 1 # 标记顶点i为已经访问过
        point_step_dict[i] = head + 1 # 记录步长
      if tail == vertex_num: # 说明所有顶点都被访问过
        break
    head += 1

  for i in range(tail):
    print(que[i])

  try:
    relevancy = point_step_dict[end_point]
    return relevancy
  except KeyError: # 捕获错误,如果起点不能到达end_point,则字典里没有这个键,返回None
    return None

result = bfs(ini_matrix, 1, 4)
print("result:", result)
错误分析
经同学指出,原代码存在一个关键问题:不能单纯依靠head记录步长。在处理包含环路的图时,计算出的步长(迭代次数)可能大于实际最短路径。例如,起点为4,终点为3: 第一轮迭代:队列包含4,head指向4,步长记为0; 第二轮迭代:队列包含4、0、2,head指向0,步长记为1; 第三轮迭代:队列包含4、0、2、1,head指向2,步长记为2; 第四轮迭代:对于节点2,其周围节点均已被访问,但head仍自增为3,导致后续计算的步长比实际多1; 第五轮迭代:到达节点3,此时记录的步长为4,这与实际最短路径不符。
纠正方案
改进思路:引入count变量记录步长,使用flag标识当前搜索节点cur = que[head]周围是否还有未访问的邻居。若flag为False,表示cur的所有邻居均已访问完毕,此时步长count无需自增;若flag为True,说明有新节点入队,步长count加1。
import numpy as np

ini_matrix = [
     [0, 1, 1, 0, 1],
     [1, 0, 0, 1, 0],
     [1, 0, 0, 0, 1],
     [0, 1, 0, 0, 0],
     [1, 0, 1, 0, 0]
     ]


def bfs(matrix_para, start_point_para, end_point_para):
  """
  广度优先搜索
  :param matrix_para 图
  :param start_point_para 起点
  :param end_point_para 终点
  :return: 返回关联度
  """
  matrix = matrix_para
  start_point = start_point_para
  end_point = end_point_para

  vertex_num = len(matrix) # 顶点个数

  que = np.zeros(vertex_num, dtype=np.int) # 队列, 用于存储遍历过的顶点
  book = np.zeros(vertex_num, dtype=np.int) # 标记顶点i是否已经被访问,1表被访问,0表未被访问

  point_step_dict = dict() # key:点,value:起点到该点的步长

  # 队列初始化
  head = 0
  tail = 0

  # 迭代次数
  count = 0

  # 从0号顶点出发,将0号顶点加入队列
  que[tail] = start_point # 等号右边为顶点号(起点)
  tail += 1
  book[start_point] = 1 # book[i] i为顶点号

  while head<tail:
    flag = False # 用flag标识结点i是否周围都是被访问过的
    cur = que[head]
    for i in range(vertex_num):
      # 判断从顶点cur到顶点i是否有边,并判断顶点i是否已经被访问过
      if matrix[cur][i] == 1 and book[i] == 0:
        que[tail] = i # 将顶点i放入队列中
        tail += 1 # tail指针往后移
        book[i] = 1 # 标记顶点i为已经访问过
        point_step_dict[i] = count + 1 # 记录步长
        flag = True
      if tail == vertex_num: # 说明所有顶点都被访问过
        break
    if flag:
      count += 1
    head += 1

  for i in range(tail):
    print(que[i])

  try:
    relevancy = point_step_dict[end_point]
    return relevancy
  except KeyError:
    return None

result = bfs(ini_matrix, 3, 4)
print("result:", result)
写在后面
非常抱歉,这是首次尝试撰写此类算法博客,却出现了较大疏漏。以往多为记录BUG的文章,幸得同学及时指正。主要原因在于测试用例覆盖不足,未能提前发现环路场景下的逻辑缺陷。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









