

Python KMeans聚类算法实现:初始中心、距离与终止条件详解

本文通过Python实现KMeans聚类算法,重点探讨初始聚类中心选取、类间距离计算及终止条件设定。针对随机中心导致NaN的问题,对比了前K个样本与随机样本两种策略,并验证了欧氏距离与阈值终止法的有效性,最终通过Iris数据集展示聚类效果。
本文分享一个使用Python编写的KMeans聚类算法实例,供读者参考学习。
作为编程初学者,笔者近期尝试利用Python3实现几种基础机器学习分析方法,并在此记录学习过程中的实践心得。
此处不再赘述KMeans算法的基本原理,主要记录在实际编码过程中遇到的具体问题与解决方案。
一、初始聚类中心的选取策略
初始聚类中心的确定通常有以下几种方式:
(1)完全随机选取。
(2)先随机选取一个样本点作为第一个中心,再选取距离该点较远的点作为第二个中心,依此类推。
(3)利用层次聚类等其他算法预先计算并确定初始聚类中心。
起初,笔者尝试使用numpy库随机生成k个聚类中心。
Center = np.random.randn(k,n)
然而发现,在迭代几次后,聚类中心数值会出现NaN(非数字),具体原因尚不明确。
因此,笔者分别尝试了以下两种替代方案:
(1)直接选取数据集中的前K个样本作为初始中心点。
(2)从样本中随机抽取K个点作为初始聚类中心。
实验结果表明,两种方法均能完成聚类。使用iris.csv数据集时,选取前K个样本的迭代次数固定;而随机选取K个点时,迭代次数及聚类效果受随机种子影响较大:部分随机种子下聚类速度快且效果好,部分则速度慢且效果较差。
def InitCenter(k,m,x_train):
  #Center = np.random.randn(k,n)
  #Center = np.array(x_train.iloc[0:k,:]) #取数据集中前k个点作为初始中心
  Center = np.zeros([k,n])         #从样本中随机取k个点做初始聚类中心
  np.random.seed(5)            #设置随机数种子
  for i in range(k):
    x = np.random.randint(m)
    Center[i] = np.array(x_train.iloc[x])
  return Center
二、类间距离的计算方法
为简化处理,本文直接采用欧氏距离,暂未尝试其他距离算法。
def GetDistense(x_train, k, m, Center):
  Distence=[]
  for j in range(k):
    for i in range(m):
      x = np.array(x_train.iloc[i, :])
      a = x.T - Center[j]
      Dist = np.sqrt(np.sum(np.square(a))) # dist = np.linalg.norm(x.T - Center)
      Distence.append(Dist)
  Dis_array = np.array(Distence).reshape(k,m)
  return Dis_array
三、聚类终止条件的设定
聚类的终止条件有多种选择方式:
(1)设定固定的迭代次数。
(2)当聚类中心的更新幅度小于预设阈值时停止。
(3)当类中的样本归属不再发生变化时停止。
本文采用了前两种方法。第一种虽然简单,但聚类效果难以控制,针对不同数据集的稳健性不足。第二种方法更为合适,稳健性较强。第三种方法尚未尝试,未来可能通过该方法提高聚类精度。
def KMcluster(x_train,k,n,m,threshold):
  global axis_x, axis_y
  center = InitCenter(k,m,x_train)
  initcenter = center
  centerChanged = True
  t=0
  while centerChanged:
    Dis_array = GetDistense(x_train, k, m, center)
    center ,axis_x,axis_y,axis_z= GetNewCenter(x_train,k,n,Dis_array)
    err = np.linalg.norm(initcenter[-k:] - center)
    print(err)
    t+=1
    plt.figure(1)
    p=plt.subplot(3, 3, t)
    p1,p2,p3 = plt.scatter(axis_x[0], axis_y[0], c='r'),plt.scatter(axis_x[1], axis_y[1], c='g'),plt.scatter(axis_x[2], axis_y[2], c='b')
    plt.legend(handles=[p1, p2, p3], labels=['0', '1', '2'], loc='best')
    p.set_title('Iteration'+ str(t))
    if err < threshold:
      centerChanged = False
    else:
      initcenter = np.concatenate((initcenter, center), axis=0)
  plt.show()
  return center, axis_x, axis_y,axis_z, initcenter
其中,err表示本次迭代生成的聚类中心与上次迭代聚类中心之间的欧氏距离。
threshold为人为设定的终止聚类阈值,笔者通常设置为0.1或0.01。
为了展示每次迭代产生的类别分布,笔者修改了上述代码,利用matplotlib库绘制每次迭代的散点图。
以下是测试数据时的部分截图,子图数量需根据实际迭代次数进行设置。
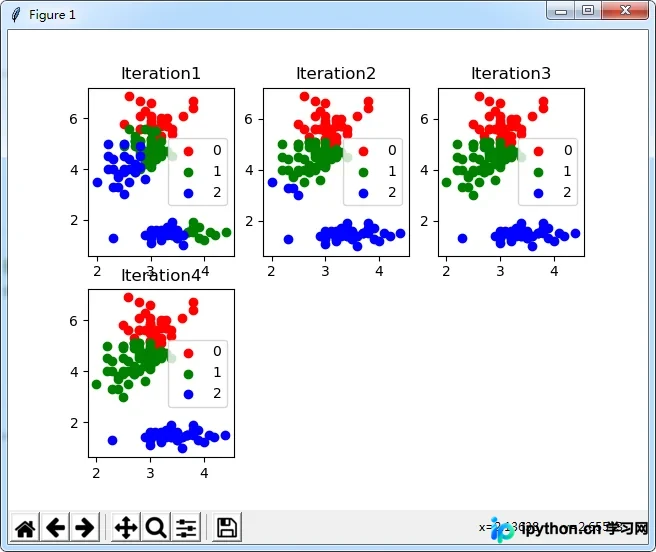
经过几个数据集的测试,该聚类算法的精度表现尚可。
使用iris数据集分析的具体结果如下:
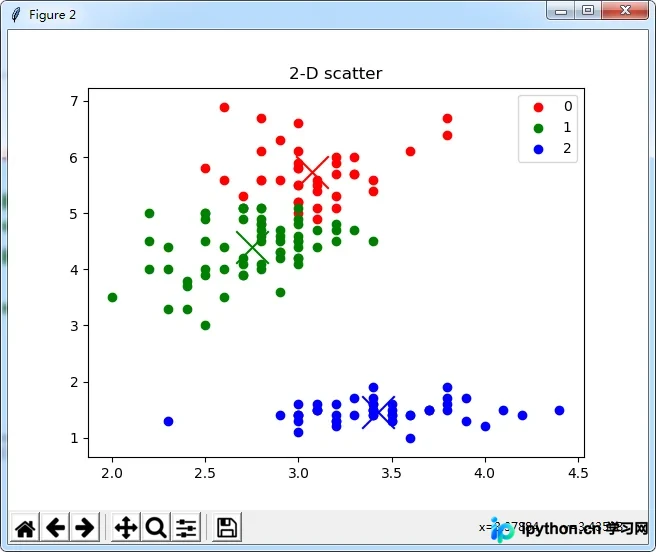
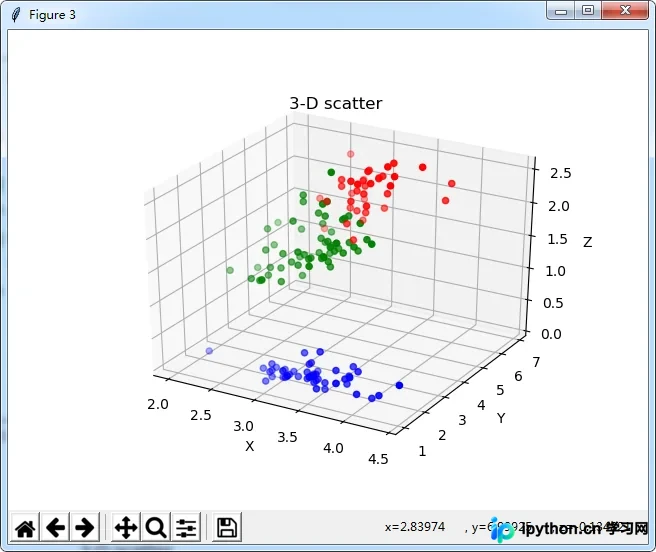
err of Iteration 1 is 3.11443180281 err of Iteration 2 is 1.27568813621 err of Iteration 3 is 0.198909381512 err of Iteration 4 is 0.0 Final cluster center is [[ 6.85 3.07368421 5.74210526 2.07105263] [ 5.9016129 2.7483871 4.39354839 1.43387097] [ 5.006 3.428 1.462 0.246 ]]
最后附上完整代码,如有错误欢迎批评指正,谢谢。
#encoding:utf-8
"""
  Author:   njulpy
  Version:   1.0
  Data:   2018/04/11
  Project: Using Python to Implement KMeans Clustering Algorithm
"""
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from mpl_toolkits.mplot3d import Axes3D
from sklearn.cluster import KMeans
def InitCenter(k,m,x_train):
  #Center = np.random.randn(k,n)
  #Center = np.array(x_train.iloc[0:k,:]) #取数据集中前k个点作为初始中心
  Center = np.zeros([k,n])         #从样本中随机取k个点做初始聚类中心
  np.random.seed(15)            #设置随机数种子
  for i in range(k):
    x = np.random.randint(m)
    Center[i] = np.array(x_train.iloc[x])
  return Center
def GetDistense(x_train, k, m, Center):
  Distence=[]
  for j in range(k):
    for i in range(m):
      x = np.array(x_train.iloc[i, :])
      a = x.T - Center[j]
      Dist = np.sqrt(np.sum(np.square(a))) # dist = np.linalg.norm(x.T - Center)
      Distence.append(Dist)
  Dis_array = np.array(Distence).reshape(k,m)
  return Dis_array
def GetNewCenter(x_train,k,n, Dis_array):
  cen = []
  axisx ,axisy,axisz= [],[],[]
  cls = np.argmin(Dis_array, axis=0)
  for i in range(k):
    train_i=x_train.loc[cls == i]
    xx,yy,zz = list(train_i.iloc[:,1]),list(train_i.iloc[:,2]),list(train_i.iloc[:,3])
    axisx.append(xx)
    axisy.append(yy)
    axisz.append(zz)
    meanC = np.mean(train_i,axis=0)
    cen.append(meanC)
  newcent = np.array(cen).reshape(k,n)
  NewCent=np.nan_to_num(newcent)
  return NewCent,axisx,axisy,axisz
def KMcluster(x_train,k,n,m,threshold):
  global axis_x, axis_y
  center = InitCenter(k,m,x_train)
  initcenter = center
  centerChanged = True
  t=0
  while centerChanged:
    Dis_array = GetDistense(x_train, k, m, center)
    center ,axis_x,axis_y,axis_z= GetNewCenter(x_train,k,n,Dis_array)
    err = np.linalg.norm(initcenter[-k:] - center)
    t+=1
    print('err of Iteration '+str(t),'is',err)
    plt.figure(1)
    p=plt.subplot(2, 3, t)
    p1,p2,p3 = plt.scatter(axis_x[0], axis_y[0], c='r'),plt.scatter(axis_x[1], axis_y[1], c='g'),plt.scatter(axis_x[2], axis_y[2], c='b')
    plt.legend(handles=[p1, p2, p3], labels=['0', '1', '2'], loc='best')
    p.set_title('Iteration'+ str(t))
    if err < threshold:
      centerChanged = False
    else:
      initcenter = np.concatenate((initcenter, center), axis=0)
  plt.show()
  return center, axis_x, axis_y,axis_z, initcenter
if __name__=="__main__":
  #x=pd.read_csv("8.Advertising.csv")  # 两组测试数据
  #x=pd.read_table("14.bipartition.txt")
  x=pd.read_csv("iris.csv")
  x_train=x.iloc[:,1:5]
  m,n = np.shape(x_train)
  k = 3
  threshold = 0.1
  km,ax,ay,az,ddd = KMcluster(x_train, k, n, m, threshold)
  print('Final cluster center is ', km)
  #2-Dplot
  plt.figure(2)
  plt.scatter(km[0,1],km[0,2],c = 'r',s = 550,marker='x')
  plt.scatter(km[1,1],km[1,2],c = 'g',s = 550,marker='x')
  plt.scatter(km[2,1],km[2,2],c = 'b',s = 550,marker='x')
  p1, p2, p3 = plt.scatter(axis_x[0], axis_y[0], c='r'), plt.scatter(axis_x[1], axis_y[1], c='g'), plt.scatter(axis_x[2], axis_y[2], c='b')
  plt.legend(handles=[p1, p2, p3], labels=['0', '1', '2'], loc='best')
  plt.title('2-D scatter')
  plt.show()
  #3-Dplot
  plt.figure(3)
  TreeD = plt.subplot(111, projection='3d')
  TreeD.scatter(ax[0],ay[0],az[0],c='r')
  TreeD.scatter(ax[1],ay[1],az[1],c='g')
  TreeD.scatter(ax[2],ay[2],az[2],c='b')
  TreeD.set_zlabel('Z') # 坐标轴
  TreeD.set_ylabel('Y')
  TreeD.set_xlabel('X')
  TreeD.set_title('3-D scatter')
  plt.show()
附:上述示例中使用的iris.csv文件可点击此处本站下载。
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》及《Python入门与进阶经典教程》
希望本文所述内容能对大家的Python程序设计有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









