


把 Go 放到 Debian 这样的稳定 Linux 环境里,并发处理通常是最容易拉开差距的一环。真正决定效果的,不只是“Go 天生并发强”这句结论,而是 goroutine、channel、锁、原子操作和系统调度之间能否配合得当。下面按常见使用场景拆开来看:什么机制负责并发、什么工具负责控制、哪些优化值得优先做,以及 Debian 为什么特别适合承载这类程序。
Goroutines 与 Channels:Go 并发模型为什么好用
Go 并发的核心,首先是 goroutine,其次是 channel。前者负责把任务并行跑起来,后者负责让这些任务安全地交换数据。
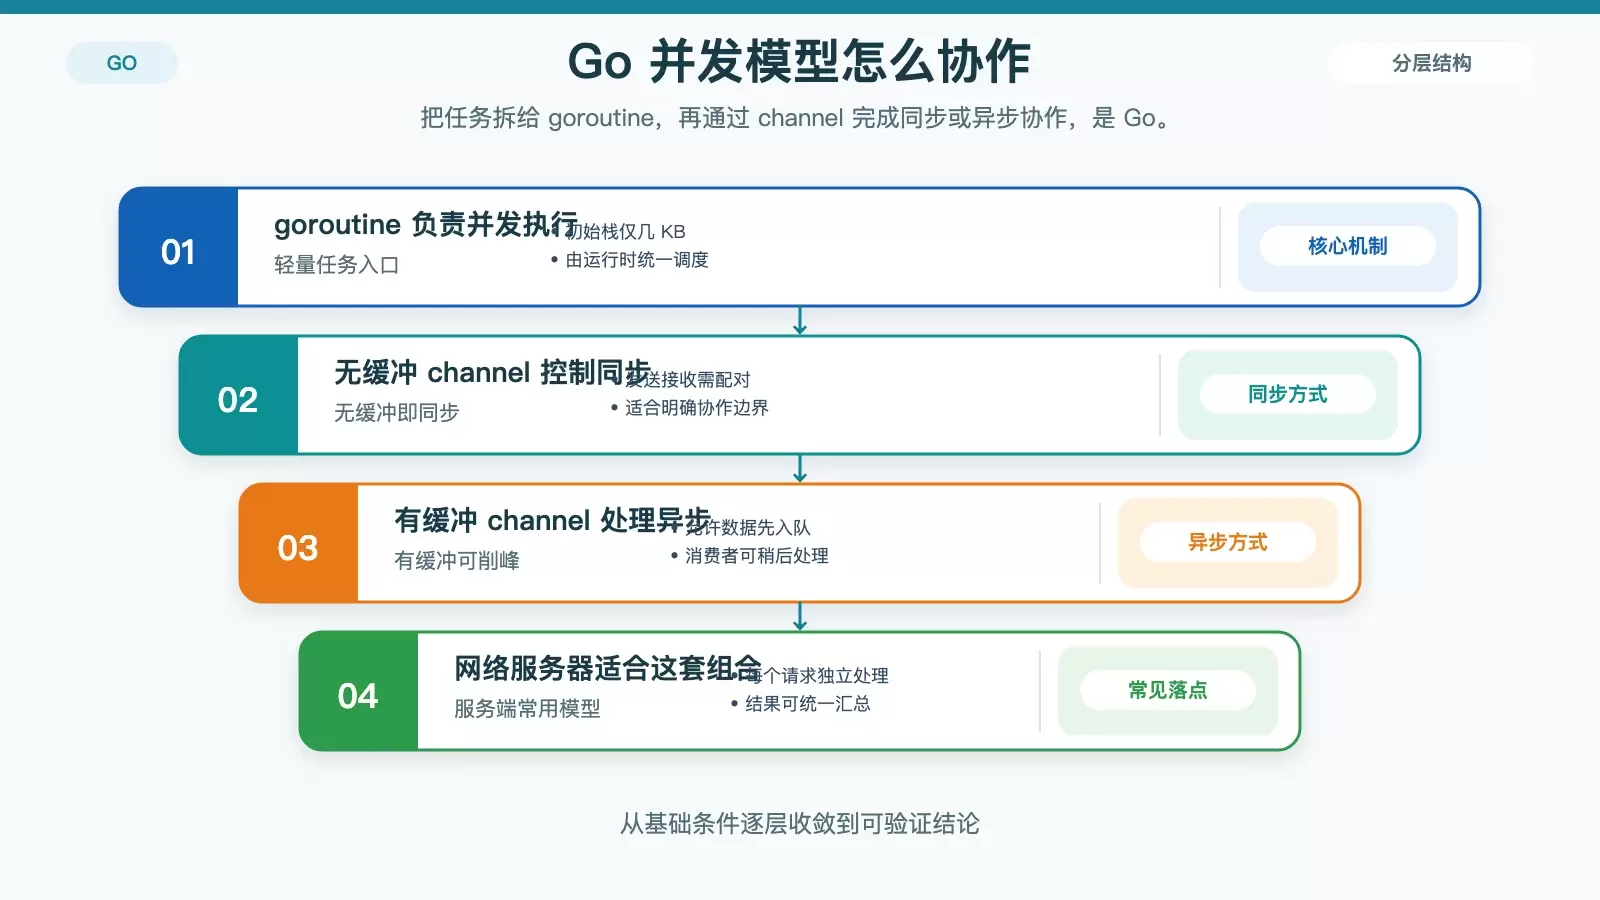
goroutine 轻量,适合高并发任务拆分
Goroutine 本质上是由 Go 运行时调度的轻量级线程。启动方式很直接,只需要一个 go 关键字,例如 go func()。和传统线程相比,它的初始栈只有几 KB,并且可以动态扩容,因此在单机上支撑大规模并发并不罕见,百万级并发也早已不是新鲜事。
这类模型特别适合把网络请求、数据处理、消息收发等任务拆成很多小单元分别执行。对于网络服务器来说,一个常见写法就是每个客户端请求启动一个 goroutine 处理,这样既能保持代码结构清晰,也能把多核 CPU 的吞吐能力用起来。
channel 负责同步与异步协作
channel 用来在 goroutine 之间传递数据。它的价值不只是“传值”,更重要的是把协作关系描述清楚。
- 无缓冲通道用于同步:发送和接收要配对完成。
- 有缓冲通道用于异步:允许一定数量的数据先进入队列,再由消费者继续处理。
这种方式能减少直接共享内存带来的复杂度,也能绕开不少容易引发锁竞争的写法。换句话说,Go 并发之所以更容易写对,很大程度上就来自 goroutine 与 channel 这套分工明确的模型。
除了 channel,还要会用 sync 和 atomic
并不是所有并发问题都适合只靠 channel 解决。遇到共享状态、并发读写、统一收尾这类问题时,标准库里的 sync 和 atomic 往往更直接。
sync 适合处理共享资源协作
sync 包里最常用的几类工具分别对应不同场景:
sync.Mutex:互斥锁,用来保护共享资源,避免多个 goroutine 同时修改同一份数据。sync.RWMutex:读写锁,适合读多写少的场景,允许多个读操作并发进行,从而提升整体性能。sync.WaitGroup:用于等待一组 goroutine 全部执行结束,适合批量任务、并行处理后的统一汇总。
这些工具的共同特点是控制明确、行为稳定,在需要直接管理共享数据时尤其有用。
atomic 适合低开销的简单状态更新
如果需求只是维护计数器、标志位,或者做一些非常简单的并发状态更新,使用 atomic 往往比加锁更划算。例如 atomic.AddInt64 这类原子操作,就能在避免锁开销的同时保证数据更新正确。
它适合的边界也很清楚:逻辑简单、状态单一、更新频繁。只要业务关系一复杂,还是应该回到更易维护的锁或 channel 协作模型上。
Debian 上跑 Go,优先关注这几类并发优化
Go 的并发模型已经提供了不错的基础,但想把程序跑得更稳、更快,通常还要在运行参数、资源复用和性能分析上继续下功夫。
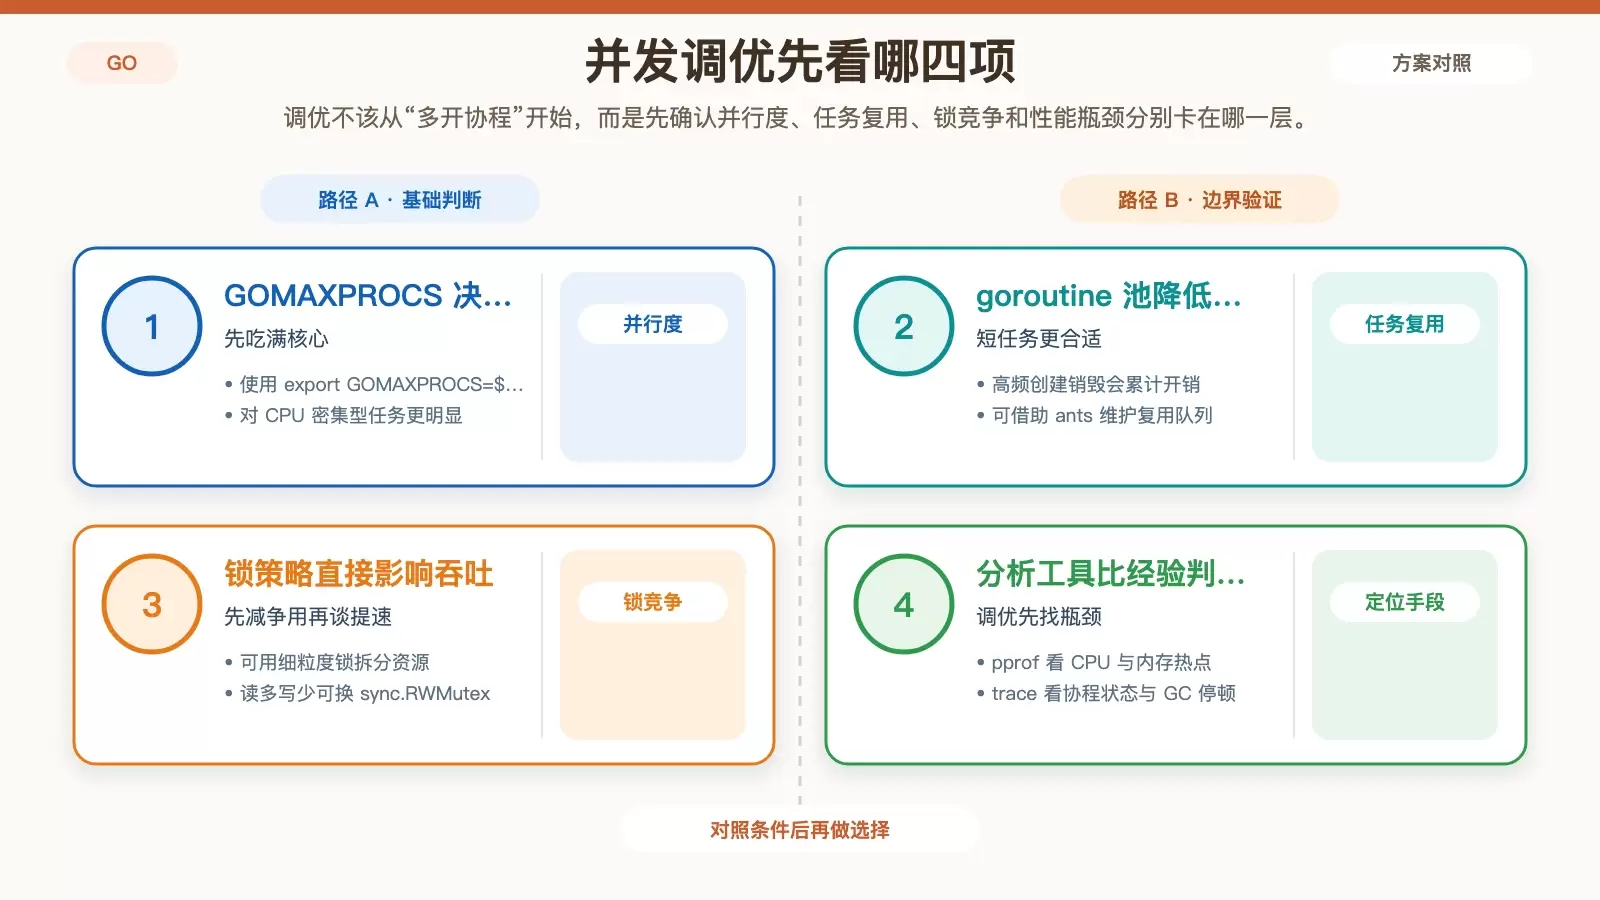
先把 CPU 并行度设置正确
对于 CPU 密集型任务,最直接的一步就是让程序尽可能利用机器上的全部核心。常见做法是:
export GOMAXPROCS=$(nproc)这样可以让 Go 运行时按当前机器可用核心数并行调度任务。对计算密集型程序来说,这一步常常能带来很直接的吞吐提升。
goroutine 池适合高频短任务
虽然 goroutine 很轻量,但如果任务创建和销毁极其频繁,调度和内存开销依然会累计。原文提到每个 goroutine 大概占用 2KB 内存,在高频场景下,这部分成本不能完全忽略。
这时可以考虑使用 goroutine 池,例如借助 ants 这类库,预先维护可复用的 goroutine 队列。它更适合短任务密集、执行模式高度相似的场景,而不是所有项目都默认引入。
锁要少争用,也要避免死锁
并发程序性能下滑,很多时候不是算力不够,而是锁竞争太重。常见优化方向包括:
- 采用细粒度锁,让不同资源各自加锁,避免一把大锁卡住全部请求。
- 在读多写少时使用
sync.RWMutex,降低读操作彼此阻塞的概率。 - 缩短锁持有时间,避免把耗时操作包进临界区。
- 按固定顺序获取锁,降低死锁风险。
这些原则看起来基础,但在高并发服务里,往往比单纯换库更有效。
减少内存分配,给 GC 降压
并发量上来之后,内存分配频率和垃圾回收压力会迅速放大。优化重点通常有两类:
- 使用
sync.Pool复用对象,例如复用某些struct实例,减少重复分配。 - 在合适场景下复用
[]byte,避免频繁字符串拼接造成额外分配。
这类优化的价值在于,它不一定直接提升业务逻辑速度,但常常能显著改善尾延迟和整体稳定性。
用 pprof 和 trace 找瓶颈,不靠猜
并发调优最忌讳凭感觉修改。Go 自带的分析工具已经足够实用:
pprof:定位 CPU 和内存热点,适合先看主要资源花在哪里。trace:观察 goroutine 状态、GC 停顿、系统调用等运行细节。
真正有效的优化,通常都是先用这些工具定位瓶颈,再决定是改锁策略、改分配方式,还是调整任务模型。这样做比盲目“优化并发”更省时间,也更容易得到稳定结果。
为什么 Debian 很适合承载 Go 并发程序
Go 的并发优势并不是脱离运行环境独立存在的。放到 Debian 上,它之所以显得更顺手,主要在于部署方式、硬件调度和生态兼容这三个方面都比较合拍。
静态编译让部署过程更简单
Go 编译后的可执行文件通常不依赖外部动态库,直接放到 Debian 机器上就能运行。对部署来说,这意味着交付形式更单纯:复制一个二进制文件、启动服务即可,不需要额外处理复杂依赖链。
这种特性在多环境发布、容器化部署和服务器迁移时尤其省事,也降低了线上环境差异带来的问题。
多核支持成熟,适合发挥 Go 调度器能力
Debian 对多核 CPU 的支持一直比较成熟,而 Go 的调度器采用 GMP 模型,能够把 goroutine 高效分配到不同核心执行。两者结合后,通常能把硬件利用率维持在比较理想的水平,尤其适合网络服务和后台处理程序这类并发负载。
依赖管理方便,生态工具完整
在 Debian 上安装开发依赖也比较顺手,像 build-essential、git 这样的基础工具都能通过软件仓库方便获取。再加上 Go 社区本身提供了大量面向 Linux 场景优化的第三方库,例如 fasthttp、negroni,从开发到部署的整体链路会更平滑。
怎么判断你的 Go 并发方案是否合适
如果只是概括结论,Go 在 Debian 上的并发处理能力确实很强;但真正有参考价值的判断标准,应该落在具体实现上。
当你的程序能够用 goroutine 清晰拆分任务、用 channel 或 sync/atomic 正确协调状态,再配合 GOMAXPROCS、对象复用以及 pprof、trace 做针对性调优时,Go 在 Debian 上通常就能把稳定性和吞吐量同时做出来。反过来说,如果锁竞争严重、内存分配失控、瓶颈定位全靠猜,那么语言和系统本身再强,也很难把并发优势真正兑现出来。









