


库存余额计算最容易出错的地方,不在公式本身,而在 SQL 组织方式:子查询能放哪、聚合应该在哪一层完成、筛选条件该压到哪里,都会直接影响结果对不对、查询快不快。下面按实际写库存余额时最常见的几个问题展开,既说明为什么会报错,也给出更适合批量查询商品余额的写法和判断标准。
子查询必须放在合法的查询上下文里
很多人在写库存 SQL 时,会先查期初、再查入库汇总、最后查出库汇总,然后打算把几段结果拼起来计算余额。问题在于,子查询不能像独立语句那样“先跑一个结果再拿来算”,它必须作为 SELECT 列表中的表达式,或者作为 WHERE 条件的一部分存在。
库存余额的本质仍然是:
期初 + 入库 - 出库因此,这三部分必须被放进同一个查询上下文中。如果拆散处理,常见后果就是语法错误,或者直接报出 subquery returns more than 1 row。
比较常见、也比较安全的几种用法包括:
- 用相关子查询按商品计算累计入库量:
(SELECT COALESCE(SUM(qty), 0) FROM stock_in WHERE item_id = t.item_id) - 如果所有商品共用一个全局期初值,可以用非相关子查询:
(SELECT init_qty FROM stock_init LIMIT 1) - 不要在
WHERE里的聚合子查询中随意引用外层字段,否则很容易触发Unknown column 't.item_id' in field list
换句话说,子查询不是不能用,而是必须嵌入到主查询可识别的位置。只要这个边界不清楚,后面的余额计算几乎都会越写越乱。
批量算库存时,优先用 LEFT JOIN 配合预聚合
如果只是查单个商品,相关子查询还能接受;但一旦要同时统计多个商品,分别为期初、入库、出库各写一层子查询,语句会迅速变得臃肿,排错也很痛苦。在 MySQL 8.0+ 或 PostgreSQL 里,这类写法还可能因为相关性处理不当导致性能明显下降,甚至出现重复行。
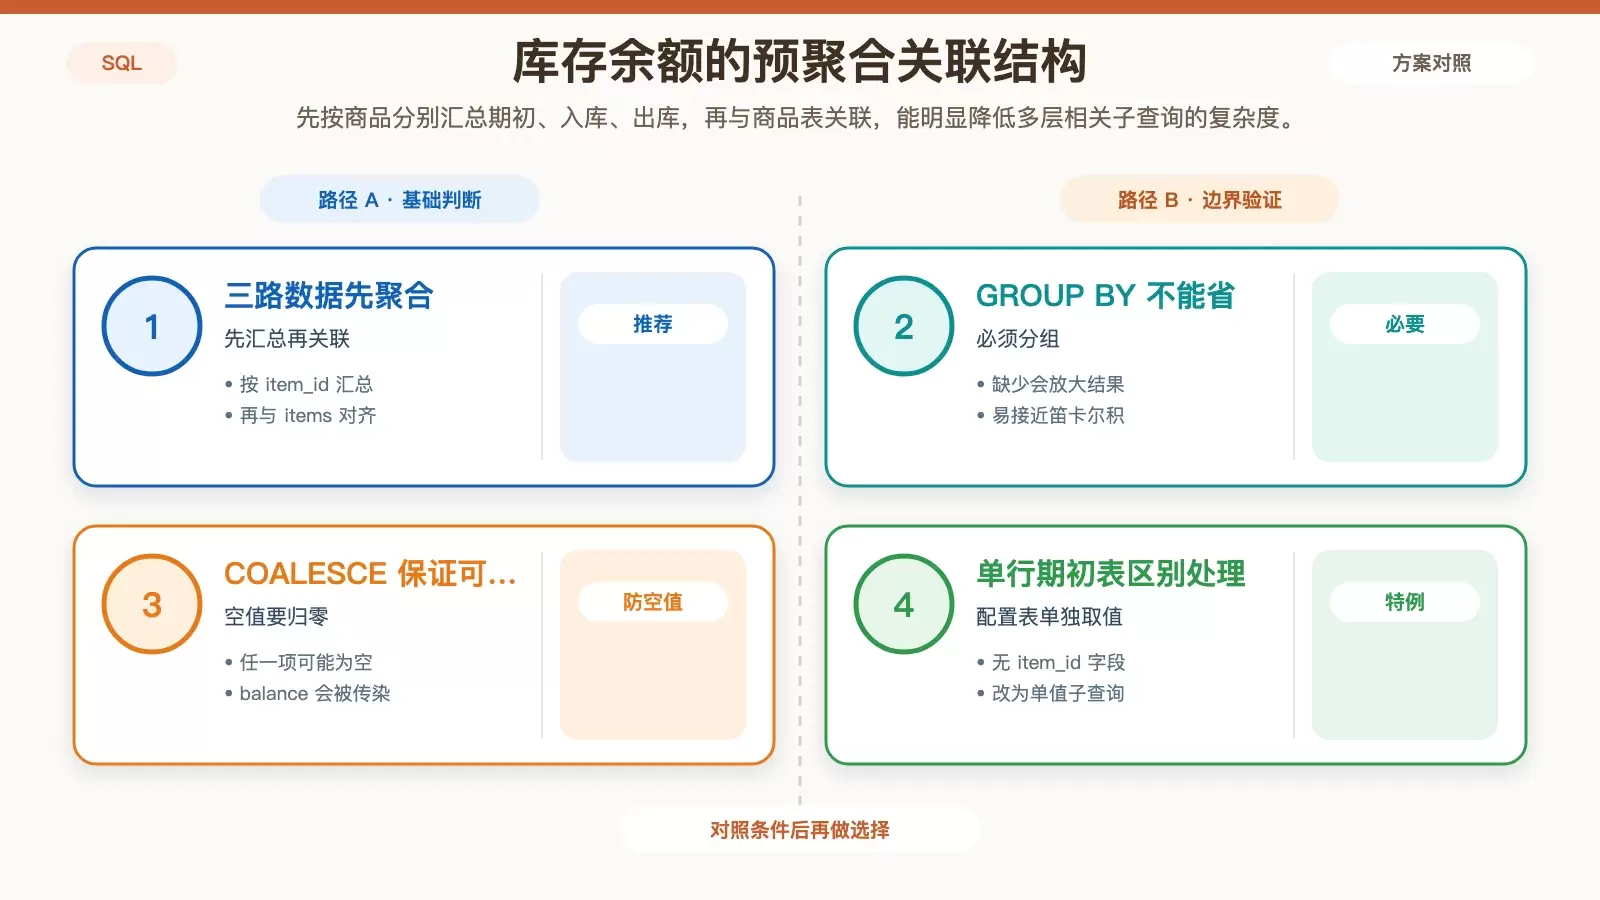
更适合批量余额计算的方式,是先在子查询中按商品聚合,再用 LEFT JOIN 关联到商品主表:
SELECT
t.item_id,
COALESCE(init.qty, 0) AS init_qty,
COALESCE(in_sum.total_in, 0) AS total_in,
COALESCE(out_sum.total_out, 0) AS total_out,
COALESCE(init.qty, 0) + COALESCE(in_sum.total_in, 0) - COALESCE(out_sum.total_out, 0) AS balance
FROM items t
LEFT JOIN (SELECT item_id, SUM(qty) AS qty FROM stock_init GROUP BY item_id) init ON init.item_id = t.item_id
LEFT JOIN (SELECT item_id, SUM(qty) AS total_in FROM stock_in GROUP BY item_id) in_sum ON in_sum.item_id = t.item_id
LEFT JOIN (SELECT item_id, SUM(qty) AS total_out FROM stock_out GROUP BY item_id) out_sum ON out_sum.item_id = t.item_id
这个结构的好处很直接:每个来源表先各自完成汇总,再把结果按 item_id 对齐,逻辑比多层相关子查询清楚得多。
这里有几个关键点不能省:
- 每个聚合子查询都要写
GROUP BY item_id,否则在JOIN时会产生放大效应,结果接近笛卡尔积 - 每个数量字段都要用
COALESCE包裹,否则只要某一项为NULL,整行balance就会变成NULL - 如果
stock_init并不是按商品存储,而是单行配置表,没有item_id字段,那么期初部分就不该参加按商品的JOIN,而应该改成非相关子查询:(SELECT qty FROM stock_init)
判断标准其实很简单:只要你面对的是“多个商品一次性出余额”,优先考虑“先聚合、再关联”,而不是“逐行跑多个子查询”。
余额过滤不要直接引用别名
很多查询在算出 balance 之后,还要继续筛选,比如找出余额小于 0 的商品。这时最常见的误写是直接在主查询里引用别名:
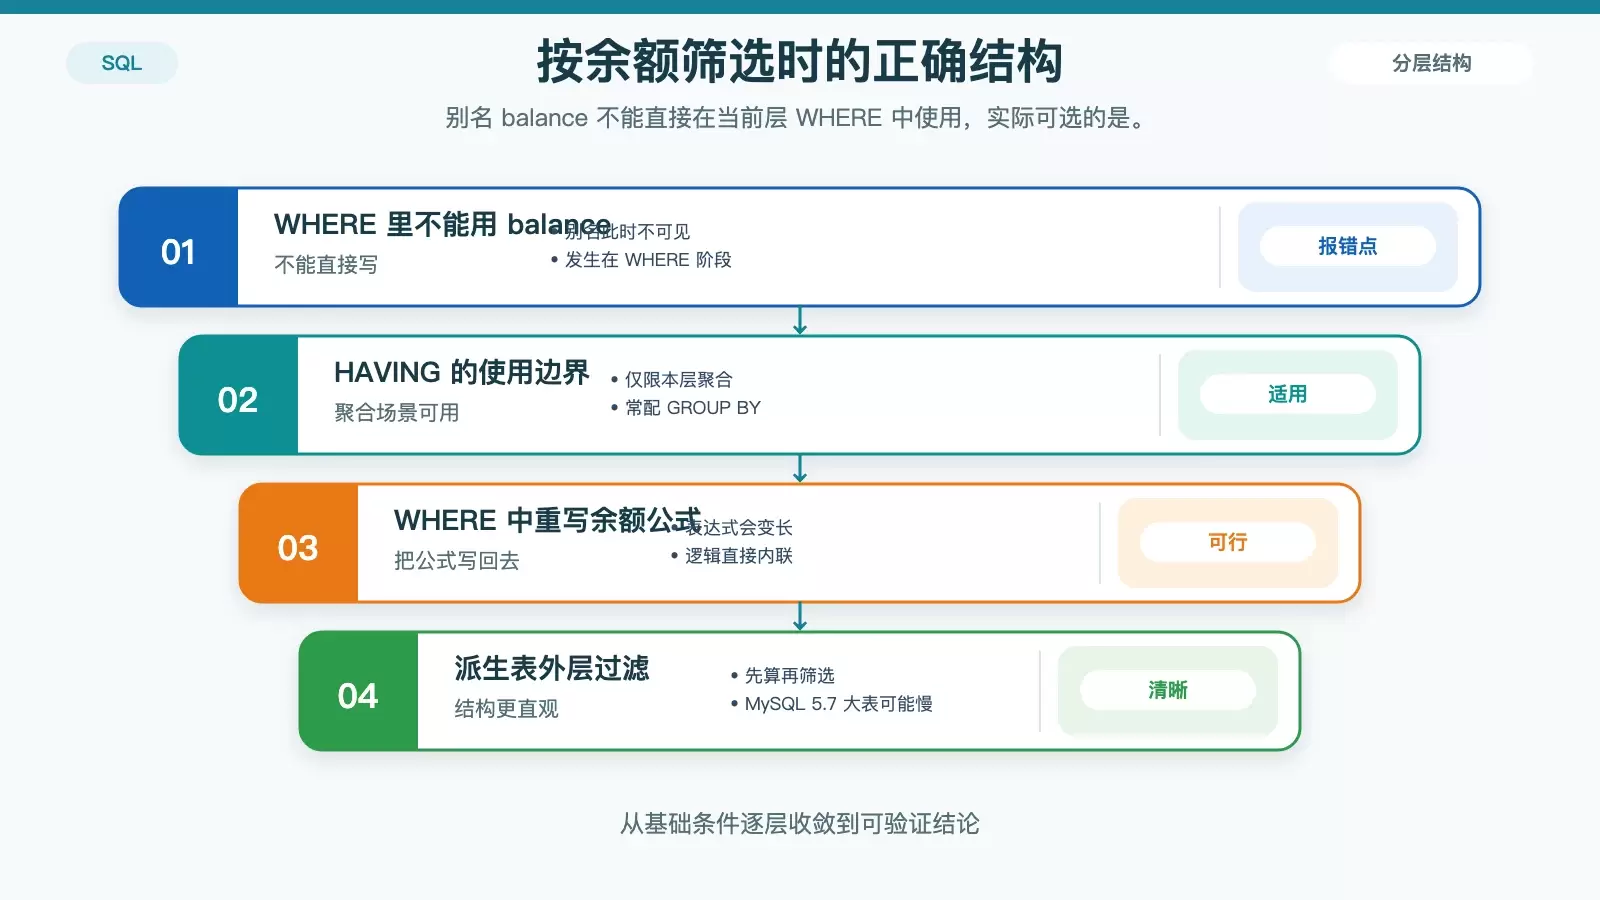
SELECT item_id, (SELECT ... ) AS balance FROM items WHERE balance < 0-- ❌ 报错:Unknown column 'balance'原因不复杂:WHERE 执行时,SELECT 列表中的别名还没有成为当前层可直接引用的字段,所以 balance 在这里并不可见。
通常有三种可行写法:
- 使用
HAVING,但这只适用于本层查询本身带GROUP BY的情况 - 把完整余额表达式直接写回
WHERE中,例如:WHERE (COALESCE((SELECT qty FROM stock_init WHERE item_id = items.item_id), 0) + ... ) < 0 - 把余额计算先包成派生表,再在外层过滤:
SELECT * FROM (SELECT ..., balance FROM ...) t WHERE t.balance < 0
从可读性看,派生表方式通常最清晰:先定义余额,再按余额筛选,层次明确,也更方便后续继续加条件。
不过这类写法在大数据量场景下也有代价。原文提到的限制仍然成立:MySQL 5.7 默认不支持给派生表直接加索引,因此如果结果集很大,外层再过滤可能会比较慢。也就是说,这不是不能用,而是要结合数据规模判断。
时间范围必须下推到各自子查询内部
库存余额一旦带时间条件,另一个高频错误就会出现:把“近 30 天”这类筛选写在最外层。看起来像是在过滤最近数据,实际上很可能是先把全量余额算完,再做外层限制,既慢也容易偏离业务含义。
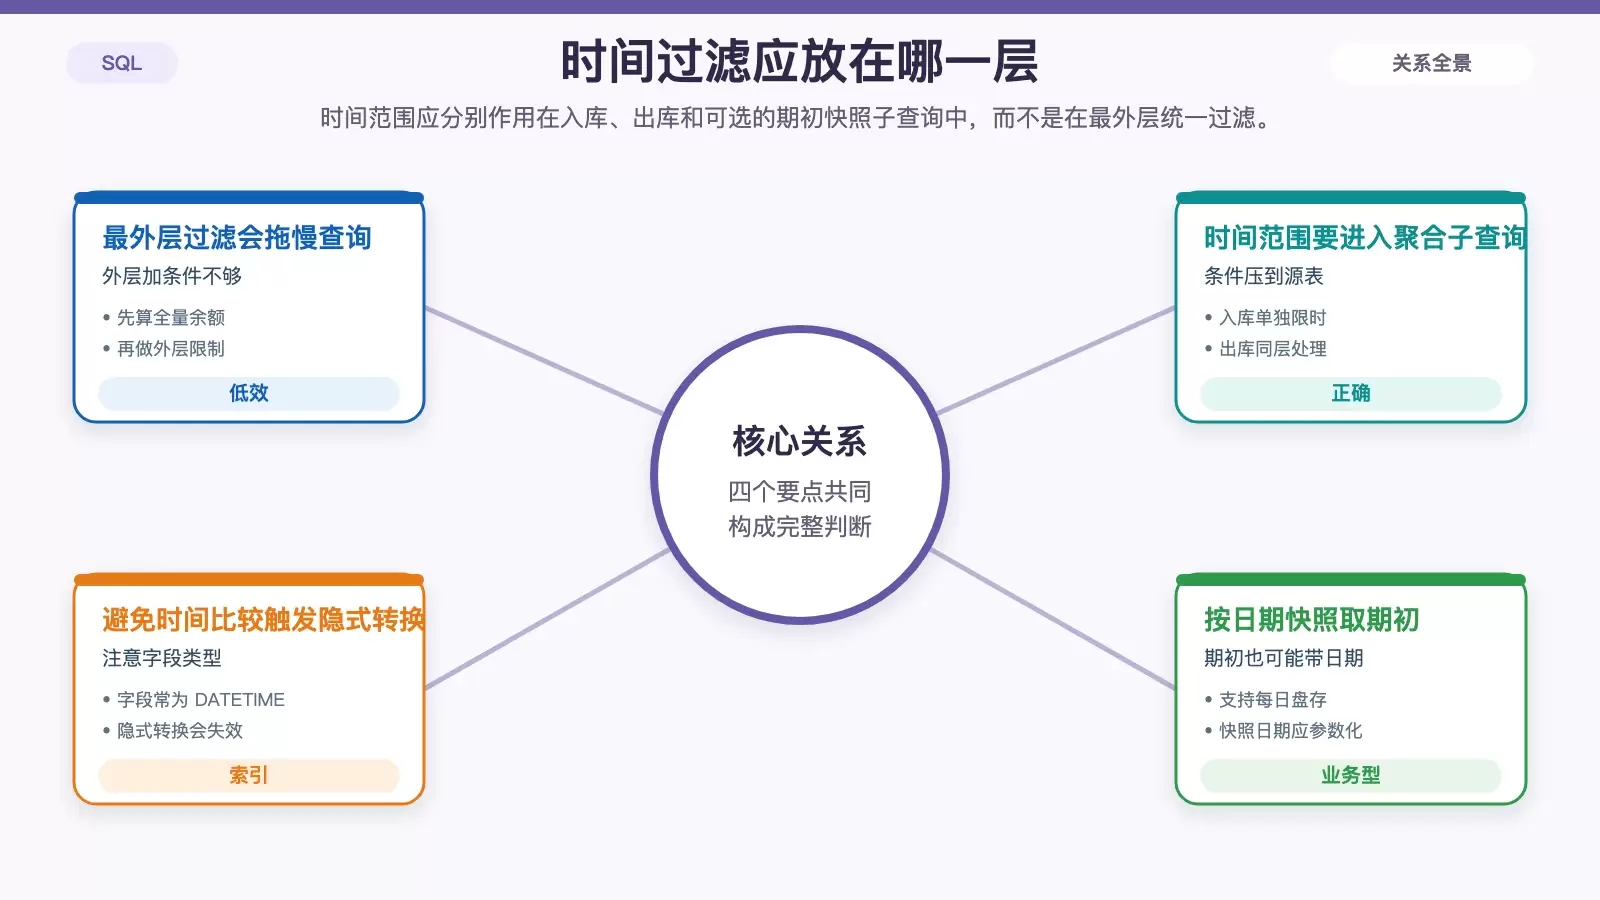
比如,不要只在最外层写:
WHERE log_time > DATE_SUB(NOW(), INTERVAL 30 DAY)更合理的方式,是把时间条件分别压到入库、出库,必要时也压到期初快照子查询中。也就是说,每一部分都只计算目标时间范围内的数据:
- 入库子查询:
SELECT item_id, SUM(qty) FROM stock_in WHERE log_time >= '2024-05-01' GROUP BY item_id - 出库子查询同样要加相同维度的时间条件
- 如果
log_time是DATETIME,还要注意避免隐式转换,否则索引可能失效 - 期初值如果支持按日期快照,例如每日盘存,就需要把快照日期作为参数传进对应子查询,而不是默认取当前唯一值
这背后的原则是“条件下推”:谁负责统计,谁就自己处理时间范围。这样既能减少参与聚合的数据量,也能让结果语义更准确。
SQL 正确不等于库存一定实时准确
即便查询语句本身写对了,库存余额仍然可能在实时场景下出现瞬时不准确。这个问题往往不在子查询、JOIN 或聚合函数,而在事务一致性。
例如,入库日志和出库日志如果不是由同一事务提交,或者关键读取过程没有使用 FOR UPDATE 等锁机制,那么你查到的余额可能刚好落在“入库已写入、出库未提交”或反过来的时间点上。此时结果偏差并不是 SQL 表达式算错了,而是业务数据本身处在并发中的中间状态。
因此,库存查询最终是否可靠,至少要同时满足两层条件:
- SQL 结构正确,避免重复统计、
NULL传播和错误过滤 - 业务写入模型有一致性约束,确保读到的是同一时点上的入库与出库数据
对库存这类强业务含义的字段来说,查询写法解决的是“怎么算”,事务模型解决的是“此刻这个数能不能信”。这两件事缺一不可。









