


Python实现DBSCAN密度聚类算法详解与代码示例
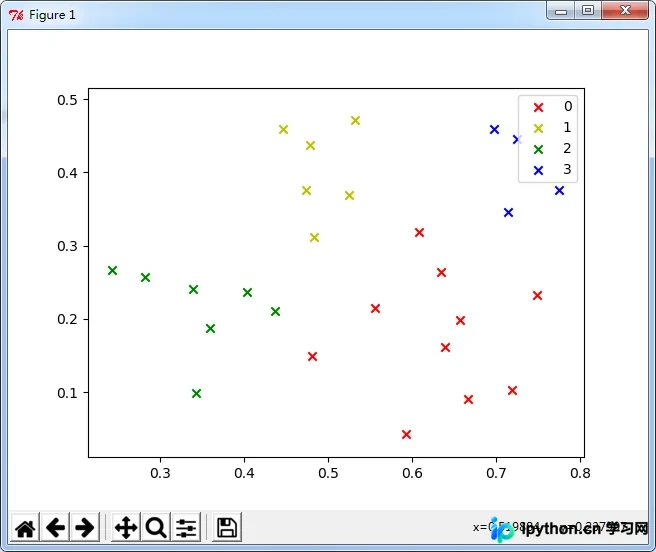
本文详细介绍Python中DBSCAN密度聚类算法的实现原理与操作步骤。涵盖ε-邻域、核心对象、密度直达与可达等核心概念,并提供完整的Python代码示例及运行结果图,帮助开发者快速掌握基于密度的聚类方法。
2026-10-13
7
本文详细介绍Python中DBSCAN密度聚类算法的实现原理与操作步骤。涵盖ε-邻域、核心对象、密度直达与可达等核心概念,并提供完整的Python代码示例及运行结果图,帮助开发者快速掌握基于密度的聚类方法。
本文深入解析Python闭包的构成条件与运行机制,阐述其作为装饰器底层原理的作用。通过示例展示闭包在保持变量生命周期、实现惰性求值及参数预绑定(类似functools.partial)方面的实际应用,帮助开发者理解闭包在面向对象与函数式编程间的桥梁作用。
本文介绍如何在Python 3.5.x环境中利用Kafka 1.4.3构建跨平台数据中转站。通过配置KafkaProducer与KafkaConsumer,结合Pandas处理CSV数据,实现从数据源到目标端的实时传输。文中详细说明了环境准备、代码实现及关键注意事项,包括服务器地址配置、JSON序列化转换及编码处理,旨在为开发者提供一套完整的实时数据同步解决方案。
本文介绍如何使用Python通过elasticsearch库批量获取超过10000条文档数据。核心思路是基于唯一字段升序和时间戳降序,先取前10000条,记录最后时间戳,后续查询利用该时间戳过滤,循环直至无数据返回,实现高效分页。
在使用Python requests库发送POST请求时,若data参数包含嵌套字典,默认form编码会导致数据解析异常。本文指出官方文档仅演示单层字典情况,并提供通过将内层字典转为JSON字符串作为解决方案,确保多层数据结构正确传输。
本文介绍如何使用 Python 直接访问服务器共享文件夹以筛选照片,解决传统拷贝方式速度慢的问题。重点指出 Windows 复制的路径格式在 Python 中会引发 IO 错误,通过将反斜杠替换为正斜杠即可顺利运行,实现高效本地处理。
本文详解Python中模拟登录的两种主要方式:直接复制浏览器Cookie与使用Session维持会话。重点解析为何普通请求无法保持登录状态,并通过代码示例展示如何利用requests.Session对象自动管理Cookie,实现跨请求的身份验证与数据获取,解决多页面交互中的会话断开问题。
本文详细记录了将HTMLTestRunner适配至Python3环境的具体修改步骤。针对Python3中StringIO模块移除、dict.has_key方法废弃、字符串decode操作变更以及print语法改变等问题,提供了从源码第94行到631行的具体代码修正方案,帮助开发者顺利在Python3环境下运行Selenium测试报告。
本文介绍使用Python生成XML报文的两种常见方法。第一种通过循环自增ID并拼接时间戳生成基础报文,适用于MQ接口发送场景;第二种基于预定义模板,利用列表遍历和字符串替换功能生成多行XML节点。代码包含完整实现逻辑,可直接参考用于实际开发中的报文构造需求。
本文介绍了如何使用Python的socket模块通过TCP协议发送XML格式的报文。代码示例展示了创建Socket连接、将XML字符串编码为字节数组并发送,以及接收服务器响应的完整过程。该方法适用于需要与特定端口进行XML数据交互的网络应用场景。
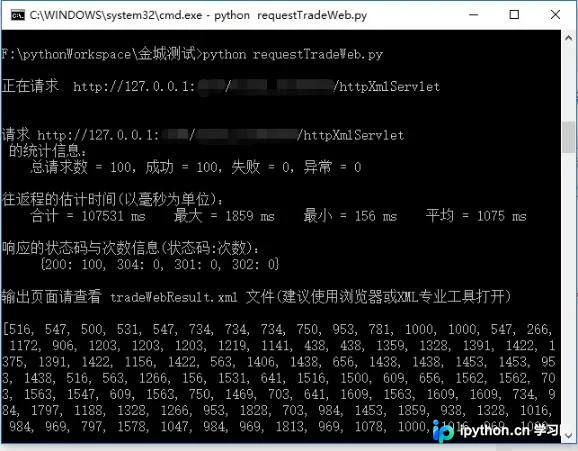
本文介绍如何使用 Python 3.x 编写基于 XML 数据的 HTTP 请求脚本,适用于 B/S 架构下的 WEB 服务通信测试。文章详细讲解了利用 urllib.request 发起请求、多线程并发处理、类与方法定义等核心技术,并提供了包含配置文件和源码的完整示例,旨在帮助开发者快速实现功能验证及初步的压力测试。
本文介绍如何使用Python3和Flask库开发一个用户注册POST接口。代码示例展示了从接收JSON请求、校验手机号格式与参数完整性,到利用MySQL工具执行注册SQL及密码加密处理的完整流程。该实现封装了核心逻辑,可作为后端开发参考,帮助开发者快速构建基础的注册功能模块。