


Python 利用内置set函数对字符串和列表进行去重的方法
本文介绍如何利用Python内置的set函数对字符串和列表进行去重操作。由于set具有无序和唯一值的特性,该方法简洁高效。文章包含具体代码示例,展示字符串和列表去重的实现过程及输出结果,供开发者参考。
2026-10-13
10
本文介绍如何利用Python内置的set函数对字符串和列表进行去重操作。由于set具有无序和唯一值的特性,该方法简洁高效。文章包含具体代码示例,展示字符串和列表去重的实现过程及输出结果,供开发者参考。
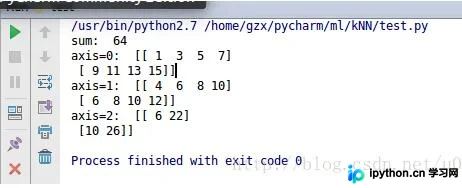
本文详细解析Python中numpy库array.sum()函数axis参数的作用机制。通过具体三维数组示例,分别演示axis=0、axis=1和axis=2时的元素相加逻辑与结果差异,帮助开发者理解不同维度下的聚合计算方式。
本文介绍利用Python去除文件中重复行的方法。通过定义空列表存储已出现行,遍历文件时判断是否重复,若重复则记录行号及内容至新文件,否则加入列表。该方案可有效识别并导出重复数据,适用于文本清洗场景。
本文深入解析Python3中zip()函数的核心机制,重点说明其作为迭代器仅能访问一次的内存优化特性,对比Python2的差异。详细演示单参数、多参数及矩阵场景下的用法,包括列表推导式实现矩阵加减点乘,以及利用*zip进行数据解包还原的方法,帮助开发者避免常见错误并高效处理多维数据。
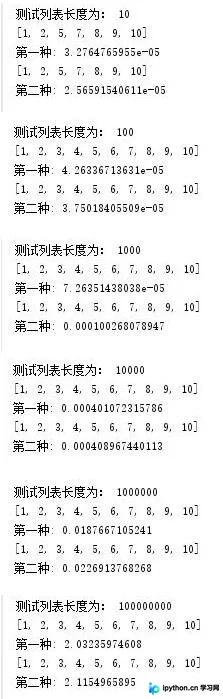
本文对比了Python中两种常见的列表去重方式:set()与{}.fromkeys().keys()。测试表明,在列表长度较短(小于1000)时,fromkeys方法速度更快;而当列表长度超过1000时,set()方法优势显著。文章提供了具体的测试代码与结果分析,并针对大规模数据处理给出了工具选择建议。
本文介绍在Python中比较两个字符串是否相同的方法。通过实例分析ord()函数处理多字符时的限制,展示利用切片技术逐个提取字符并比较其整数编码的实现方式,帮助初学者理解字符串处理细节。
本文详解Python中shelve模块的数据持久化用法。shelve是pickle的封装,支持将字典键值对持久化到文件,允许多次dump和load操作。通过生成.bak、.dat、.dir三个文件存储数据,可持久化列表、字典及datetime等类型。文章提供完整代码示例,展示如何保存和读取数据,适用于需要简单键值存储的场景。
本文介绍了在Python中对列表(List)内每个元素执行特定操作的两种主要方法:使用map函数结合自定义函数,以及利用列表推导式直接进行计算。通过具体代码示例展示了如何对列表元素进行平方运算,并对比了不同实现方式的输出结果,帮助开发者选择更高效的代码编写方式。
本文详细介绍如何使用Python实现选择排序算法,将数组元素按从小到大的顺序排列。通过定义查找最小值索引和排序主函数,逐步构建新数组,最终输出排序结果。适合Python初学者理解基础排序逻辑。
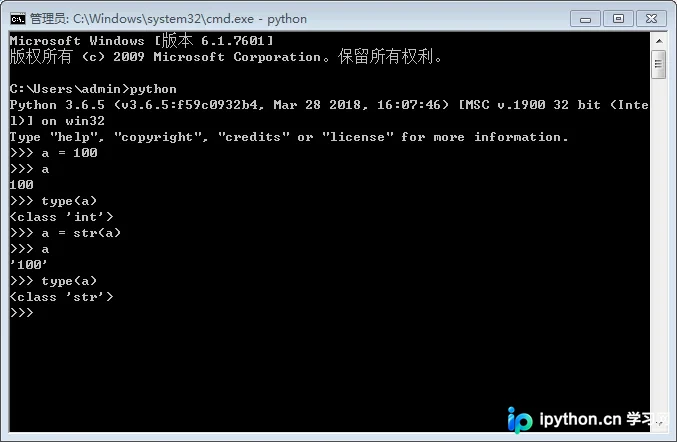
本文探讨Python中int与str相互转换时的内存行为。通过代码示例对比发现,整数转换后地址可能相同,而字符串转换后地址通常不同。文章简要介绍了使用int()和str()函数进行类型转换的具体方法及注意事项,帮助开发者理解Python的数据类型处理机制。
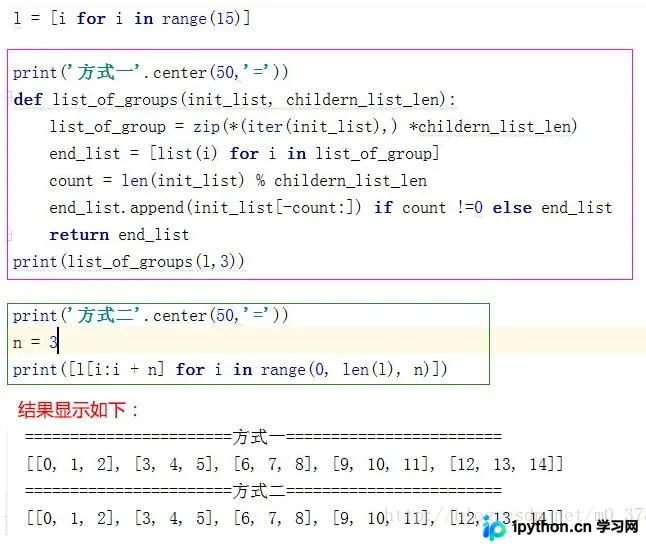
本文介绍在Python中将大列表分割为多个小列表的两种常用方法。第一种利用zip函数与迭代器技巧实现,第二种通过列表推导式结合切片操作完成。文章包含完整代码示例及运行效果分析,帮助开发者根据实际需求选择合适方案,提升数据处理效率。
本文介绍在Python中处理多层嵌套列表的拆分方法。通过递归遍历与异常捕获机制,将包含数字、字母及字典等元素的复杂嵌套结构逐层展开,最终输出包含所有原子元素的扁平列表,适用于数据清洗与预处理场景。