Python读取txt指定列并绘图的实现方法
本文介绍如何使用Python读取txt文件中的指定列数据,并利用matplotlib库进行可视化绘图。通过示例代码展示如何提取特定列作为x和y轴数据,绘制散点图或折线图,并添加标签、图例及样式设置,帮助读者快速实现数据可视化需求。
2026-10-12
6
本文介绍如何使用Python读取txt文件中的指定列数据,并利用matplotlib库进行可视化绘图。通过示例代码展示如何提取特定列作为x和y轴数据,绘制散点图或折线图,并添加标签、图例及样式设置,帮助读者快速实现数据可视化需求。
本文介绍如何利用Python的glob模块递归遍历指定目录,并通过JSON文件持久化记录文件列表,从而检测新增或删除的文件变更。代码包含递归遍历、状态对比及更新逻辑,适用于轻量级目录监控场景。
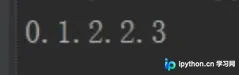
本文介绍如何使用Python将单词转换为数字模式(如“hello”转为“0.1.1.2.3”)。通过遍历字符并记录首次出现顺序,利用字典映射实现高效匹配。该方法是解决变位词分组、单词模式匹配等问题的基础,代码简洁且易于理解。
本文详细讲解Python threading模块的线程创建、状态控制与Lock同步机制,通过完整代码演示如何避免竞态条件与死锁。结合全局解释器锁(GIL)特性明确适用场景与资源管理规范,帮助开发者安全高效地编写并发程序。
在Python开发中,确认第三方库或内置模块的版本号对于排查兼容性问题至关重要。本文介绍了两种最常用的查看方法:通过导入模块后访问__version__属性,以及使用pkg_resources库获取版本信息。以networkx为例演示具体操作,帮助开发者快速定位环境依赖状态。
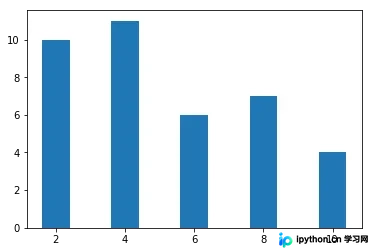
本文介绍了数据科学领域最核心的三个Python库:NumPy、Pandas和Matplotlib。NumPy提供高效的多维数组计算能力;Pandas通过DataFrame处理结构化数据;Matplotlib则负责生成各类可视化图表。文章包含具体的代码示例,展示了如何创建数据框并绘制条形图,帮助开发者快速上手Python数据分析。
解析Python函数中形参与实参的区别与绑定机制,通过位置参数、默认参数、关键字参数及可变参数的代码示例,演示实际传参方式与执行结果,帮助开发者规范函数定义并避免类型或数量匹配错误。
本文介绍如何使用 Python 批量读取指定目录下的 TXT 文件,并通过 linecache 模块提取特定行数据,经过字符串处理后转换为 CSV 格式。文章提供了完整的代码示例,涵盖文件遍历、行读取、数据清洗及文件写入等关键步骤。
在数据处理中,直接将 NaN 替换为 0 往往是不合理的策略,特别是对于如开氏温度等物理量。本文介绍如何利用 NumPy 的矩阵操作,按列计算非 NaN 值的均值,并以此填充矩阵中的缺失值,从而更科学地处理数据缺失问题。
在Python开发中,字典的Key为None时,命令行交互可直接取值,但脚本中直接访问会触发KeyError。本文分析该差异原因,并提供通过遍历字典安全获取None对应Value的解决方案,帮助开发者避免脚本运行异常。
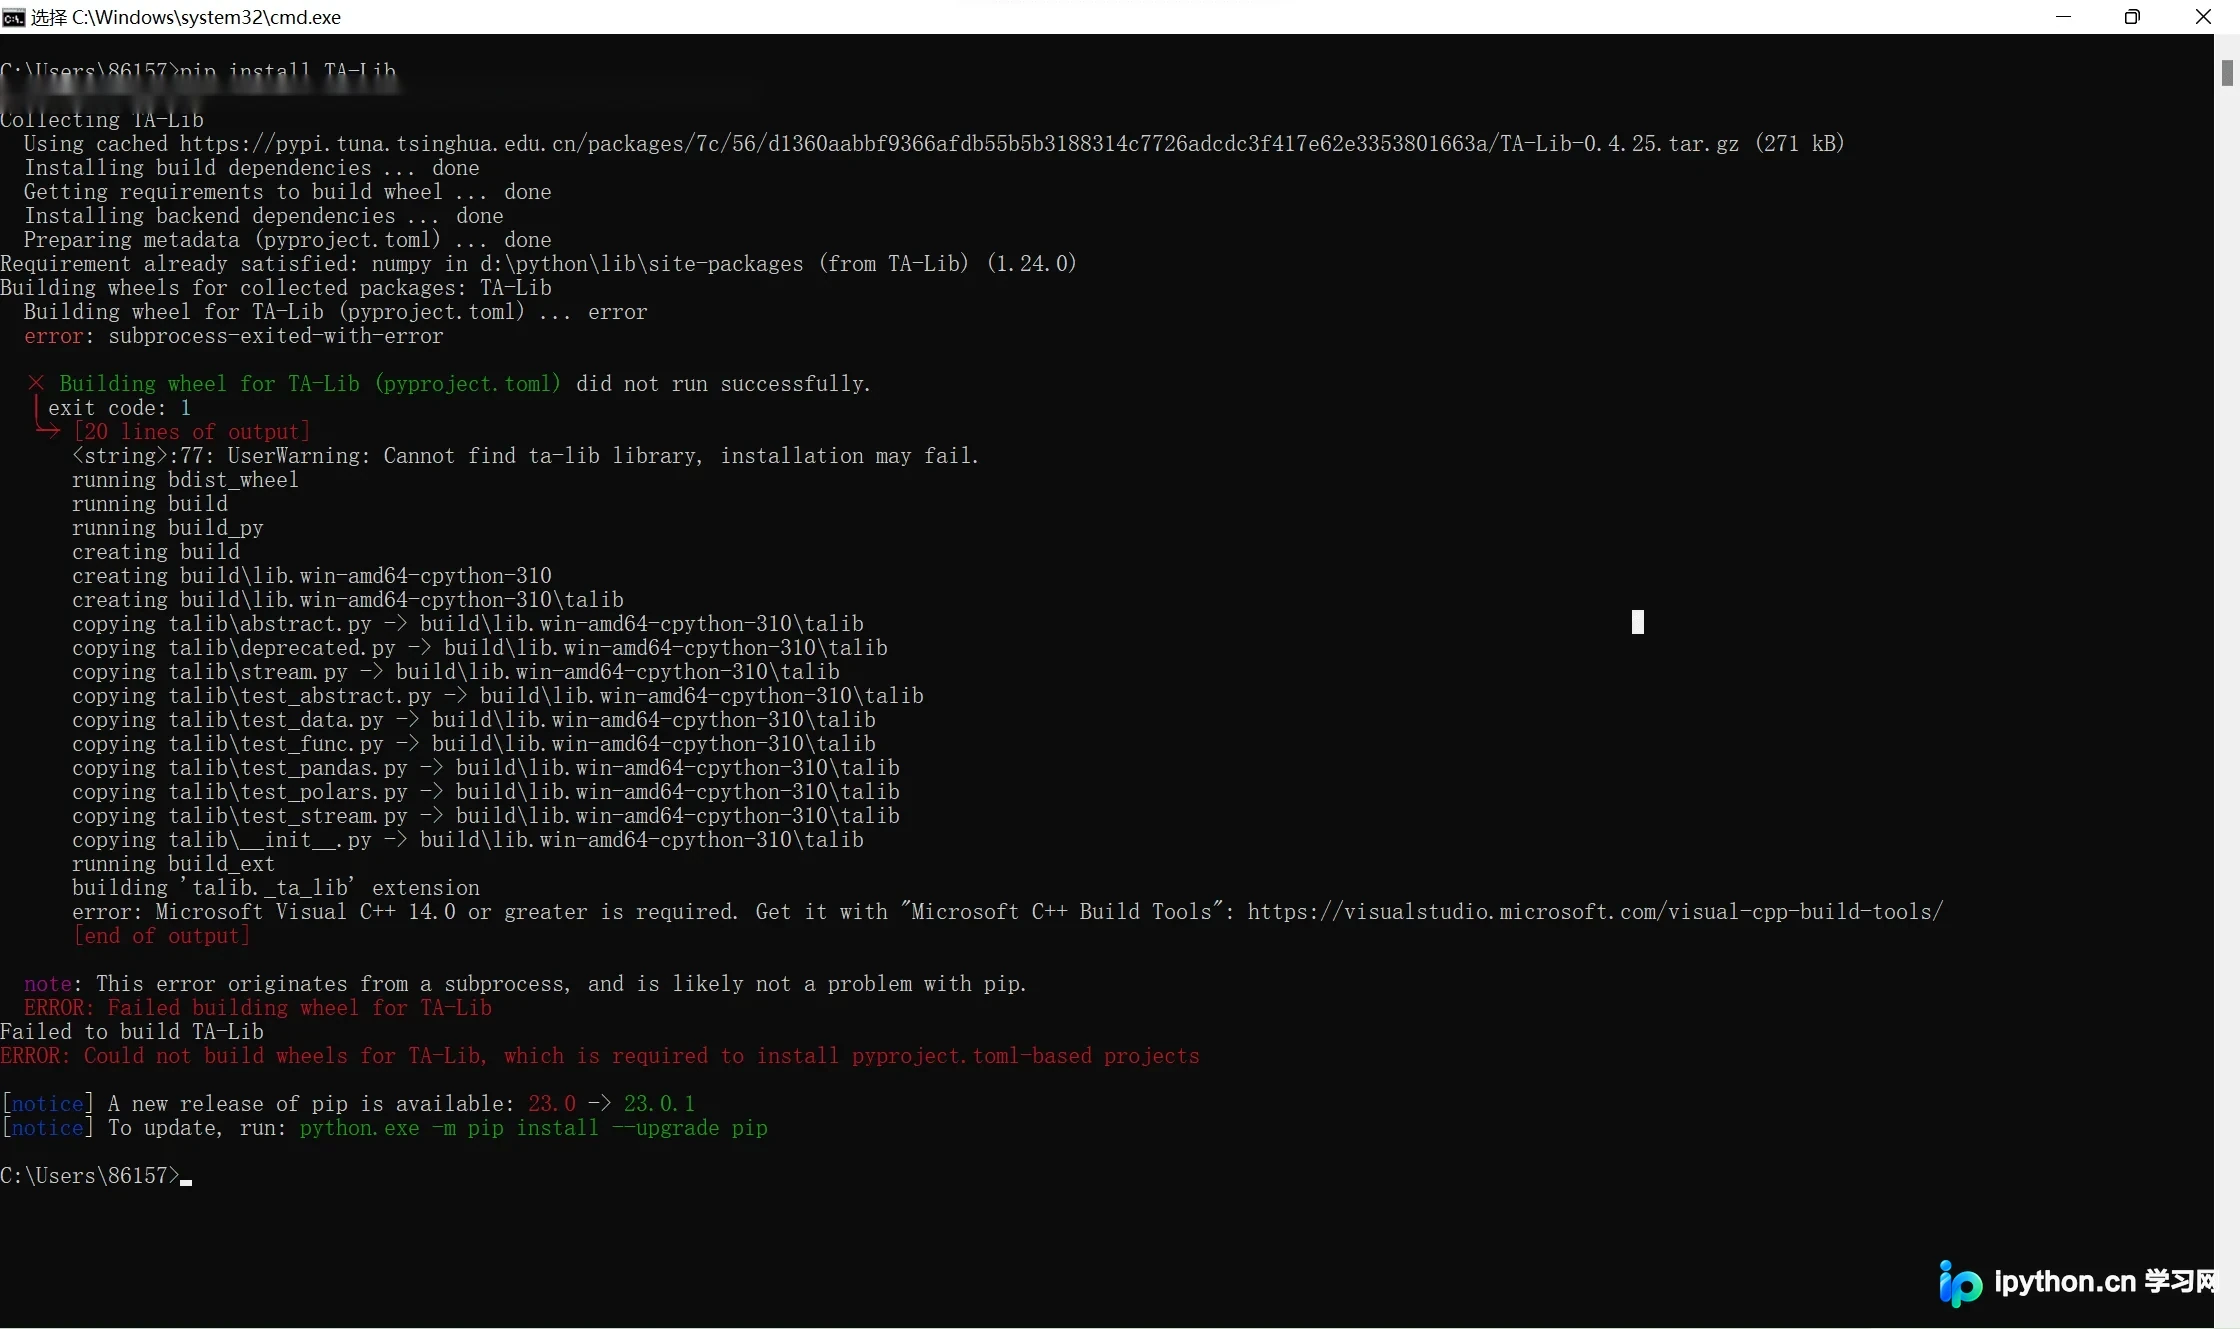
针对使用pip install TA-Lib时出现“Could not build wheels”导致安装中断的问题,本文提供基于预编译whl文件的快速解决路径。通过精准匹配Python版本与系统架构下载离线安装包,放置于Python环境的Scripts目录中执行指令,可跳过C语言底层依赖编译环节,顺利完成TA-Lib金融计算库的本地部署。
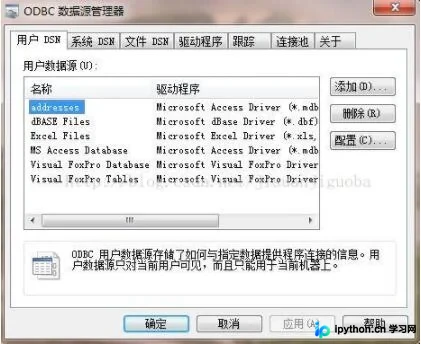
本文详细介绍如何在Python中利用pypyodbc模块连接并操作Access数据库。内容涵盖pypyodbc的安装方法、Windows系统下ODBC数据源的配置步骤,以及使用win_connect_mdb进行数据库连接、游标创建、SQL查询执行和结果遍历的完整代码示例。