

Python自动化处理PDF:合并、拆分、加密与水印添加实战
本文详解利用Python进行PDF文件自动化处理的方法。通过PyPDF2库实现PDF文件的批量合并与按页拆分,结合加密功能保护文档安全。此外,介绍使用ReportLab生成水印文件并批量添加至PDF的技术细节,提供完整代码示例与效果展示,适用于办公自动化场景。
2026-10-16
35
本文详解利用Python进行PDF文件自动化处理的方法。通过PyPDF2库实现PDF文件的批量合并与按页拆分,结合加密功能保护文档安全。此外,介绍使用ReportLab生成水印文件并批量添加至PDF的技术细节,提供完整代码示例与效果展示,适用于办公自动化场景。
本文详解Python标准库logging模块的使用方法,涵盖日志级别设置、控制台与文件输出配置,以及基于文件大小和时间的日志回滚策略。通过具体代码示例,展示如何创建Logger、Handler及Formatter,实现灵活的日志管理。
本文详细介绍如何在 Python Flask 项目中通过 Flask-SQLAlchemy 扩展连接 MySQL 数据库。内容涵盖环境安装、数据库 URI 配置、SQLAlchemy 实例化、ORM 模型定义及数据表的创建,最后演示了基本的增删改查操作,帮助开发者快速掌握 Flask 数据库集成流程。

本文详细介绍Python中功能强大的pypinyin库。涵盖基础安装、多音字识别、多种拼音风格(声调、首字母、注音等)配置,以及命令行工具使用。重点讲解如何通过register装饰器自定义拼音输出格式,利用errors参数处理特殊字符,并通过load_single_dict和load_phrases_dict定制拼音库,满足批量注音、排序及检索等复杂需求。
本文深入讲解C语言动态内存管理的三大核心操作:分配、使用和释放。详细剖析malloc、calloc和realloc函数的声明、行为差异及使用场景,重点阐述如何通过free正确释放堆内存以避免迷途指针(Dangling Pointer),并提供防止非法访问和重复释放的最佳实践代码示例。
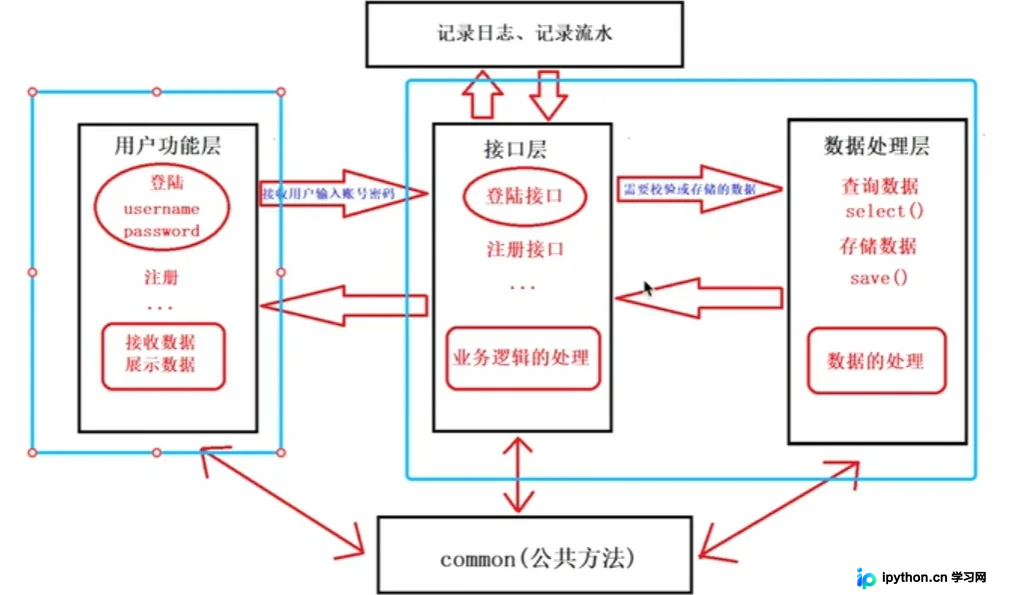
本文深入解析Python ATM取款机项目的完整架构,详细阐述用户视图层、接口层与数据处理层的职责划分。通过conf、core、interface、db等模块的代码结构分析,展示如何实现解耦合与功能扩展,为Python初学者提供清晰的工程化开发思路。
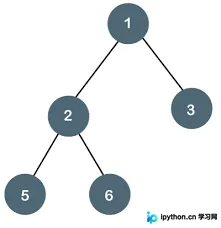
本文介绍Python3中二叉树前序遍历的迭代实现方案。通过利用栈(Stack)的LIFO特性,依次弹出节点并压入右子节点和左子节点,从而在不使用递归的情况下完成根、左、右的顺序访问。文章包含完整代码示例及详细步骤解析,适用于技术面试准备。
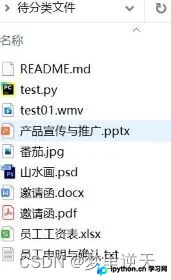
本文详细介绍如何利用Python实现计算机文件的自动化整理。内容涵盖使用os、shutil及pathlib模块进行文件自动分类与快速查找,通过filecmp模块清理重复文件,以及结合PIL和exifread模块批量转换图片格式并按拍摄日期分类。提供完整代码示例与操作步骤,帮助提升文件管理效率。
本文详细介绍Python中集合(Set)的创建、访问、增删及数学运算。涵盖使用set()或大括号创建集合,遍历获取元素,利用add()、update()添加,remove()、discard()、pop()、clear()及del删除元素。同时解析copy()、issuperset()、union()、difference()、intersection()、symmetric_difference()及isdisjoint()等方法,助力掌握集合去重与逻辑处理。
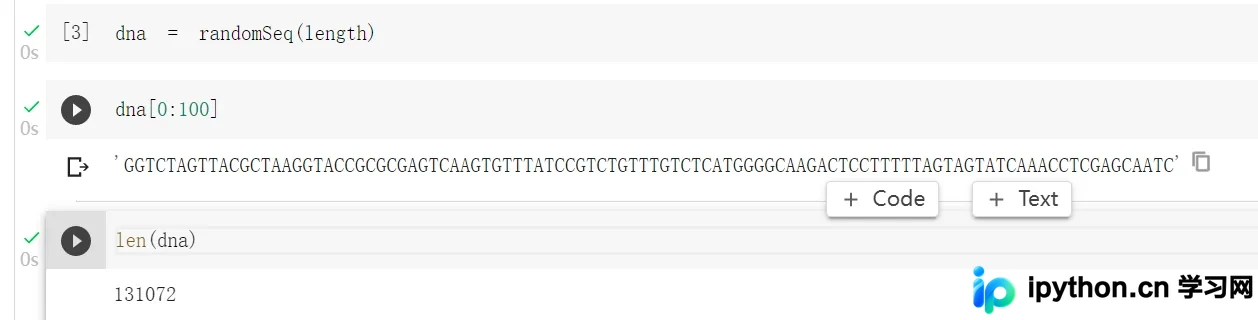
本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
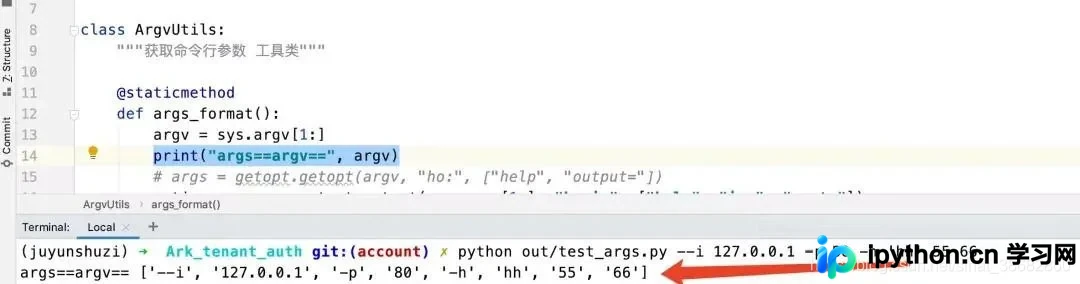
本文详细解析Python脚本中获取命令行参数的三种主流方式:sys.argv直接获取、getopt模块分组处理以及argparse标准库的高级解析。通过对比三者的功能特性、代码示例及适用场景,帮助开发者根据参数复杂度选择最合适的方案,提升脚本的可读性与兼容性。
本文系统介绍Python Num库中创建数组的七种主要方法,涵盖蛮力构造、特殊数值填充、随机分布生成、定长分割、重复扩展、网格构建及自定义数据类型。通过具体代码示例解析参数用法与内存布局,帮助开发者高效掌握NumPy数组初始化的核心技巧。