Python包循环导入解析:成因、避免策略与模块引入规范
本文深入解析Python中循环导入(Circular Import)的成因,展示A模块与B模块相互引用导致的ImportError错误。同时提供两种核心解决策略:通过分层设计降低耦合度,以及在函数内部延迟导入。此外,文章还补充了Python包的安装、模块的标准引入方式及文件级导入技巧,帮助开发者规避常见陷阱。
2026-10-15
22
本文深入解析Python中循环导入(Circular Import)的成因,展示A模块与B模块相互引用导致的ImportError错误。同时提供两种核心解决策略:通过分层设计降低耦合度,以及在函数内部延迟导入。此外,文章还补充了Python包的安装、模块的标准引入方式及文件级导入技巧,帮助开发者规避常见陷阱。
本文详细介绍如何利用Python的xlwt和xlrd库实现Excel文件的自动化读写。通过xlwt.Workbook创建文件,add_sheet添加工作表,write写入数据,save保存文件;结合xlrd读取指定行列内容,实现从源文件提取数据并生成新Excel的完整流程。
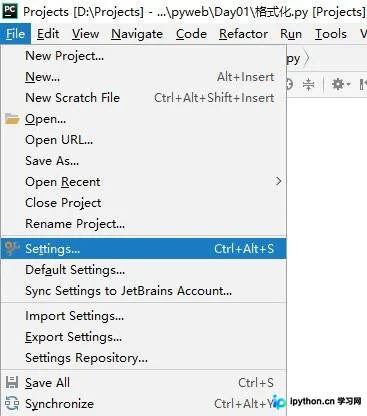
本文详细介绍在PyCharm中通过图形界面安装pandas库的步骤,以及如何在CMD命令行中使用pip安装模块。针对pip版本过旧导致的警告,文章演示了如何升级pip并解决Anaconda与独立Python环境下的pip版本冲突问题,指导用户正确使用pip或pip3命令。
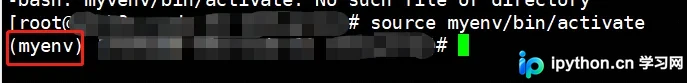
本文深入解析PyCharm新建项目时“Make available to all projects”选项的实际含义,即安装至全局site-packages。通过对比命令行与IDE操作,阐述虚拟环境在解决依赖冲突、节省空间及隔离项目中的作用,并提供从创建、激活到批量导包的完整部署流程。
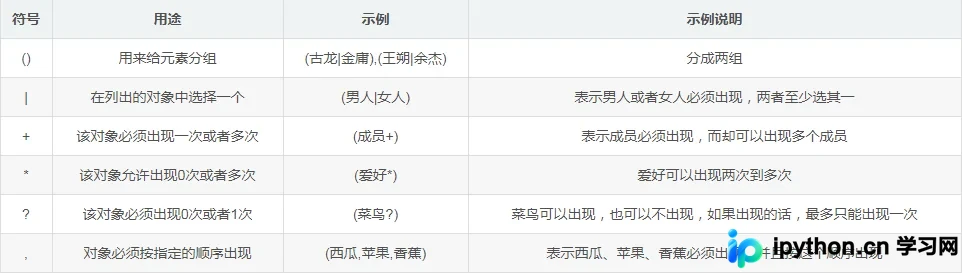
本文详细介绍在Python生成XML文件时如何正确声明和引用DTD文档。内容涵盖内部DTD与外部DTD(SYSTEM与PUBLIC)的区别、DTD基本语法如ELEMENT定义、元素组合类型修饰符以及属性类型的五种分类与特点,帮助开发者规范XML结构。
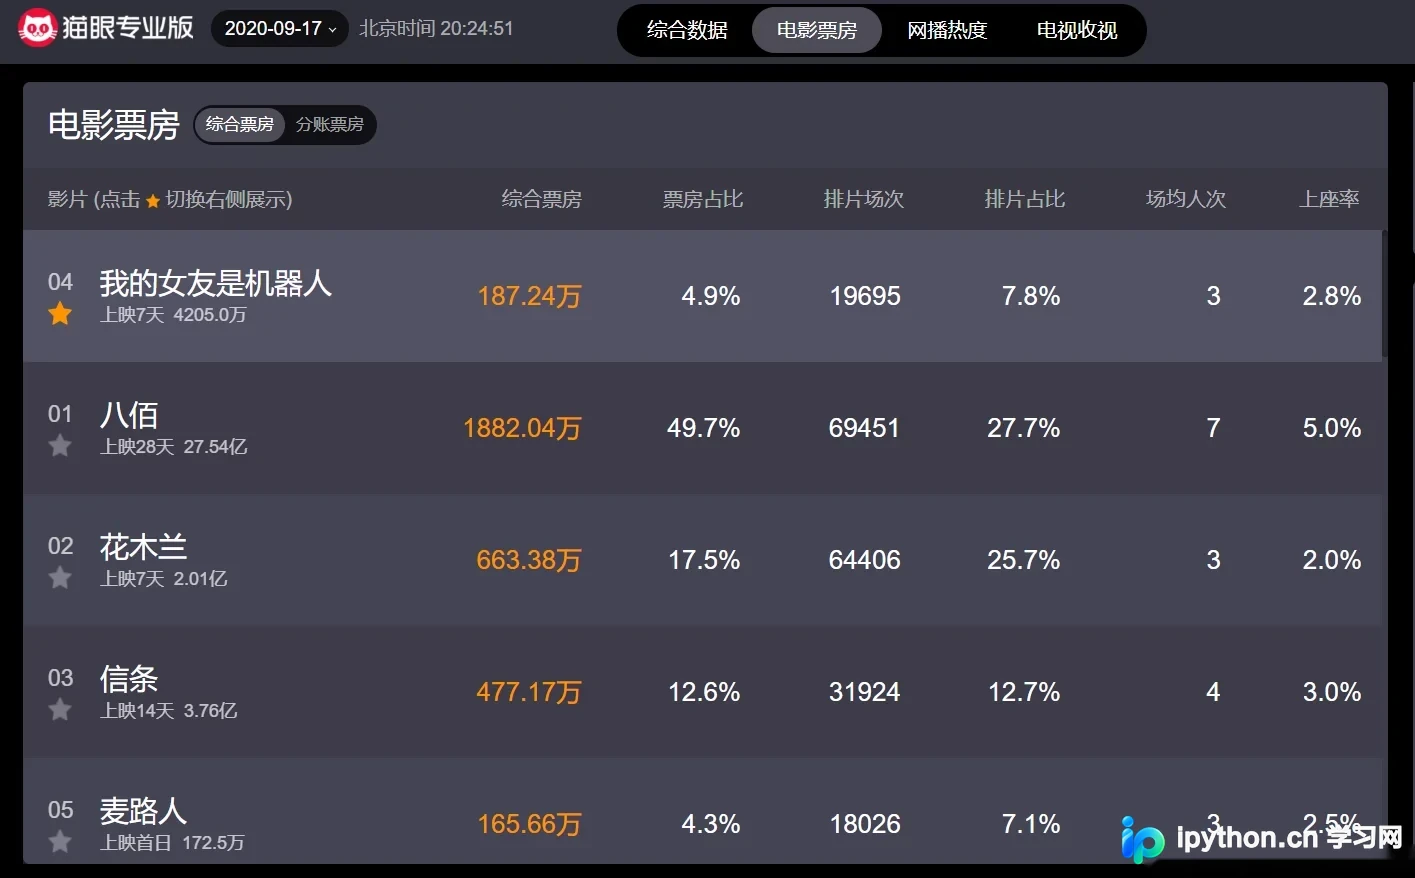
本文详细介绍如何使用Python抓取猫眼电影最近上映电影的票房信息。通过配置Python 3.6环境,利用requests模块发送HTTP请求获取JSON数据,解析电影名、票房、排片占比等关键字段,并最终将结果保存至CSV文件。适合Python初学者进行数据抓取实战练习。
本文详细介绍如何使用Python实现人工蜂群算法(Artificial Bee Swarm, ABS)进行函数优化。内容涵盖核心类ABSIndividual与ArtificialBeeSwarm的代码结构、参数配置及运行示例,并提供完整源码参考,帮助开发者快速掌握该智能优化算法的实现细节与应用方法。
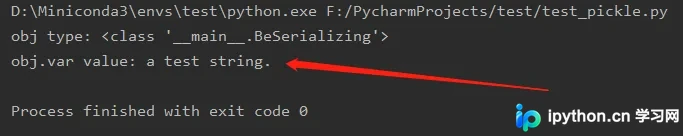
本文详解Python中pickle库的序列化与反序列化用法,通过完整代码示例展示如何将对象写入文件及从文件还原。重点探讨在特定框架无法直接获取返回值时,利用序列化机制中转数据的解决方案,帮助开发者处理复杂对象的状态保存与恢复。
本文详细介绍如何在Python中打包用户自定义模块。通过编写setup.py脚本,利用python setup.py sdist生成压缩包,并执行install命令完成安装。文章还解释了模块的概念、组织程序的优势及提升开发效率的意义,帮助开发者规范化管理代码库。
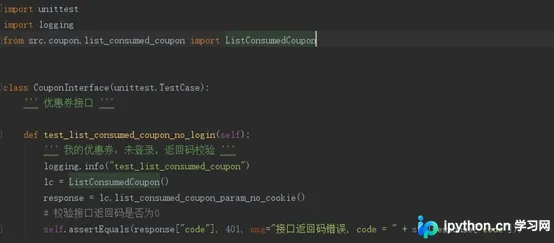
本文深入解析 Python 两大主流测试框架 unittest 与 pytest 的核心差异。unittest 作为标准库,结构严谨但语法繁琐;pytest 凭借简洁的 assert 语句、强大的 Fixture 机制及丰富的插件生态,显著提升了测试编写效率。文章通过代码示例与特性对比,帮助开发者根据项目需求选择最合适的测试工具。
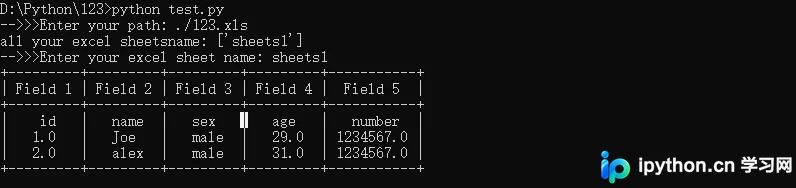
本文介绍如何在Python命令行环境中读取Excel文件的全部数据。通过结合xlrd、pandas与prettytable库,实现获取Sheet名称列表、指定Sheet页数据读取及表格化美化显示功能。代码包含完整的类封装与交互逻辑,适合需要在终端快速查看Excel内容的场景。
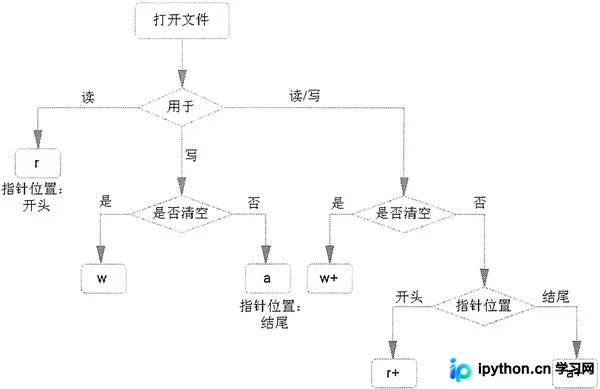
本文详细解析Python中的文件操作机制,涵盖文本与二进制文件区别、open函数参数详解、缓冲区原理,以及read/readline/readlines等读取方法。同时介绍write写入、flush刷新及文件指针管理,并演示使用os模块进行重命名、删除、目录创建等系统级操作,帮助开发者掌握完整的文件处理技能。