


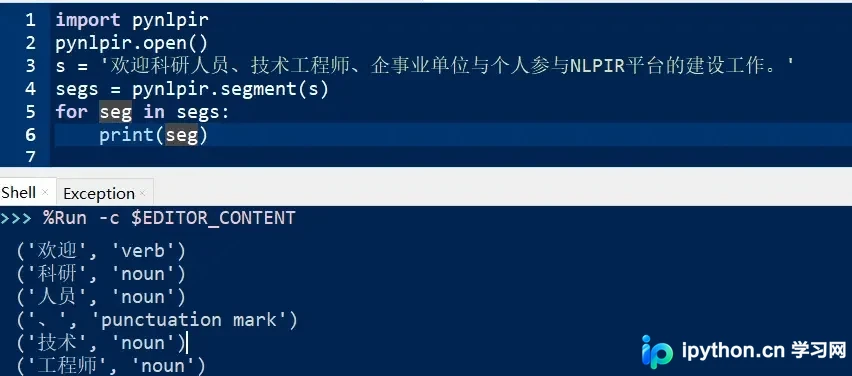
Python使用pynlpir进行中文分词并保留段落结构
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。
2026-10-11
7
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。
本文详解 Python 中 property 属性的两种实现方式:@property 装饰器与 property() 函数。通过代码示例展示如何简化属性获取、设置及删除操作,并说明两者在新式类与旧式类中的兼容性差异,帮助开发者规范类属性管理。
本文介绍在 Python 中使用 MongoDB 插入数据时,如何实现“已存在则不执行,不存在则插入”的功能。通过 MongoDB 的 update 方法结合 $setOnInsert 参数,可以有效避免重复 ID 导致的 E11000 错误。文章详细讲解了 $setOnInsert 和 $set 参数的使用方法,并通过具体示例展示了不同场景下的操作结果。
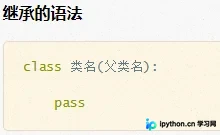
本文通过具体代码示例,详细解析 Python 中类的继承、方法重写以及 super() 函数的使用。重点演示子类如何调用父类同名方法,对比两种调用方式的区别,并指出递归调用的潜在风险,帮助开发者掌握面向对象编程的核心技巧。
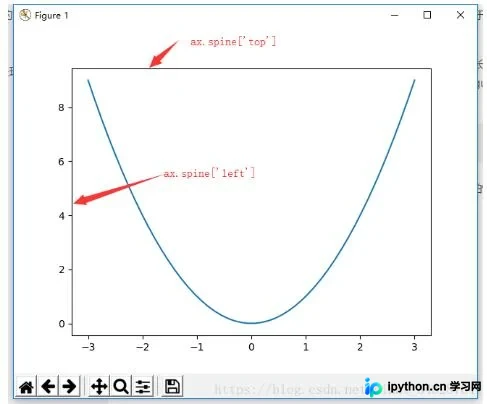
本文介绍如何使用 Python 的 Matplotlib 库自定义坐标轴。通过获取当前坐标轴对象,利用 set_color 隐藏顶部和右侧边框,使用 set_ticks_position 调整刻度位置,并通过 set_position 将坐标轴绑定到指定数据点(如原点),实现更灵活的图表展示效果。
本文介绍如何使用 Python 的 Camelot 库从 PDF 文件中高效提取表格数据。通过简单的几行代码,即可将 PDF 表格转换为 Pandas DataFrame,并支持导出为 CSV、Excel 等多种格式。文章涵盖安装方法及核心 API 使用示例,帮助开发者快速处理文档数据。
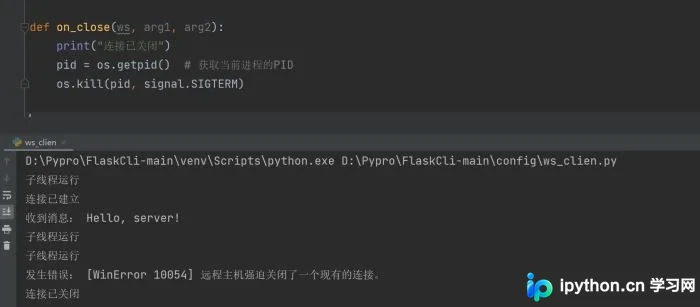
本文详解 Python 中实现程序主动退出的五种核心方法。通过 sys.exit()、raise SystemExit、os._exit()、os.kill() 及 exit() 的代码示例,对比它们在状态码返回、清理操作执行及多进程环境下的行为差异。结合 WebSocket 客户端断连实例,说明如何根据业务需求选择安全的退出策略,避免僵尸进程或资源未释放问题。
本文深入解析Python中eval函数的核心作用,即执行字符串表达式并返回结果。通过具体代码示例,展示如何利用eval实现字符串到列表、字典和元组的类型转换,并详细说明expression、globals及locals参数的用法与注意事项。
本文深入解析Pandas中的聚合与分组运算。通过groupby实现数据分组,利用内置函数(如sum、mean)进行快速统计,并掌握使用agg()执行自定义聚合逻辑。文章还演示了多函数应用、列级指定运算、结果前缀添加,以及merge与transform在数据对齐与合并中的具体操作。
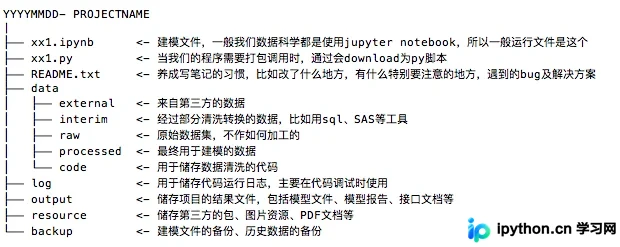
本文总结了提升Python代码质量与可维护性的8个核心建议。涵盖项目目录规范、数据备份策略、相对路径配置、进度条工具tqdm的使用,以及利用PySnooper进行调试和通过上下文管理器优化异常处理逻辑。
在Python数据处理流程中,字符串、列表与字典的频繁组合往往依赖于准确的拼接逻辑。本文针对三类核心数据结构汇总了标准实现方案,涵盖运算符组合、内置函数处理、解包合并等操作。通过明确各方法的输入要求、执行路径与返回状态,协助开发者规避类型报错,快速完成数据清洗与重组。
本文介绍如何使用Python脚本自动检测并终止MySQL数据库中的慢查询会话。通过pymysql连接数据库,利用information_schema.processlist筛选耗时超过阈值的会话,并结合schedule库实现定时任务调度,自动执行kill命令释放资源。