

Python爬虫代理池元类实现与测试解析
本文深入解析Python3 WebSpider爬虫代理池的源代码测试过程。重点介绍如何利用元类(Metaclass)自动注册抓取函数,通过约定前缀动态生成属性列表,实现抓取逻辑的解耦与扩展。文章包含详细的代码示例及控制台输出日志,展示代理获取器的执行流程与测试结果,为构建可扩展的爬虫系统提供参考。
2026-10-13
12
本文深入解析Python3 WebSpider爬虫代理池的源代码测试过程。重点介绍如何利用元类(Metaclass)自动注册抓取函数,通过约定前缀动态生成属性列表,实现抓取逻辑的解耦与扩展。文章包含详细的代码示例及控制台输出日志,展示代理获取器的执行流程与测试结果,为构建可扩展的爬虫系统提供参考。
本文介绍如何使用Python的win32com库启动Microsoft Office及WPS办公软件进程。通过Dispatch方法创建应用程序对象,设置可见性后执行退出操作。代码涵盖了Word、Excel、PowerPoint以及WPS的文字、表格和演示组件的启动与关闭逻辑,适用于需要后台控制或快速测试办公应用环境的场景。
本文深入解析Python中数组、链表、队列及栈的底层实现原理。通过自定义类模拟数组行为,详细阐述单向链表、双向循环链表的节点构建与指针操作。重点讲解基于数组的环形队列与基于双向链表的双向队列、栈的实现逻辑,涵盖入队、出队、压栈、弹栈等核心操作,提供完整代码示例与使用场景说明。
本文介绍在 Python 中如何获取命令行传入的参数内容及其总个数。通过导入 sys 模块,利用 sys.argv 列表存储所有参数,并使用 len(sys.argv) 计算参数数量。文章提供了完整的示例代码及在 Spyder IPython 环境中执行的具体操作步骤,帮助开发者快速掌握相关技巧。
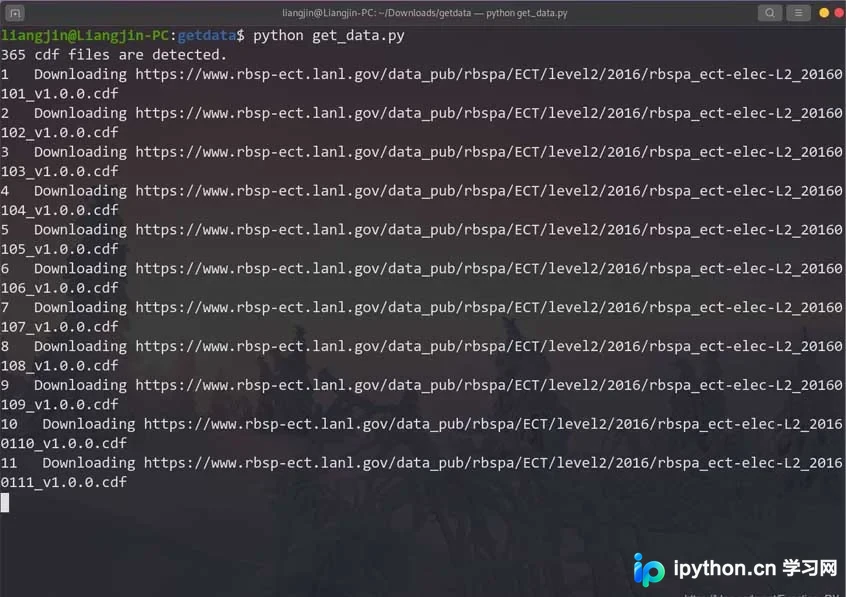
本文介绍使用Python3编写脚本,从RBSP ECT Level2数据目录批量下载CDF文件的方法。通过解析网页HTML获取文件名列表,利用requests库将文件保存至本地指定路径。文章包含完整代码示例、参数配置说明及运行效果展示,适用于空间物理研究人员快速获取卫星观测数据。
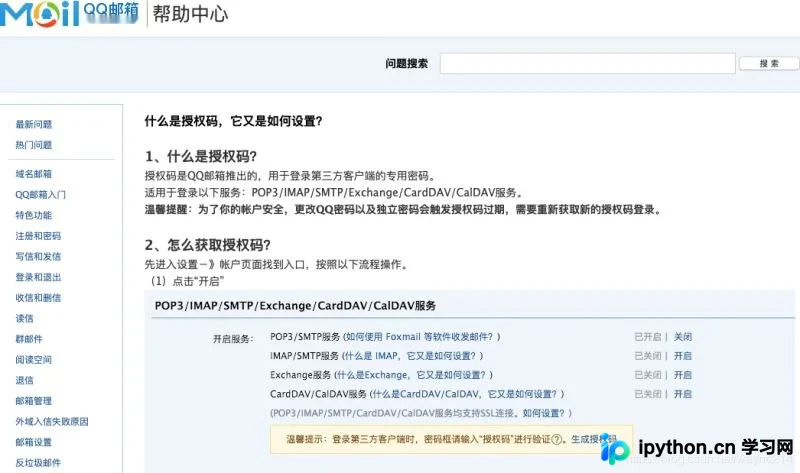
本文详解Python使用smtplib库通过QQ邮箱发送邮件时遇到的535认证错误。该问题源于QQ邮箱安全策略要求使用授权码而非登录密码。文章提供了从生成授权码到修改代码的完整操作步骤,帮助开发者解决第三方客户端登录失败的问题,确保邮件正常发送。
本文介绍如何使用Python标准库sys模块中的getrefcount()函数来统计对象的引用个数。通过Dog类实例演示,该方法返回的计数值通常比实际变量引用多1,因为函数调用本身会创建临时引用。文章提供了完整代码示例及结果分析,帮助开发者理解Python的引用计数机制。
本文详细解析Python中类之间的参数传递机制,涵盖继承类中__init__的调用顺序、类方法直接调用与实例化调用的区别,以及多余参数处理。通过具体代码示例说明如何正确传递参数并避免常见错误,帮助开发者理解类间交互逻辑。
本文详解如何在Python中使用sys.argv接收命令行参数,并解决PyInstaller打包exe后参数传递失效的问题。重点对比-F与-w模式对标准输出的影响,提供通过os.popen调用exe并获取输出的完整代码示例,确保打包后的程序能正确接收和处理外部传入的参数。
本文详细整理了Python中获取网络图片的几种常用方法,包括使用urllib库直接下载、通过Request添加请求头模拟浏览器访问,以及利用requests库进行流式或分块下载。此外,还展示了如何结合正则表达式从网页源码中提取图片链接并保存。文中提供了完整的示例代码,涵盖文件读写、目录创建及异常处理,适合需要批量获取或整理网络图片资源的开发者参考。
本文详解Python中四种主流数据持久化方式:JSON、Pickle、Shelve及DBM。通过具体代码示例,演示如何使用json、pickle、shelve和dbm模块进行数据的序列化与反序列化操作,涵盖字典、列表及自定义类的处理,并对比各模块在数据类型支持、文件读写模式及适用场景上的差异,帮助开发者根据需求选择合适的数据存储方案。

本文详细介绍如何利用setup.py将Python框架打包为第三方模块。涵盖setup.py模板编写、requirements.txt依赖管理、VERSION.txt版本控制及最终安装命令执行。通过具体示例演示如何配置模块元数据、处理packaging依赖及解决常见报错,帮助开发者规范发布Python项目。