

Python数据持久化实战:JSON、Pickle、Shelve与DBM详解

本文详解Python中四种主流数据持久化方式:JSON、Pickle、Shelve及DBM。通过具体代码示例,演示如何使用json、pickle、shelve和dbm模块进行数据的序列化与反序列化操作,涵盖字典、列表及自定义类的处理,并对比各模块在数据类型支持、文件读写模式及适用场景上的差异,帮助开发者根据需求选择合适的数据存储方案。
Python数据持久化概述
本文通过具体实例深入解析Python中的序列化技术与数据持久化方法,旨在为读者提供实用的参考指南。
在Python中实现数据持久化,主要存在以下几种常见途径:
第一种是普通文件的无格式写入,即将数据直接以原始形式保存至文件。
第二种采用标准序列化格式,例如使用JSON或Pickle进行数据转换与存储。
第三种则是基于DBM接口的持久化方式,常用模块包括shelve和dbm。
以下将分别介绍上述几种核心技术的具体实现细节:
- JSON序列化
- Pickle序列化
- Shelve数据库
- DBM接口
JSON序列化与反序列化
关于JSON模块:
其核心原理是:
按照预定义的格式(如字典结构)将数据以明文形式写入文件。若涉及非ASCII字符(如中文),JSON会将其转换为Unicode编码格式,最终存储为bytes类型。

具体使用步骤如下:
- 第一步,导入必要的模块
import json。 - 序列化过程:
- 使用json.dump(序列化对象,文件对象)直接写入文件。
- 使用json.dumps(序列化对象),该方法返回一个字符串,需手动将该字符串写入文件。
print("------json序列化--------")
import json
import time
info={
  'date':time.localtime(),
  'name':'中文'
}
f=open("test.txt","w")
print("---------dump---------")
# json.dump(info,f)
# f.close()
print("---------dumps,---------")
f.write(json.dumps(info))
f.close()- 反序列化过程:
- 读取数据时,使用json.load(文件对象)进行反序列化。
- 若需从字符串恢复数据,使用json.loads(字符串)。
print("------反序列化--------")
import json
f=open("test.txt","r")
print("-------load----------")
# data=json.load(f)#1
# print(data)
print("-------loads----------")
d2=json.loads(f.read())
print(d2)
f.close()
针对多次调用dump或dumps导致的数据混合问题,如何正确load或loads提取数据?
- 关键在于写入时需手动对数据进行分隔处理。
print("------json序列化--------")
import json
import time
info={
  'date':time.localtime(),
  'name':'中文'
  # 'func':hello #注:json不可序列化函数
}
info2=['1',2,3,4]
f=open("test.txt","w")
print("---------dumps,---------")#用'\n'来区分两份数据
f.write(json.dumps(info)+"\n")
f.write(json.dumps(info2)+"\n")
f.close()
import json
with open("test.txt") as f:
  a=json.loads(f.readline())
  b=json.loads(f.readline())
  print(a,b)
Pickle二进制序列化
关于Pickle模块:
其设计初衷是:
- 实现Python内部数据类型与特定二进制格式之间的相互转换。
- 参数protocol用于指定序列化协议版本。默认情况下,Pickle序列化产生的数据为bytes类型,因此打开文件时必须指定为二进制模式。
具体使用步骤如下:
- 首先导入模块import pickle。
- 序列化过程:
- 使用pickle.dump(序列化对象,文件对象)进行持久化。
- 使用pickle.dumps(序列化对象),返回值同样为字符串(实际为bytes),需手动写入文件。
import pickle
info={
  'name':'1',
  'age':2,
}
f=open("test2.txt","wb")
pickle.dump(info,f)#序列化方法1
# f.write(pickle.dumps(info))#序列化方法2
f.close()
- 反序列化过程:
- 读取数据时,使用pickle.load(文件对象)。
- 若需从字节串恢复数据,使用pickle.loads(字符串)。
print("------反序列化--------")
import pickle
f=open("test2.txt","rb")
data=pickle.loads(f.read())#反序列方法1
print(data)
# data=pickle.load(f)#反序列方法2
# print(data)
f.close()
Shelve字典式持久化
关于Shelve模块:
其定位是:
- 专门用于将Python数据类型持久化至磁盘,其操作逻辑类似于字典(dict)。
具体使用步骤如下:
- 首先导入模块import shelve。
- 打开持久化文件:shelve文件对象 = shelve.open(文件名)。
- 写入数据:shelve文件对象[key]=value。
- 读取数据:shelve文件对象.get(key)。
import shelve,time
d = shelve.open('shelve_test') # 打开一个文件
print("----------写----------")
info ={"name":'lilei',"sex":"man"}
name = ["autuman", "zhangsan", "lisi"]
d["teacher"] = name
d["student"] = info
d["date"] = time.ctime()
print("--------读------------")
print(d.get("teacher"))
print(d.get("student"))
print(d.get("date"))
d.close()
Shelve的一个显著优势是能够方便地序列化自定义数据类型及函数。
import shelve,time
class A:
  def hello(self):
    print("123")
d = shelve.open('shelve_test') # 打开一个文件
print("----------写----------")
d['class'] =A
print("--------读------------")
a=d.get('class')()
a.hello()
d.close()
DBM字符串键值存储
关于DBM模块:
其特点在于:
- DBM与Shelve机制相似,但限制键和值必须为字符串类型。
- 默认写入的数据为bytes类型,所有字符串均会被序列化为bytes。
具体使用步骤如下:
- 首先导入模块imort dbm(注意:存在多种DBM实现,此处选用默认实现)。
- 打开文件:dbm对象=dbm.open(文件名,打开模式)。
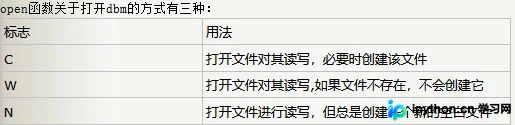
- 写入数据:dbm对象[key]=value。
- 读取数据:dbm对象[key]。
import dbm
db=dbm.open("test.txt","c")
print("写".center(50,'-'))
db["name"]="1111111111112"
db["name2"]="2222222222222"
print("读".center(50,'-'))
print(db["name"])
print(db["name2"])
db.close()
若需了解更多Python相关技巧,可查阅本站专题:《Python操作json技巧总结》、《Python编码操作技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》。
希望本文所述内容能对您的Python程序设计工作有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









