

MySQL 备份恢复与主从同步操作指南
详解 MySQL 的完整备份与基于时间点的数据恢复流程,包括 SQL 文件导入、全量备份逻辑以及 XtraBackup 物理备份。介绍范围、哈希、时间分区及数据归档策略。深入解析主从复制原理,提供从服务器授权到 my.cnf 配置文件修改及状态检查的标准步骤,实现读写分离基础架构。
2026-10-15
6
详解 MySQL 的完整备份与基于时间点的数据恢复流程,包括 SQL 文件导入、全量备份逻辑以及 XtraBackup 物理备份。介绍范围、哈希、时间分区及数据归档策略。深入解析主从复制原理,提供从服务器授权到 my.cnf 配置文件修改及状态检查的标准步骤,实现读写分离基础架构。
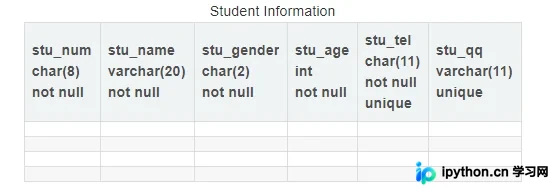
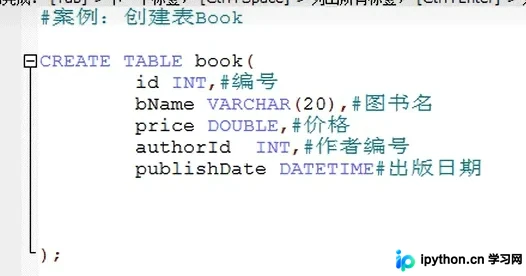
本文详细介绍MySQL数据库中基于DDL(数据定义语言)的数据表操作方法。涵盖从选择数据库到创建表的完整语法,包括字段类型、约束条件设置;讲解如何查询当前库中所有表及查看特定表结构;同时说明安全删除数据表的命令,以及利用ALTER TABLE实现表名重命名、字符集调整、字段增删改等常见维护任务。
在MySQL中直接解析包含多个对象的JSON数组字符串较困难。本文介绍通过SUBSTRING_INDEX函数配合自增ID表(或help_topic),将JSON数组拆分为独立行,再利用JSON_EXTRACT提取具体字段的方法。该方法无需自定义存储过程,适用于单行文本批量解析场景。
本文通过SQL脚本实测对比MySQL中使用存储过程While循环插入数据时,开启手动事务提交(SET AUTOCOMMIT = 0)与默认自动提交的性能差异。结果显示,批量提交100万条数据仅需约32秒,而单个自动提交处理1万条数据耗时超1分钟。验证了在大批量数据写入场景下,关闭自动提交能显著降低I/O开销,提升执行效率。
本文详细讲解MySQL中数据库和表的基本管理操作,包括创建、修改和删除数据库及表的语法。重点介绍了列名变更、类型修改、添加或删除列、表重命名等关键步骤。同时阐述视图的概念、作用及创建方法,帮助开发者简化复杂查询并提高数据管理的规范性与效率。
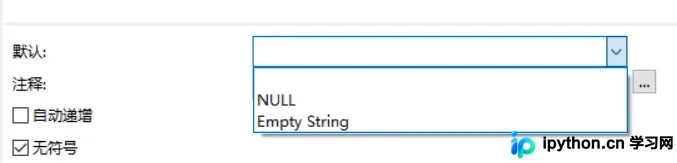
本文详解如何在MySQL中使用ALTER TABLE修改字段的默认值(SET/DROP DEFAULT)和空值约束(MODIFY NULL/NOT NULL)。深入剖析NULL、空值与Empty String在存储占用、索引影响及查询逻辑上的核心差异,并提供移动端开发避坑的最佳实践建议。
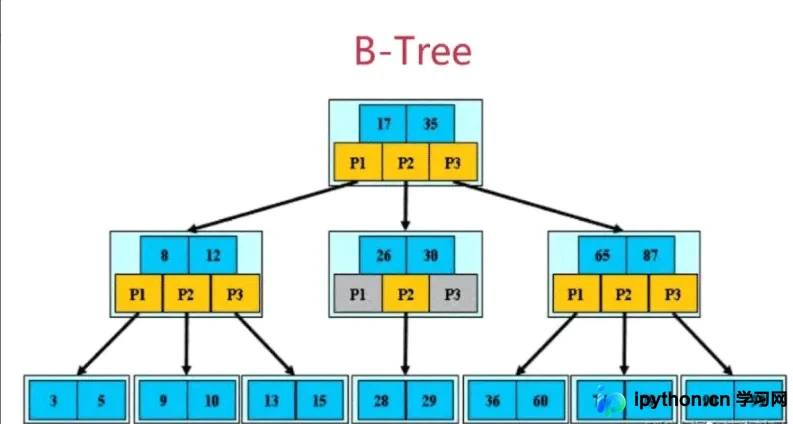
文章深入剖析 MySQL 中 B-Tree 与 B+Tree 两种核心索引数据结构的原理与差异。从减少磁盘 I/O 的角度出发,解释了为何二叉树会演变为多叉树,并详细对比了两者在节点数据存储、查询稳定性及范围扫描效率上的不同。结论指出 B+Tree 因内部节点仅存储索引且叶子节点链表连接,更适合关系型数据库的索引实现。
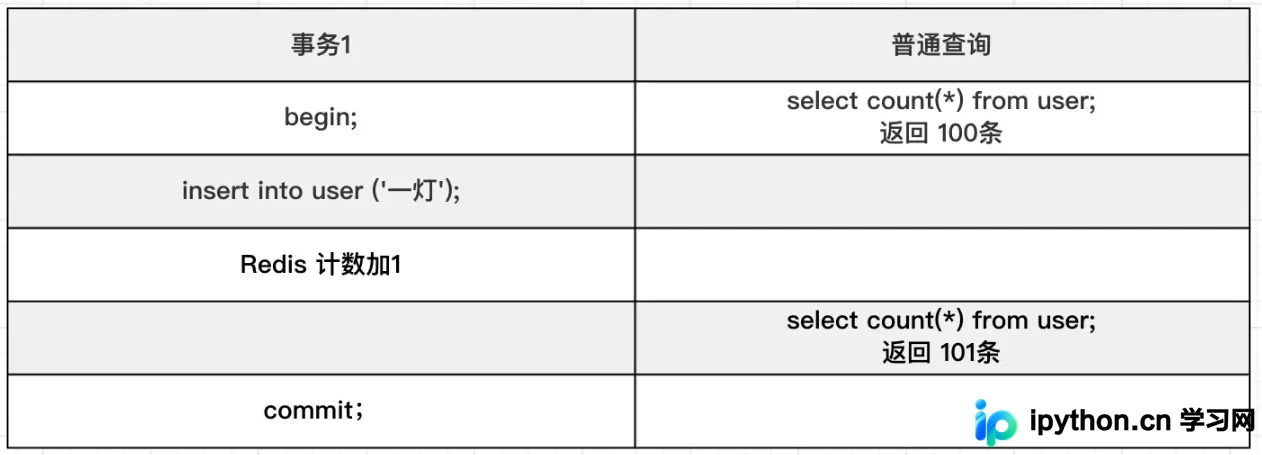
针对MySQL InnoDB引擎下count(*)统计耗时过长的问题,分析MyISAM与InnoDB的行数记录机制差异。介绍使用show table status估算行数的快速方案,对比count(*)、count(id)及count(字段)的性能差异,并指出Redis等缓存方案在处理高并发事务时的局限性,提供实用的查询优化建议。
本文详细讲解MySQL基础数据查询操作及常用运算符。涵盖 SELECT 语句的列选择、别名设置、去重及表达式运算;深入解析 WHERE 条件过滤,包括比较运算符、范围 BETWEEN、集合 IN 及通配符 LIKE 的使用;同时说明 NULL 值的特殊处理逻辑以及 least 和 greatest 等聚合函数的应用方法与注意事项。
本文深入解析 MySQL EXPLAIN 命令的核心字段。通过 type 字段(从全表扫描到 const)判断访问效率,利用 key 识别实际使用的索引,并结合 extra 中的 Using index、Using filesort 等状态码定位慢查询根因。掌握这些指标可精准调整 SQL 语句,提升数据库执行效率。
深入解析 MySQL InnoDB 存储引擎的两种核心日志:Redo Log 用于保证事务原子性与崩溃恢复,Binlog 用于归档复制。两者通过两阶段提交机制保持一致,确保数据高可用。文章详细介绍其工作流程、循环写入特性及关键配置参数如 innodb_flush_log_at_trx_commit 和 sync_binlog,为数据库稳定性提供理论支撑。
本文详细解析MySQL中Locate函数的用途,包括判断子串存在性及返回首次出现位置。通过具体SQL示例展示其在普通查询和MyBatis中的用法,并对比Instr、Like等实现模糊查询的方法,帮助开发者选择高效的数据检索方案。